O ajuste fino completo deixou de ser uma opção razoável
Os modelos fundamentais para eletroencefalografia são treinados sem rótulos — em tarefas contrastivas ou na reconstrução de fragmentos mascarados do sinal. A lógica é a seguinte: o modelo absorve padrões gerais de ritmos, artefatos e transições entre estados, e depois é ajustado para uma tarefa específica, como a detecção de descargas epilépticas. Em teoria, isso produz representações que se transferem entre clínicas e equipamentos. Na prática, é mais complicado: os arquivos clínicos de registros são muito diferentes entre si, e a qualidade da transferência cai de forma perceptível.
O segundo problema é a economia. O ajuste fino clássico atualiza todos os pesos e, portanto, exige recursos computacionais consideráveis para cada nova tarefa. Em um departamento sem cluster de GPU, esse cenário simplesmente não sai do papel. Daí a pergunta em torno da qual o trabalho arXiv:2608.24727 foi construído: é possível trabalhar com uma fração pequena dos parâmetros sem perder qualidade?
Nove por cento: o que exatamente é ajustado
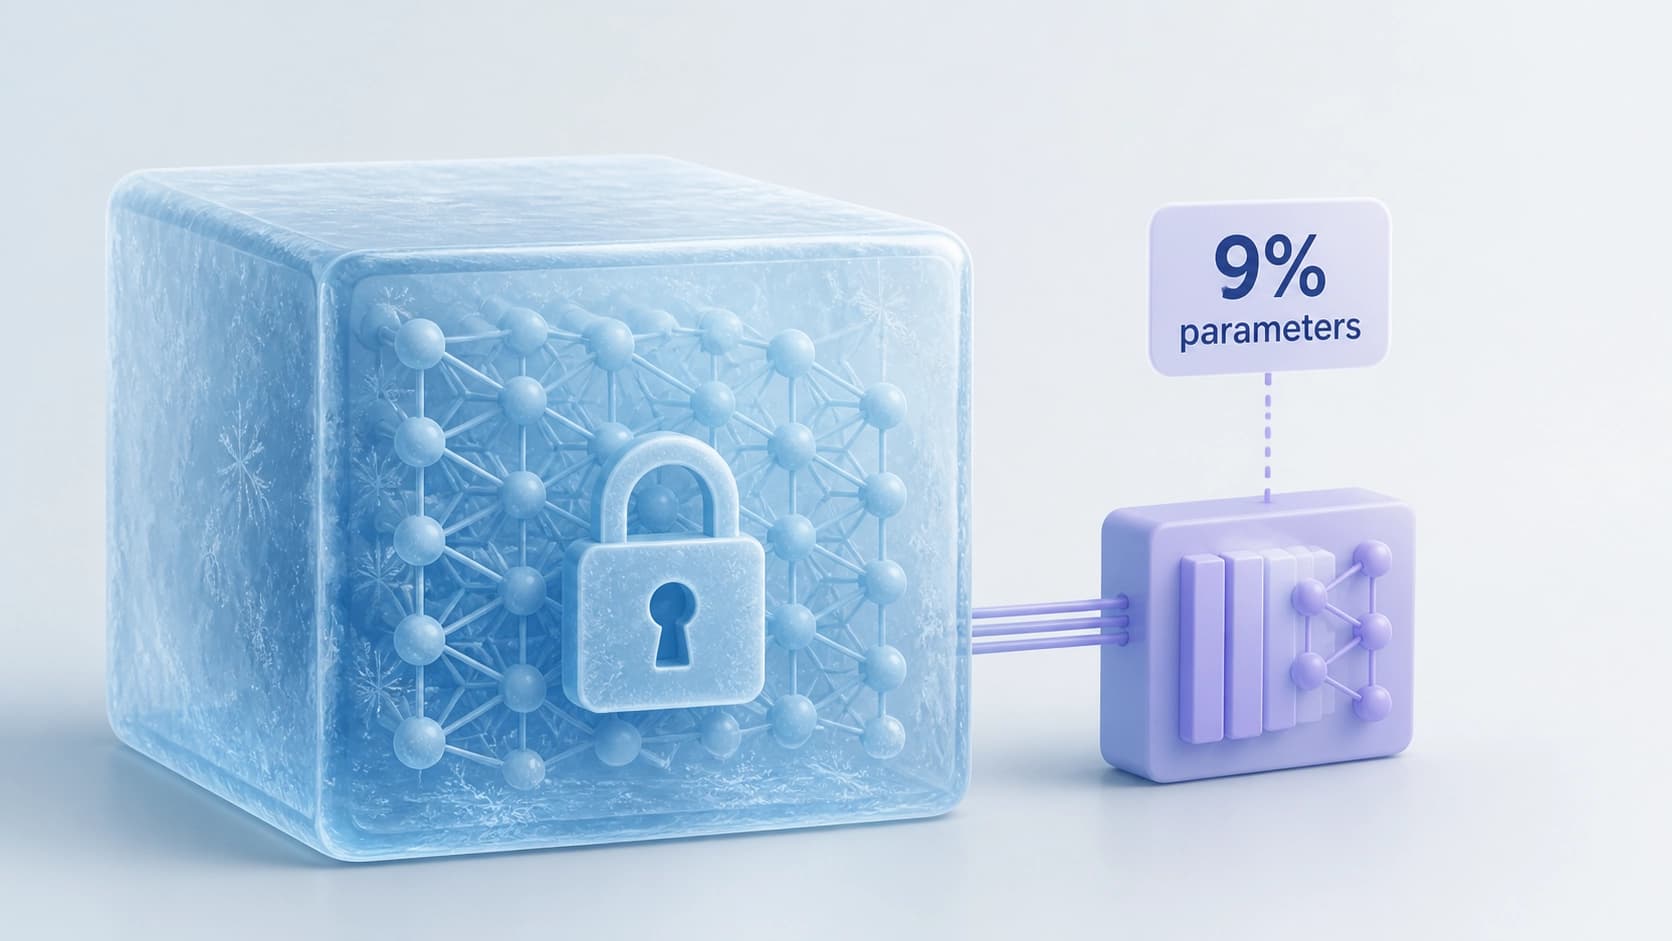
Os autores do preprint são Meghal Dani e Stefanie Liebe. Eles testam um regime em que cerca de 9% dos pesos permanecem treináveis, enquanto o restante do modelo fica congelado. A adaptação ocorre de forma auto-supervisionada: o modelo não é apenas ajustado aos rótulos da classe, mas alinha suas representações internas à tarefa-alvo. O texto foi publicado em 25 de agosto de 2026 (versão v1), classificado nas seções cs.LG e cs.AI, com DOI 10.48550/arXiv.2608.24727. O código está aberto para reprodução.
O ponto não é que se tenha obtido um modelo "reduzido". Trata-se de outro modo de operação: o codificador pré-treinado pesado permanece inalterado, e para cada nova tarefa ajusta-se um complemento compacto. Para a clínica, essa separação é fundamental — o pré-treinamento caro é feito uma vez, e a adaptação barata se repete quantas vezes forem necessárias.
Dois modelos com objetivos de pré-treinamento diferentes
Para que o resultado não dependa de uma única arquitetura bem-sucedida, o experimento envolve dois modelos SOTA: o BIOT, com objetivo contrastivo, e o CBraMod, treinado para reconstruir trechos mascarados. Se a abordagem funciona nos dois casos, não se trata de coincidência, mas de uma propriedade da abordagem.
Três conjuntos clínicos e dois modos de avaliação
A avaliação é feita em TUAB (detecção de anomalias), TUEV (classificação de eventos) e CHB-MIT (detecção de crises). As medições são feitas duas vezes — in-distribution e out-of-distribution, ou seja, testa-se não apenas com os dados "próprios", mas também com distribuição deslocada.
O que os resultados mostraram
- Em comparação com a sondagem linear, a adaptação auto-supervisionada proporciona um ganho consistente — de até 20 vezes em AUCPR. Não é "um pouco melhor", mas uma diferença de ordem de magnitude, e ela é especialmente notável onde a classe rara importa mais do que a acurácia geral.
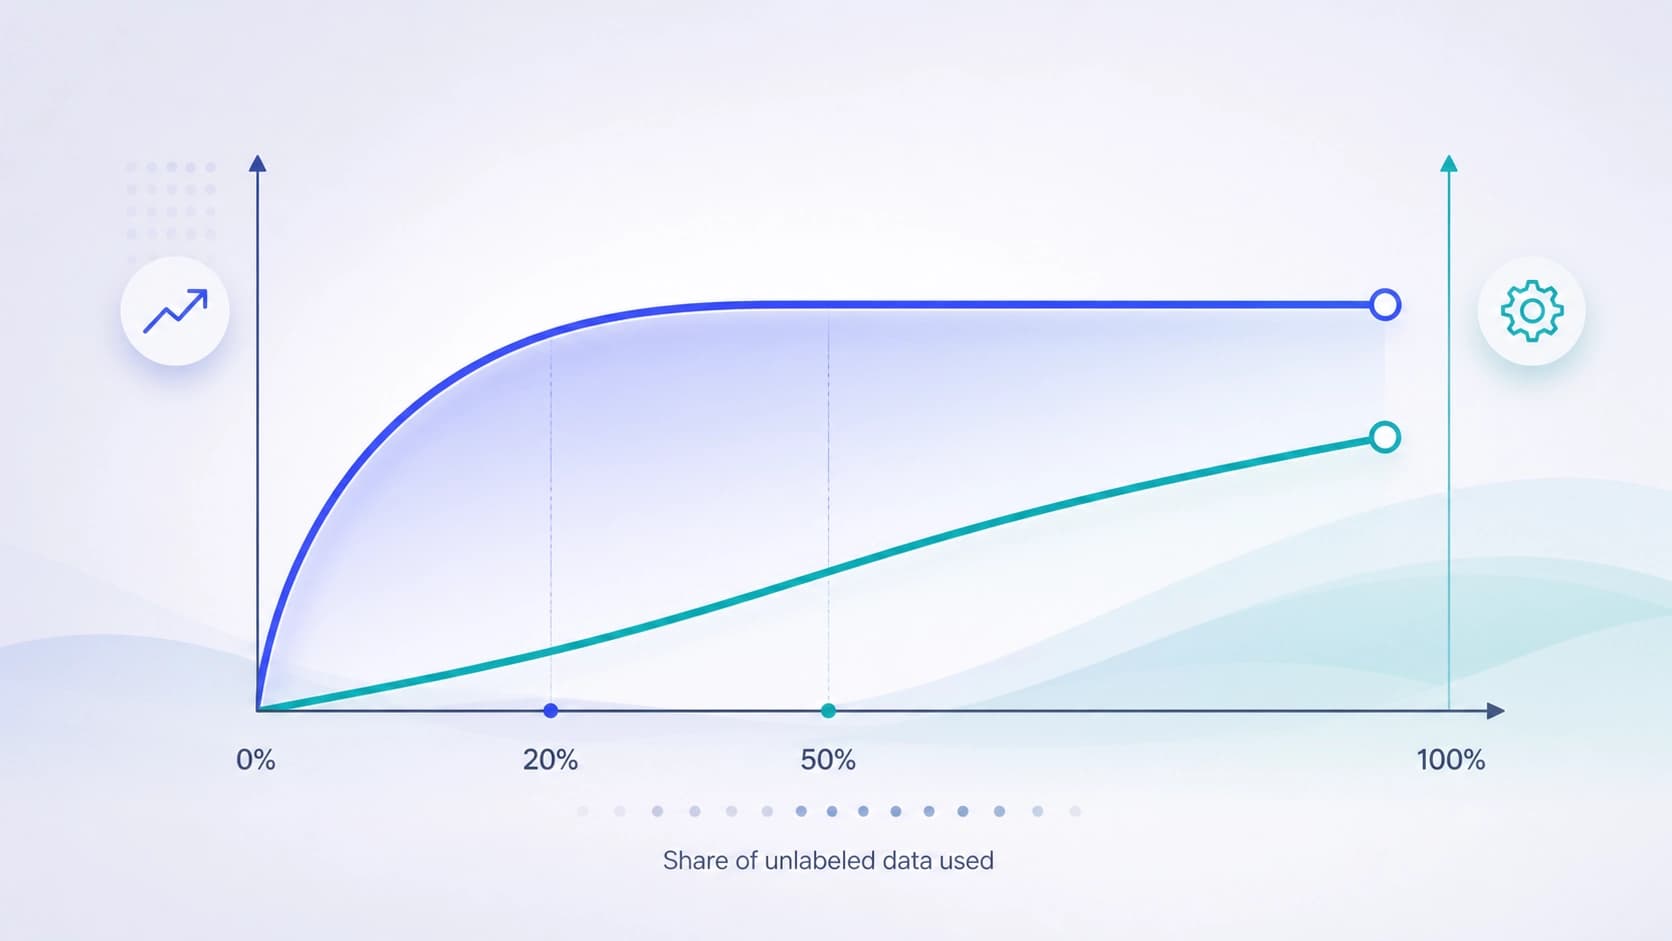
- Com um orçamento computacional fixo, o pico é atingido com apenas 20–50% dos registros não rotulados disponíveis. O restante do corpus já não acrescenta ganho.
- Se o número total de janelas de sinal for fixado, o resultado não depende de quantos pacientes foram incluídos. Isso significa que o que funciona não é a "unicidade das pessoas", mas a diversidade temporal dos fragmentos: diferentes estados, modos e artefatos dentro do registro.
O último ponto inverte a lógica habitual de coleta de dados. Intuitivamente, parece que quanto mais pacientes diferentes, mais confiável. Aqui, porém, conclui-se que, com um limite rígido no número de janelas, é possível reunir dados de menos pessoas — basta acompanhar a diversidade do sinal delas ao longo do tempo.
Por que isso muda o cenário para a clínica
Até agora, a adoção de modelos fundamentais de EEG esbarrava não na qualidade das representações, mas no orçamento: para obter benefício do modelo, era preciso poder arcar com um ajuste fino completo e um grande corpus rotulado. O trabalho mostra que essa barreira pode ser reduzida por dois lados ao mesmo tempo — em computação e em dados. Nove por cento dos pesos e metade do arquivo não rotulado, em vez de cem por cento e do volume total.
Para o hospital, isso significa um cenário mais realista: o modelo é pré-treinado de forma centralizada, e no local, para uma tarefa específica, é ajustado em equipamento modesto. Menos dependência de quem reuniu mais registros, e menos custo de armazenamento e processamento de horas de sinal desnecessárias.
O que vale ter em mente
Não se deve ler o resultado como "nove por cento sempre bastam". Trata-se de um regime específico de um experimento específico, e não de uma receita universal para qualquer arquitetura e qualquer conjunto de dados. Os próprios autores ressalvam: a generalização de modelos de EEG continua limitada, especialmente em corpora clínicos heterogêneos. A adaptação com eficiência de parâmetros não elimina o problema da transferência — apenas reduz o custo de entrada nela.
A conclusão prática é mais simples do que parece: a discussão sai do plano "vale a pena sequer lidar com modelos fundamentais para EEG" para o plano "como implantá-los no departamento". E isso já é uma questão de engenharia e de organização de processo, não apenas de aprendizado de máquina.