
Gestão centralizada de memória em IA multiagente: personalização com custos reduzidos
Os autores propõem uma camada de memória partilhada e sistemática: os agentes guardam informações estruturadas, enquanto o sistema controla a sua seleção, proteção de dados e transmissão aos modelos. Nos testes com o AIOS, esta abordagem melhorou a personalização em relação ao armazenamento externo e ao RAG e, em comparação com a transmissão do contexto completo, reduziu a latência em 15–61%, com resultados comparáveis em dois dos três modelos.
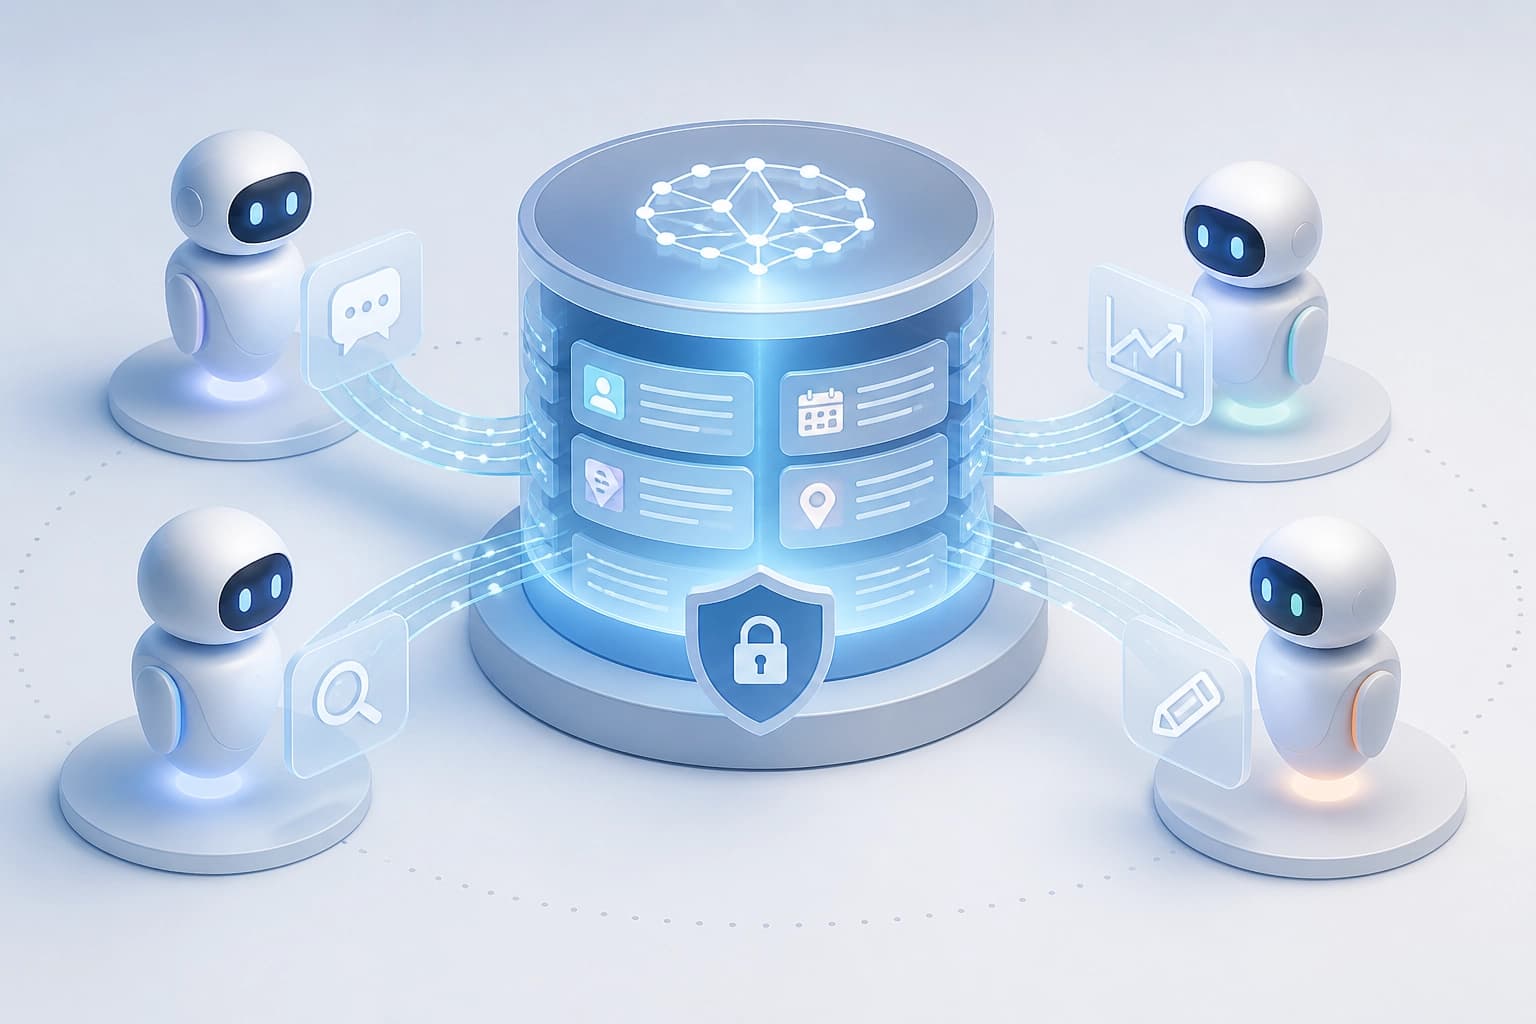
Como funciona a memória central
Agentes especializados registam memórias estruturadas e etiquetadas. O núcleo do sistema de agentes gere a sua recuperação, confidencialidade e inclusão no prompt.
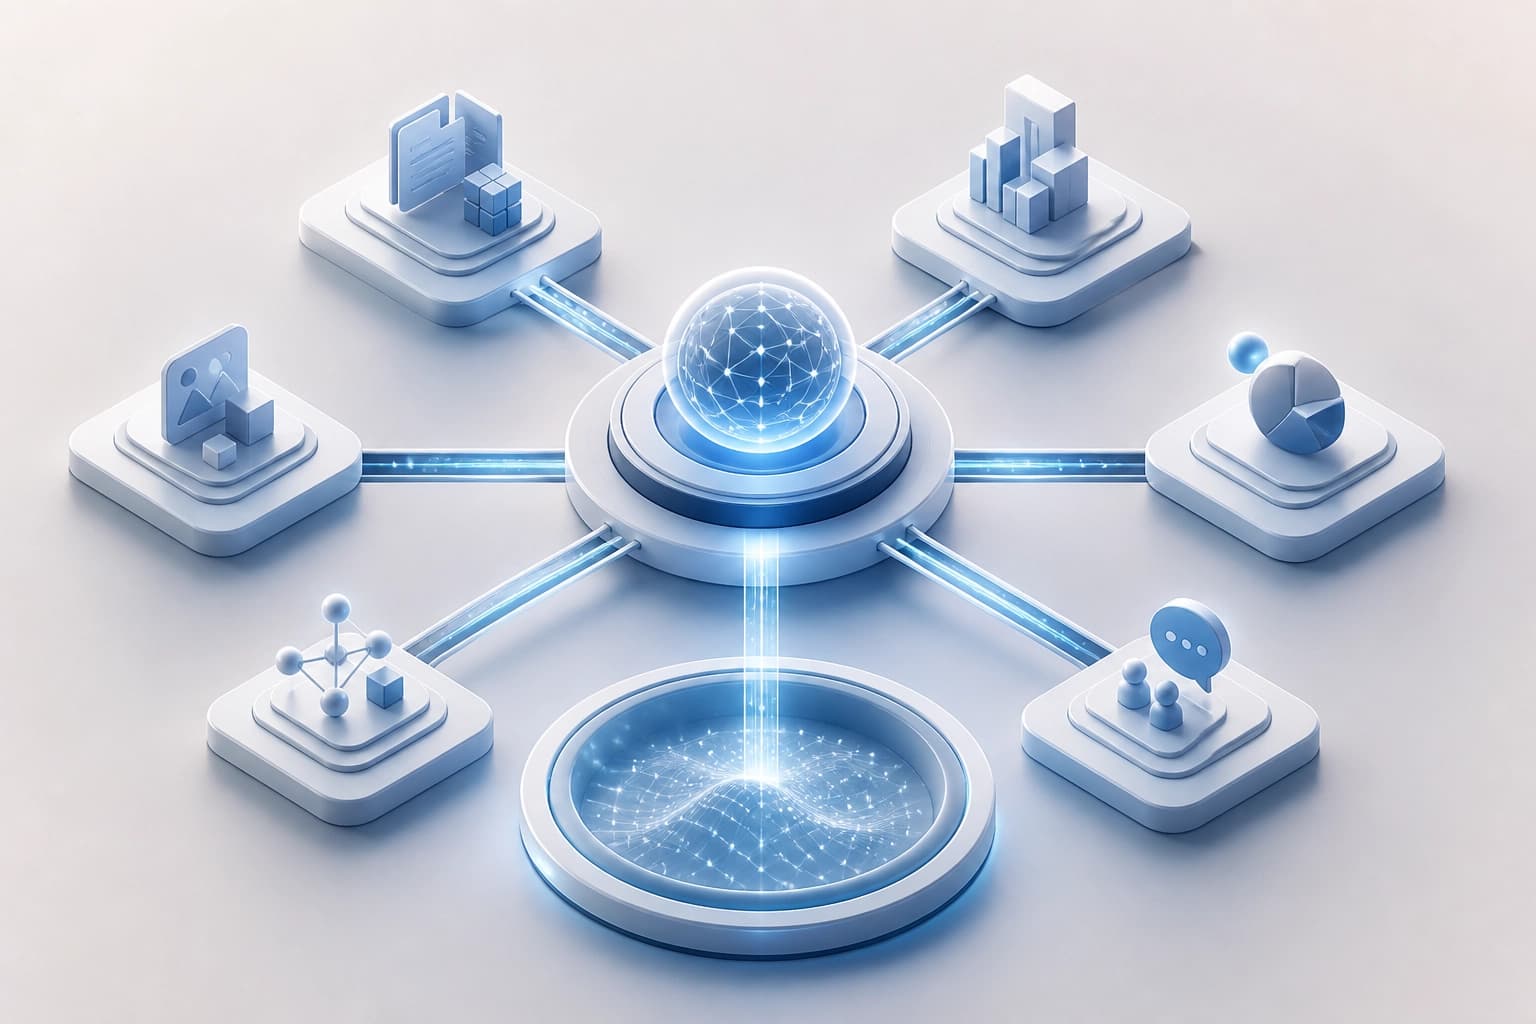
Neste esquema, os agentes criam memórias, e o núcleo determina como o sistema as utiliza:
- Registo: os agentes guardam memórias estruturadas e etiquetadas.
- Recuperação: é gerida pelo núcleo, e não por agentes individuais.
- Proteção e inserção: o núcleo é responsável pela confidencialidade e pela inclusão das memórias no prompt.
A centralização separa a criação de memórias do controlo sobre a sua utilização. Isto é importante quando as regras de recuperação e inserção têm de ser aplicadas a todo o sistema de agentes.
Como a abordagem foi avaliada
O design foi implementado e avaliado no AIOS. Os autores compararam-no com três alternativas em três modelos de assistente.
- GPT-4o
- Llama-3.1:8B
- Qwen-2.5:7B
No total, o estudo incluiu 1 800 ensaios. Esta parte do trabalho descreve a dimensão da avaliação, não as condições específicas de cada comparação.
O que revelaram as comparações
Os resultados dependem da forma como a memória é utilizada. A tabela apresenta as conclusões dos autores para as três alternativas.
| Alternativa | Resultado da gestão centralizada |
|---|---|
| Mem0 com o mesmo armazenamento de base | As pontuações de personalização aumentaram 2,4–4,0 pontos numa escala de cinco pontos. Cada comparação é estatisticamente significativa: p < 10^-18. |
| Implementação padrão através de geração aumentada por recuperação | Os ganhos foram elevados e consistentes nos três modelos. |
| Concatenação completa e não filtrada do contexto | Em dois modelos, os resultados são estatisticamente comparáveis; no terceiro, a variante centralizada teve um desempenho ligeiramente inferior. Os prompts ficaram mais curtos e a latência de ponta a ponta diminuiu 15–61% em todos os modelos. Também diminuíram o número de tokens por chamada e o custo de inferência. |
Para GPT-4o, por exemplo, a pontuação de utilização do perfil passou de 1,05 para 4,69. Este indicador ilustra o resultado da comparação com o Mem0.
Quando considerar a centralização
Vale a pena considerar a gestão centralizada da memória se o sistema precisar de regras comuns para a recuperação, proteção e inserção de memórias. Esta abordagem transfere essas decisões dos agentes individuais para o núcleo do sistema.
Um critério prático consiste em comparar o nível de personalização pretendido com o volume de contexto e os custos aceitáveis. Os autores concluem que a centralização oferece a maior parte das vantagens da personalização com contexto ilimitado, a um custo bastante inferior.
O artigo baseia-se em Memória partilhada gerida pelo núcleo para personalização em todo o sistema, de Ryan Lum e Yongfeng Zhang, submetido em 9 de setembro de 2026.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Avaliação de agentes de programação no desenvolvimento XR interativo: resultados do GenXR-Bench
Foi publicado o GenXR-Bench, um conjunto de 112 tarefas especializadas para avaliar de ponta a ponta agentes de programação no desenvolvimento interativo de XR: desde o aprimoramento de funcionalidades e a correção de defeitos até a criação de aplicações com verificação do comportamento em dispositivos de consumo. Entre os dez modelos testados, o melhor resultado foi de 50,9% no Pass@1; entre as falhas recorrentes estão o processamento de eventos assíncronos de sensores, a ancoragem de objetos no espaço real e a compreensão das interações em contextos físicos.
5 novembro 2026
Da recompensa escalar à fronteira de Pareto: síntese de RTL com aprendizagem por reforço multiobjetivo
É proposto um método para treinar um modelo de linguagem a gerar não apenas um esquema, mas um conjunto de candidatos RTL com diferentes compromissos entre área, latência e consumo de energia; a recompensa é calculada com base na contribuição de cada variante para o hipervolume da fronteira de Pareto. No RTLLM v2, o hipervolume relativo aumentou 13,3 p.p. em relação à versão de base sem otimização de PPA e 14,4 p.p. em relação ao treinamento por reforço com um único objetivo.
5 novembro 2026
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026