
Por que decompor os erros do pipeline
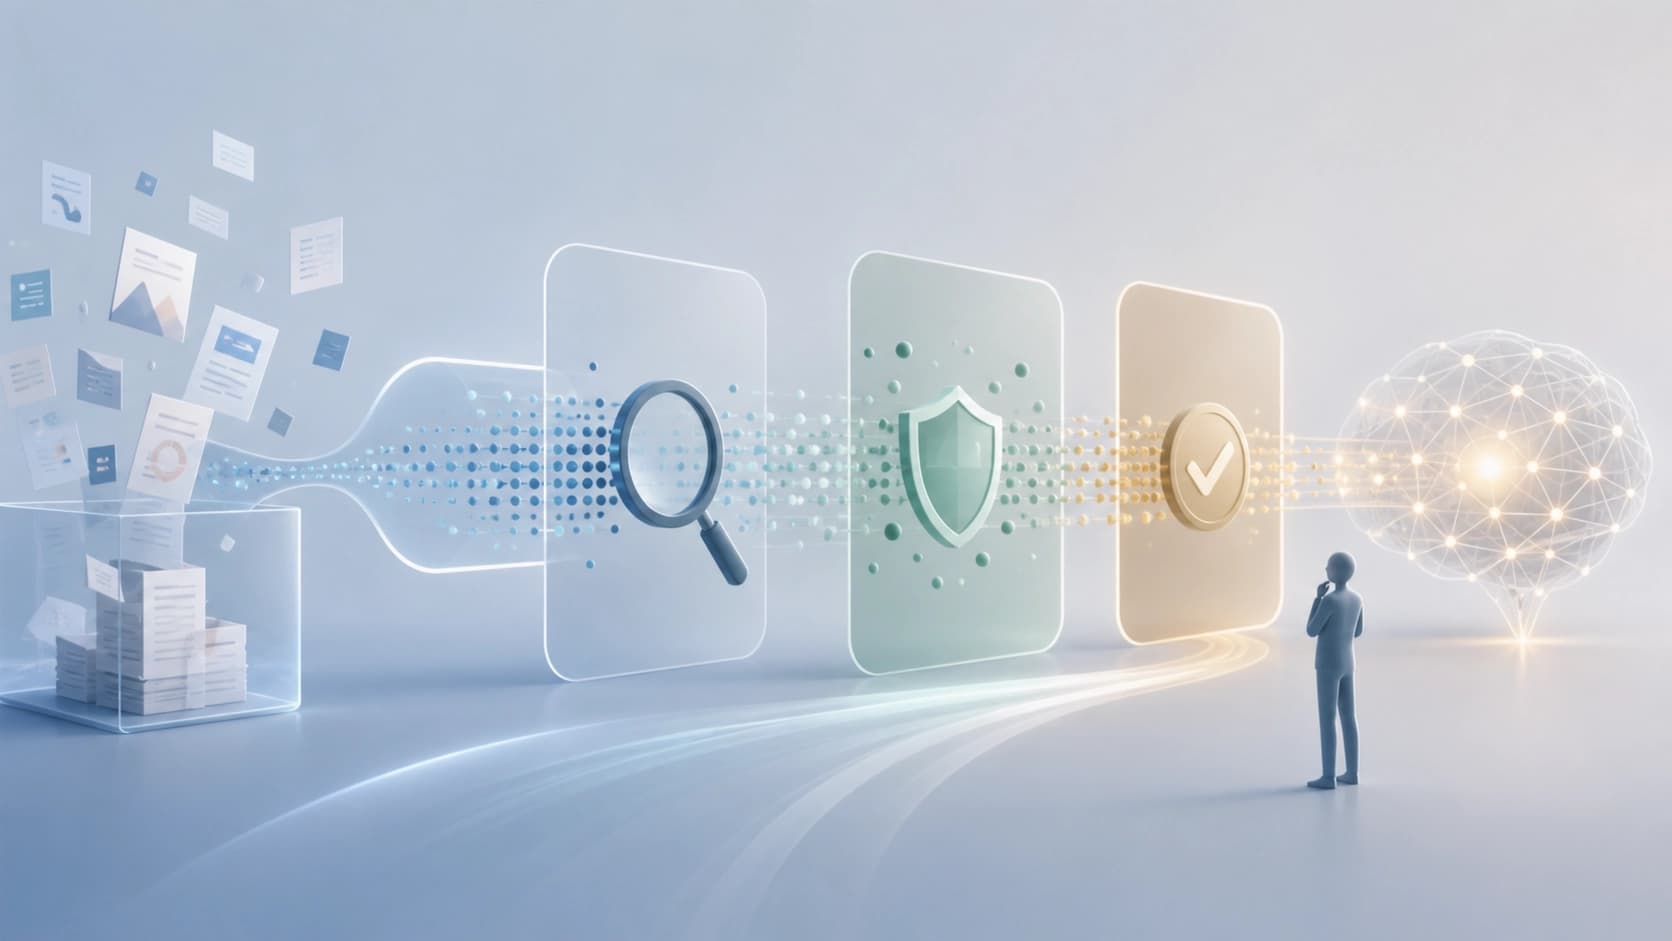
Avaliar um sistema RAG com um único número é conveniente, mas quase inútil. Uma métrica ponta a ponta responde à pergunta "a resposta correspondeu à expectativa", e não à pergunta "por que ela correspondeu ou não". Afinal, RAG não é um bloco monolítico, mas uma cadeia: primeiro algo é encontrado na base, depois o sistema decide se o que foi encontrado é suficiente, e só então o gerador escreve o texto. Uma falha em qualquer um dos elos produz uma resposta igualmente "incorreta" na saída, embora as causas de duas dessas falhas possam ser diretamente opostas.
É justamente esse problema que o trabalho The RAT: A Unified Bayesian Model for RAG Evaluation (arXiv:2608.24753, seção cs.CL, enviado em 25 de agosto de 2026) assume. Os autores — Pius von Däniken, Felix Matthias Saaro, Mark Cieliebak e Jan Deriu — propõem não medir o pipeline como um todo, mas descrevê-lo como um modelo probabilístico, em que cada etapa é uma variável aleatória separada com suas próprias conexões. A partir daí, a avaliação do sistema se transforma em uma tarefa de inferência: quais valores das variáveis latentes explicam com maior verossimilhança as respostas observadas e a anotação.
O que exatamente o framework bayesiano modela
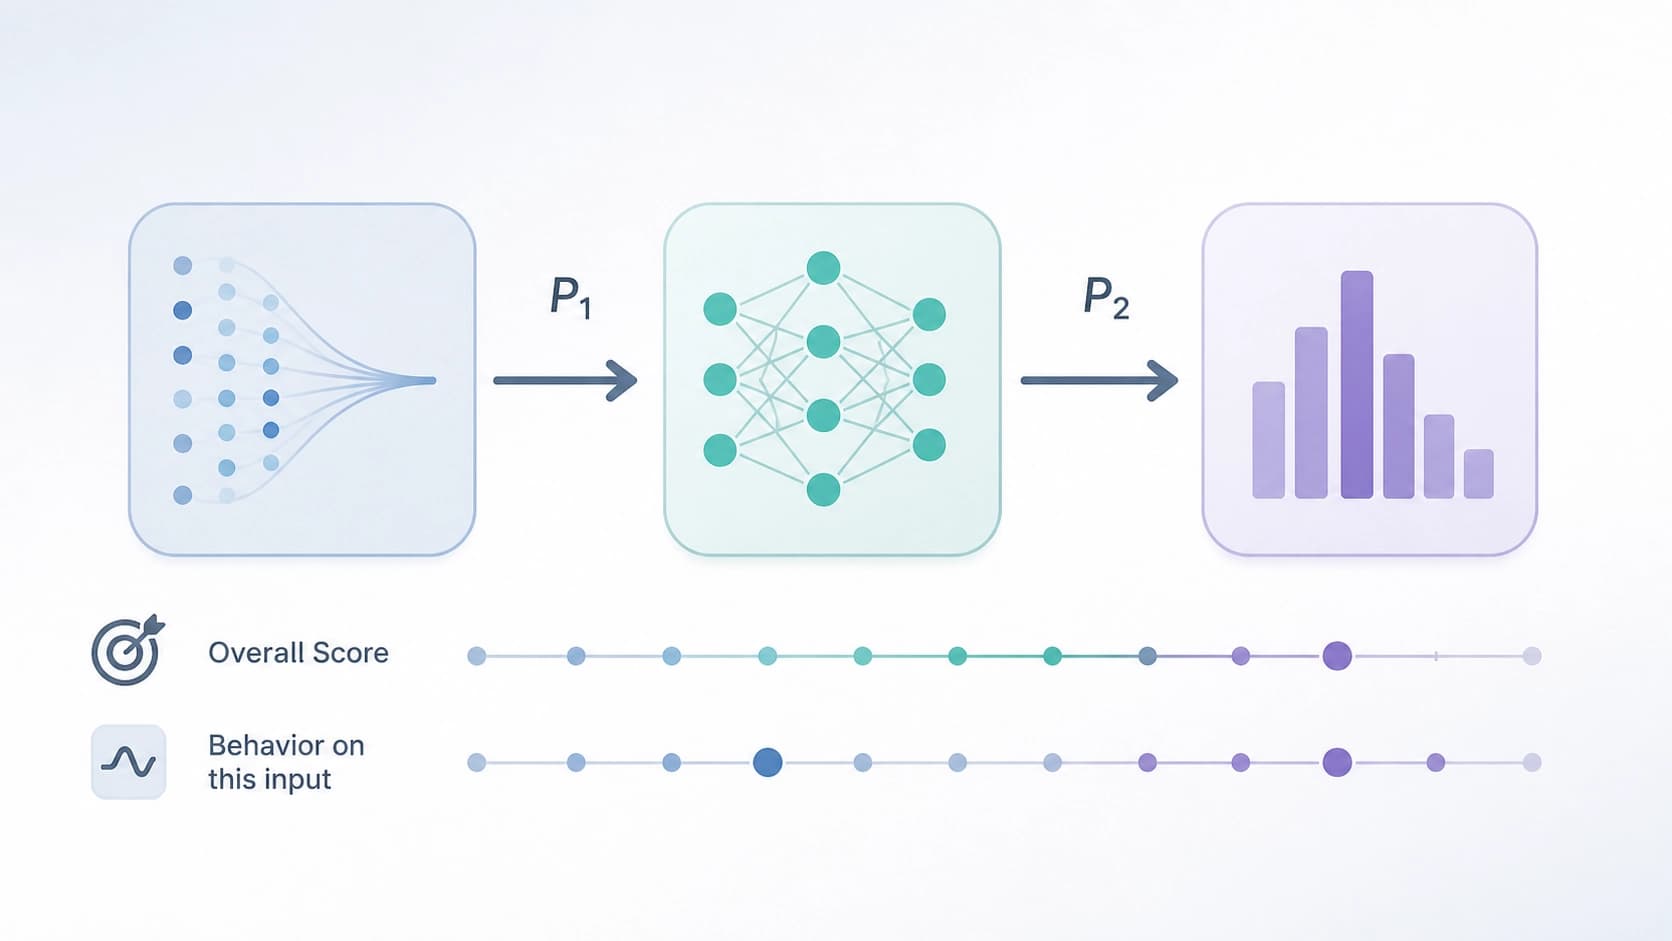
A ideia central é a fatoração pelo fluxo de informação. As variáveis não são introduzidas "por componentes do pipeline" de forma mecânica, mas na ordem em que a informação realmente se move pelo sistema: o sucesso da busca influencia como o gerador deve se comportar, e o comportamento do gerador, junto com o desfecho da busca, determina a correção final da resposta. Essa estrutura torna as dependências explícitas, em vez de escondidas dentro de uma avaliação agregada.
Assim, o modelo The RAT obtém três camadas com conteúdo próprio, que normalmente se fundem em um único indicador.
Sucesso da tarefa e sucesso do gerador são questões diferentes
A primeira camada é o sucesso da tarefa: o usuário acabou recebendo a resposta correta. A segunda é o sucesso do gerador: o gerador se comportou de maneira adequada diante do que recebeu na entrada. Formalmente, a segunda é uma qualidade condicional: o quanto o comportamento do modelo é adequado ao desfecho de busca dado, e não em geral.
A diferença é fundamental. O sistema pode dar uma resposta correta apesar de uma busca ruim — o gerador adivinhou a partir da memória paramétrica. Formalmente, é um sucesso da tarefa, mas o comportamento foi incorreto: o sistema respondeu sem se apoiar nas fontes, e em outra consulta esse hábito resultará em alucinação. E o contrário também: a busca encontrou tudo o que era necessário, o gerador respondeu com cuidado — e ainda assim o resultado é incorreto, porque a pergunta foi mal compreendida. A métrica ponta a ponta não distingue esses dois casos; a condicional distingue.
A abstenção não é uma falha, mas uma decisão
O terceiro elemento do modelo é o comportamento de abstenção. No contexto de RAG, recusar-se a responder às vezes é a única reação correta: se não há nada relevante na base, um honesto "não sei" é melhor do que uma invenção confiante. Mas essa mesma recusa se torna um erro quando o documento necessário foi encontrado e o sistema não o utilizou.
Por isso, a abstenção não pode ser avaliada isoladamente do desfecho da busca — apenas condicionalmente. O modelo The RAT leva isso em conta diretamente: ele observa se o fato de recusar ou responder combina com o que realmente estava no contexto. Essa perspectiva também é útil para decisões de produto: se o sistema se abstém em massa quando a busca é bem-sucedida, o problema não está no gerador, mas em como o contexto chega até ele.
Por que as métricas marginais enganam
Os autores aplicaram o framework a 27 configurações — são três conjuntos de dados, três retrieveres e três geradores, combinados em todas as permutações. A enumeração completa aqui não é um fim em si: ela mostra como a decomposição se comporta quando exatamente um elo muda e os demais permanecem no lugar.
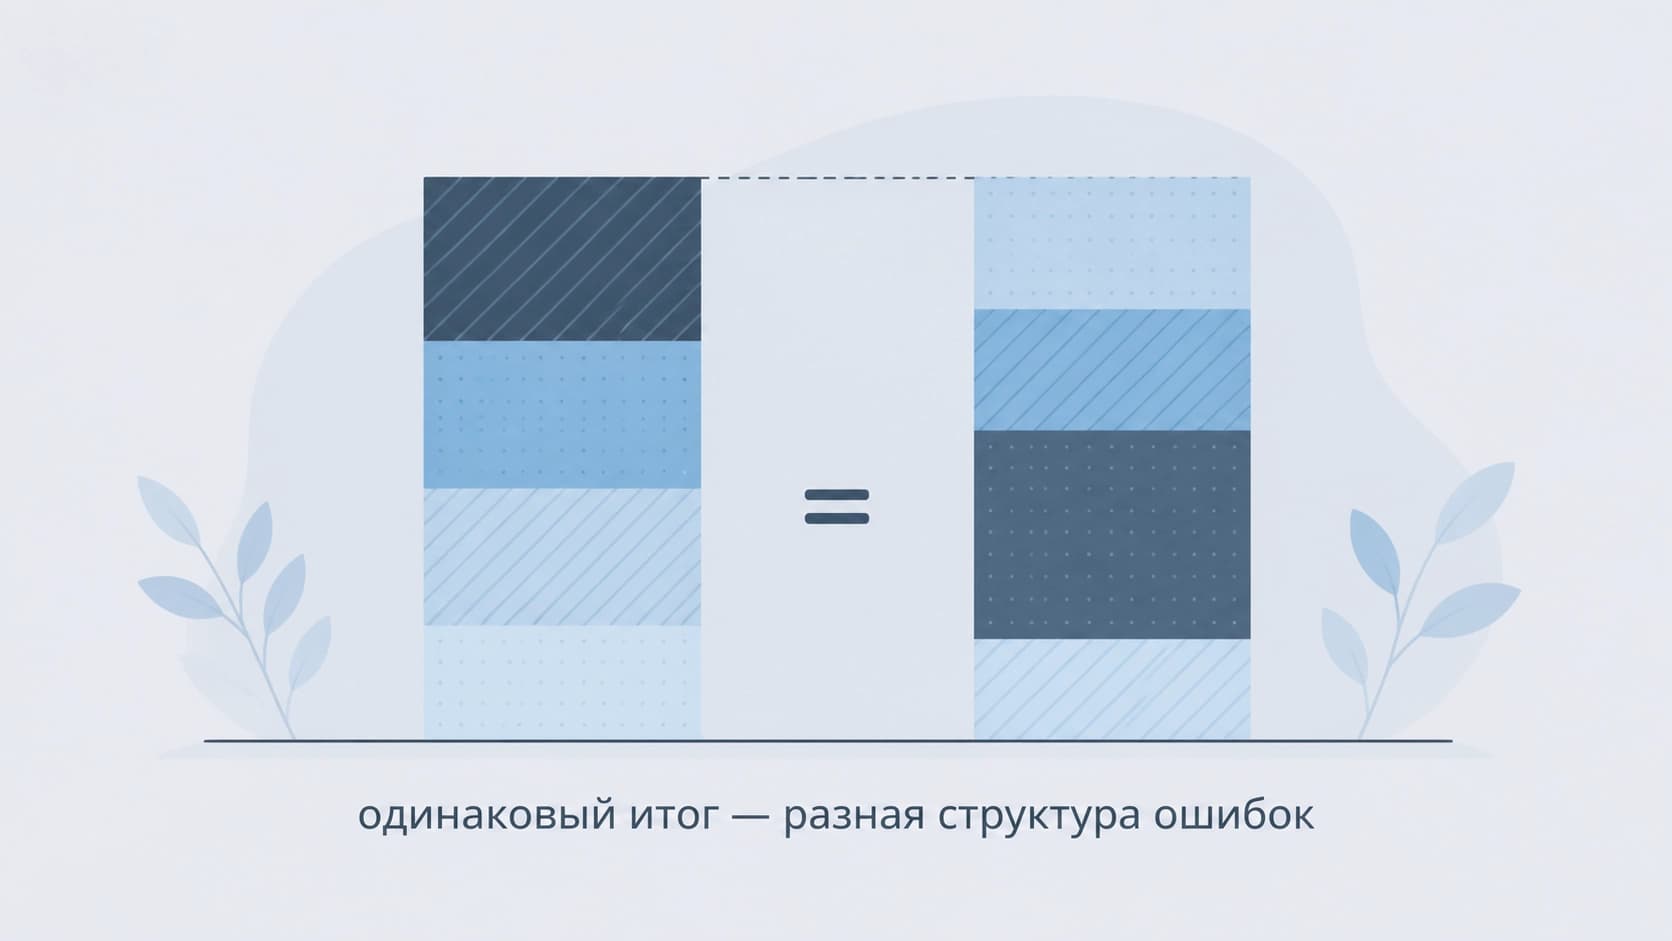
O resultado pelo qual tudo isso foi feito: a decomposição condicional revela diferenças comportamentais notáveis entre sistemas que, pelas métricas marginais, parecem equivalentes. Dois pipelines podem apresentar a mesma proporção de respostas corretas e, ainda assim, divergir em dezenas de por cento dos casos quanto a onde exatamente erram — na busca, na política de recusa ou na geração. Para quem escolhe uma configuração para um produto, são sistemas diferentes; para quem olha um único número na tabela, são iguais.
Onde alocar o orçamento de anotação
Uma parte separada do trabalho é dedicada à distribuição das anotações. A anotação é cara, e é lógico perguntar: se só se pode fazer uma pergunta às pessoas sobre cada exemplo, qual pergunta escolher?
A resposta dos autores: anotações sobre o sucesso da busca são mais informativas do que anotações sobre o sucesso da tarefa, se o objetivo é julgar a adesão do sistema à política (policy adherence). A razão não está na conveniência, mas na estrutura do modelo: a anotação da busca recai sobre uma variável situada no início da cadeia causal, por isso ela também "ilumina" as camadas inferiores. A anotação do sucesso final diz respeito a uma variável na saída, e fala muito menos sobre o que aconteceu internamente. Os autores dão a esse efeito assimétrico uma explicação da teoria da informação.
A conclusão prática é simples: se o orçamento é limitado, vale mais perguntar aos anotadores não "a resposta está correta", mas "encontrou-se o que era necessário". A primeira soa melhor no relatório, a segunda é mais útil para o diagnóstico.
O juiz LLM como observação ruidosa
A terceira parte é a extensão do modelo para avaliações automáticas. O esquema do The RAT permite conectar veredictos de LLM-as-a-judge não como substituto do humano, mas como observações ruidosas calibradas: o juiz tem sua própria probabilidade de errar, e ela é estimada dentro do mesmo modelo probabilístico.
Isso elimina a oposição artificial entre "anotação humana cara versus avaliação automática barata". Em um único modelo, é possível manter um pequeno corpus de julgamentos especializados, que definem a escala e a calibração, e um grande fluxo de avaliações automáticas, que refinam os parâmetros. O juiz deixa de ser um oráculo e passa a ser mais uma fonte de sinal — com um erro conhecido e, o que é importante, mensurável.
O que levar para a sua prática
- Não trate o pipeline como um único nó. Assim que o relatório passa a ter uma métrica separada para a busca, uma separada para o comportamento do gerador e uma separada para a recusa, as discussões sobre "o que quebrou" se transformam em diagnóstico, e não em um exercício de hipóteses.
- Avalie o comportamento condicionalmente. A correção da resposta e a adequação do comportamento diante de um dado contexto são questões diferentes, e um bom resultado final não justifica um processo ruim.
- Monte o relatório por recortes, não pela média. Dois sistemas com a mesma qualidade ponta a ponta podem exigir melhorias completamente diferentes.
- Escolha o que anotar. Se o recurso humano é limitado, a anotação das etapas iniciais fornece mais informação sobre o sistema como um todo.
- Mantenha as avaliações automáticas na coleira. O juiz LLM é útil como observação com um modelo de erro, e não como verdade absoluta.
A perspectiva bayesiana aqui é valiosa não pela matemática em si, mas pela disciplina de pensamento: ela obriga a nomear de antemão quais grandezas são latentes, quais são observáveis e como uma se relaciona com a outra. Depois disso, qualquer tabela de resultados deixa de ser um conjunto de números e passa a ser uma descrição de como o sistema toma decisões.


