
Perturbações nos dados de entrada podem interromper o funcionamento de cascatas de IA energeticamente eficientes
Pesquisadores identificaram três cenários de falha em modelos em cascata quando os dados são corrompidos: quebra de roteamento, degradação de ambos os modelos ou falsa estabilidade das previsões. Isso mostra que, ao avaliar tais sistemas, não se pode confiar apenas na precisão — é importante considerar também a robustez do mecanismo de roteamento a mudanças de distribuição.
Eficiência energética em cascatas de IA: quando a falha de dados quebra o roteamento
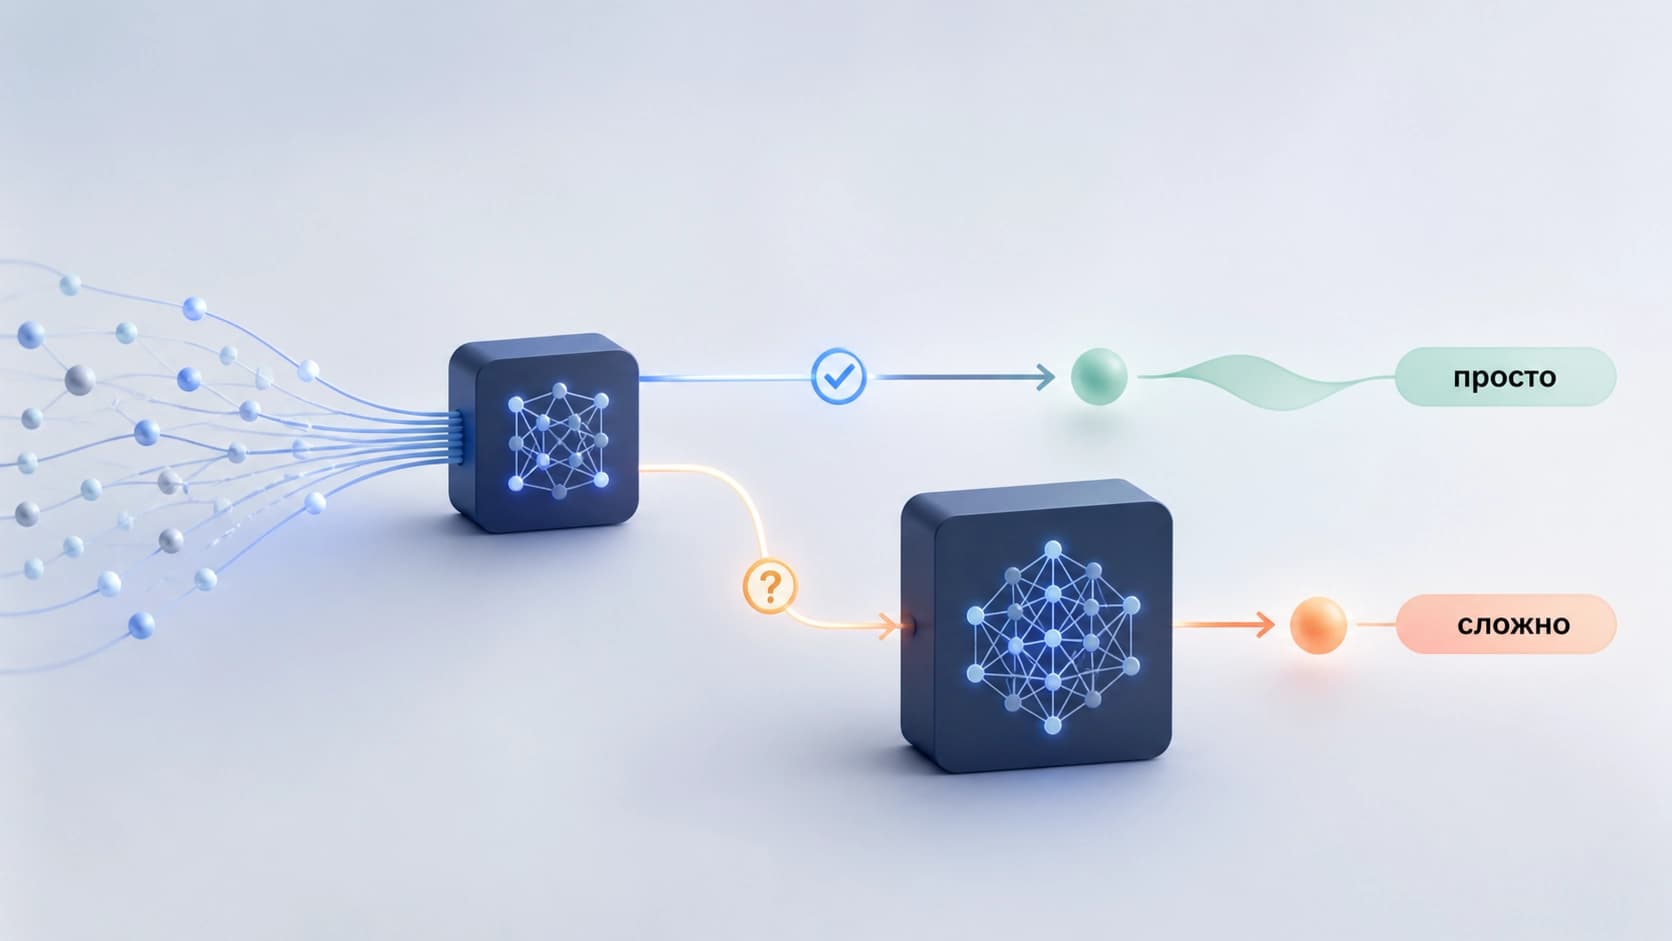
Os sistemas de IA modernos estão cada vez mais sendo construídos não como um único modelo gigante, mas como uma cascata de vários modelos de tamanhos diferentes. A ideia é simples: para consultas simples, um modelo leve e rápido é suficiente, enquanto casos complexos ou ambíguos são encaminhados para um modelo maior e mais preciso. Essa abordagem permite reduzir drasticamente o consumo de energia, mantendo ao mesmo tempo a alta qualidade das previsões. No entanto, esse esquema tem um ponto vulnerável — o roteamento, que determina a qual modelo os dados de entrada serão confiados.
Como funciona uma cascata de modelos
O elemento-chave da cascata é o mecanismo de adiamento (deferral) baseado na confiança. O modelo compacto processa os dados e produz não apenas uma previsão, mas também uma estimativa de sua própria confiança. Se a confiança for alta — a resposta é aceita. Se for baixa — a amostra é encaminhada para um modelo mais pesado, que fornece a resposta final. Em dados limpos e não distorcidos, esse roteamento geralmente opera de forma estável e oferece ganhos de eficiência energética sem perda de precisão.
O problema surge quando os dados de entrada contêm perturbações — por exemplo, danos estáticos (ruído, corte, artefatos) ou distorções sequenciais que mudam de consulta para consulta. Mesmo pequenas alterações podem deslocar a estimativa de confiança do modelo e, com ela, a decisão sobre se a amostra deve ser encaminhada adiante na cascata.
O que o estudo mostrou
O trabalho recente "Accuracy and Robustness of Model Cascades Under Data Perturbations" (autores — Pallavi Mitra, Jai Kushwaha, Felix Biessmann, aceito no GREEN-AI Workshop at ECML-PKDD 2026) aborda justamente a robustez dessas cascatas a perturbações. Os autores construíram uma cascata de modelos para classificação de imagens, escolhendo uma configuração no ótimo de Pareto em termos de precisão, qualidade de roteamento e consumo de energia. Essa configuração, em dados limpos, demonstra desempenho preditivo competitivo e, ao mesmo tempo, reduz as emissões de CO₂ em até 10 vezes em comparação com o uso apenas do modelo grande. No entanto, com danos artificiais nos dados de entrada, o comportamento da cascata muda visivelmente — e nem sempre na direção esperada.
Três modos de falha
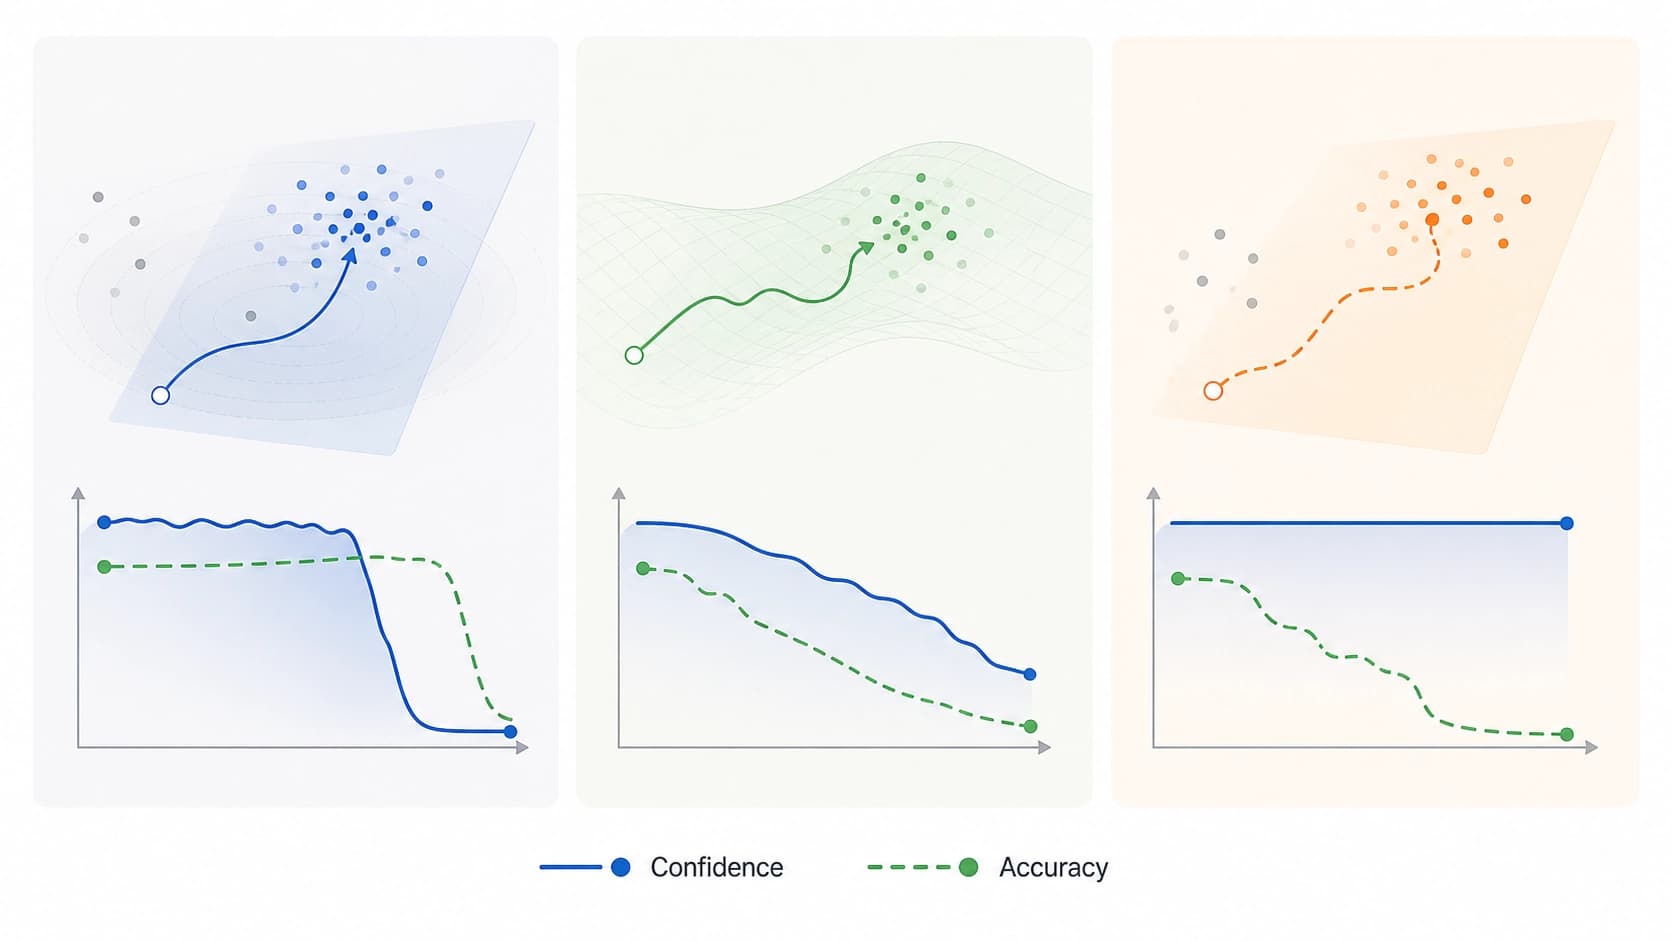
A análise mostrou que as perturbações levam a três cenários característicos, cada um dos quais destrói o funcionamento normal da cascata de uma maneira diferente.
Primeiro modo: o sinal de roteamento quebra. Danos estáticos podem tornar a estimativa de confiança praticamente inútil. O modelo compacto não percebe que os dados estão corrompidos e, com alta confiança, produz uma resposta incorreta ou, inversamente, encaminha tudo para o modelo superior. Nesse caso, o modelo grande ainda é capaz de corrigir erros, mas o ganho de energia se perde — a cascata degrada para um simples processamento sequencial.
Segundo modo: ambos os modelos falham. Às vezes, os danos pioram o desempenho não apenas do modelo leve, mas também do modelo grande. Nesse caso, o mecanismo de adiamento deixa de ajudar: mesmo após encaminhar o caso complexo para o modelo superior, a precisão não é recuperada. Na prática, a cascata não fica melhor do que qualquer uma de suas partes, e o consumo de energia permanece alto.
Terceiro modo: estabilidade em vez de confiabilidade. Esse cenário surge com perturbações sequenciais, quando as distorções se acumulam ou mudam de consulta para consulta. Os modelos passam a produzir previsões estáveis — mas estáveis e incorretas. Ao mesmo tempo, o mecanismo de adiamento é suprimido: o sistema confia em suas respostas, embora elas estejam erradas. Esse é o caso mais perigoso, pois o erro é difícil de perceber pelo comportamento da cascata.
Por que isso é importante
A conclusão dos pesquisadores é direta: avaliar cascatas energeticamente eficientes apenas pela precisão em dados limpos não é suficiente. É necessário considerar explicitamente como o roteamento se comportará diante de uma mudança na distribuição dos dados de entrada. Na operação real, os dados quase sempre diferem dos dados de treinamento — devido a mudanças de iluminação, ruído em fotografias, novos formatos ou ataques ao modelo. Se a cascata não for testada quanto à robustez do roteamento, sua eficiência energética se torna uma ilusão.
Para profissionais da área, isso significa que, ao implementar arquiteturas em cascata, é importante incluir nos testes não apenas amostras ideais, mas também danos sintéticos de diferentes tipos. Caso contrário, pode-se obter um sistema que economiza energia apenas até o primeiro contato com o mundo real — e então produz silenciosamente decisões confiantes, porém incorretas.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Verificação de alucinações em LLMs com uma representação SQL das fontes, sem ajuste fino
Este trabalho avalia se uma LLM consegue recorrer a uma competência simbólica básica — construir uma base de dados SQL a partir de documentos de origem — para fundamentar as respostas nas fontes sem supervisão na deteção de alucinações. No RAGTruth e no DiaHalu, este pipeline neuro-simbólico revela-se mais preciso do que a previsão direta e comparável aos métodos mais avançados, sem exigir afinação específica ao domínio.
9 novembro 2026
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026
AffordanceWAM: affordances como intermediárias entre a previsão da cena e o controlo do manipulador
O trabalho descreve um modelo generativo que prevê simultaneamente observações RGB futuras, campos escalares, mapas de calor de affordances e comandos contínuos para o robô, usando vídeos humanos para ampliar a diversidade das interações sem anotações de ações nem retargeting. No RoboCasa, no CALVIN ABC→D e em tarefas reais, a abordagem apresenta ganhos consistentes em relação às linhas de base que usam apenas RGB e apenas dados robóticos.
9 novembro 2026