Recompensa por resultado — e o ponto cego dentro dela
Nas pesquisas sobre agentes de GUI, o foco mudou visivelmente: cada vez mais trabalhos são dedicados à modelagem de recompensa por resultado (outcome reward modeling). A lógica é simples — o agente recebe uma pontuação dependendo de sua trajetória ter levado ao estado que a instrução do usuário pressupunha. Há uma ação, há uma tela, há um resultado, há uma avaliação.
Mas é aqui que se esconde a armadilha. Se o agente recebe recompensa "pelo resultado", alguém precisa formular o que exatamente conta como resultado. No esquema típico, essa etapa ou é omitida, substituída por uma formulação genérica, ou fica a critério do próprio modelo: ele "raciocina" durante a verificação, sem critérios explicitamente fixados. Ambas as abordagens parecem funcionar exatamente até o momento em que é preciso avaliar dezenas de tarefas diferentes com o mesmo verificador.
Três erros típicos de rubricas generalizadas
Os autores do trabalho arXiv:2608.24174 "Task-Adaptive Rubrics for GUI Reward Modeling" (Tao Xiong e coautores) descrevem a que leva a dependência de um modelo universal ou do raciocínio implícito do modelo. Os problemas são previsíveis:
- Transferência de verificações entre tarefas. Um critério derivado em algum momento para um cenário é aplicado mecanicamente a outro, onde simplesmente não faz sentido.
- Perda de restrições. Requisitos específicos da instrução atual — valores necessários, campos concretos, etapas determinadas — passam despercebidos, porque a rubrica geral não os distingue.
- Rigor excessivo. O verificador passa a exigir o que o usuário não pediu e rejeita uma tarefa executada corretamente.
A causa comum aos três é uma só: a rubrica vive separada da tarefa. Ela não é derivada da instrução, mas anexada a ela de fora.
Como o AdaptRubric é estruturado
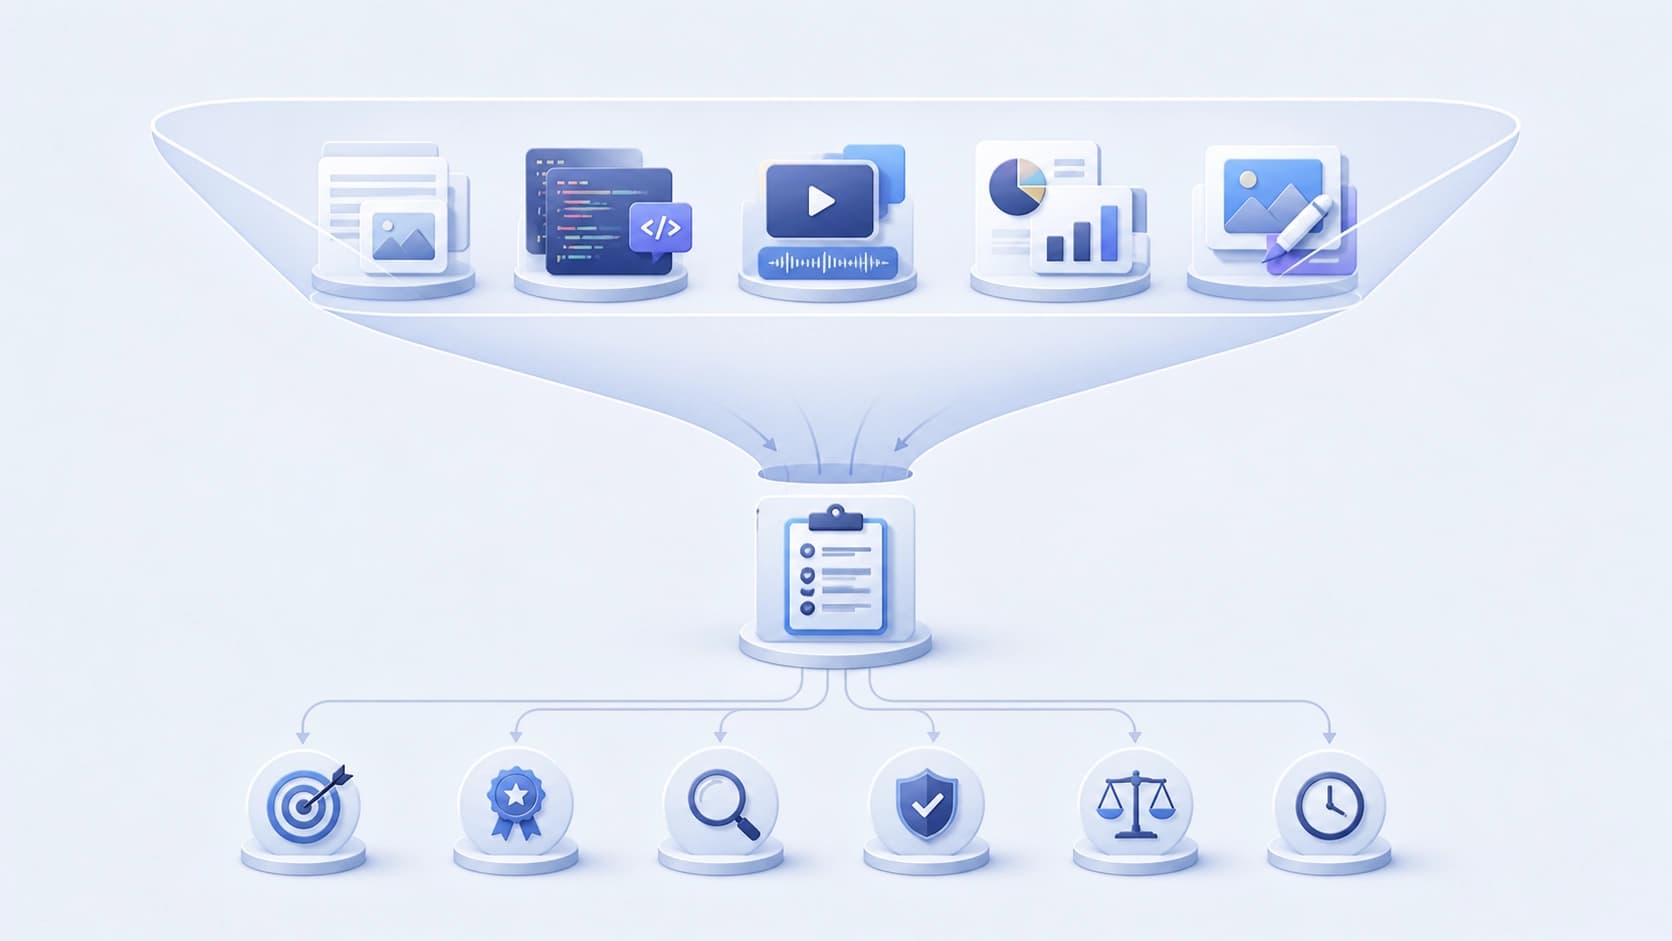
O framework proposto chama-se exatamente assim — rubricas "do grosso ao fino" (Coarse-to-Fine Rubrics Framework). Sua tarefa não é armazenar um conjunto pronto de critérios, mas construí-los para cada instrução específica, avançando do nível amplo ao estreito. Duas etapas resolvem dois problemas diferentes, e esse é o detalhe-chave da construção.
Etapa grossa: primeiro entender que classe de tarefas é esta
O primeiro passo é o roteamento. A instrução é atribuída a uma determinada família de tarefas de GUI, e dessa família são extraídos critérios reutilizáveis. O sentido é que ações semelhantes têm sinais de sucesso estáveis: eles já são conhecidos e não é preciso reinventá-los para cada nova solicitação. A rubrica grossa define um enquadramento — um enquadramento, não uma sentença final.
Etapa fina: extrair os detalhes da instância concreta
O segundo passo já trabalha com uma instrução individual. Dela são extraídas pistas compactas — valores concretos, áreas de atuação, restrições que são essenciais nessa tarefa. É aqui que a rubrica deixa de ser geral e se torna própria para este caso. Requisitos que o usuário não estabeleceu não aparecem; requisitos que ele estabeleceu não se perdem.
Essa separação elimina a principal objeção aos esquemas universais: a generalização permanece, mas não substitui mais a especificação.
Resultados: offline e em aprendizado por reforço
O AdaptRubric foi testado em dois modos. O primeiro — avaliação de recompensa offline, ou seja, quão bem o verificador distingue trajetórias bem-sucedidas das malsucedidas. O segundo — otimização online com aprendizado por reforço, onde as rubricas funcionam como fonte de sinal para o treinamento do agente.
Os números declarados: com um orçamento de imagens comparável, a métrica F1 cresceu 3,6 pontos em relação à média das soluções de base, e o ganho na taxa de sucesso na execução das tarefas foi de 4,23 pontos. Os autores destacam que a vantagem se reproduz de forma estável, e não se sustenta em execuções isoladas bem-sucedidas.
O que isso muda na essência
A avaliação do agente deixa de ser uma questão de "verificador bom ou ruim". Ela se torna uma questão de procedimento: quem e com base em quê formulou os critérios para esta tarefa específica. Enquanto os critérios eram derivados implicitamente, o erro de avaliação era quase impossível de separar do erro do próprio agente — ambos pareciam iguais no relatório final.
A abordagem com rubricas adaptativas torna a camada intermediária explícita, e portanto ela pode ser verificada, discutida e corrigida separadamente do modelo. Para o desenvolvimento, isso é também uma conveniência prática: se a rubrica é construída a partir da instrução, então alterar a formulação da tarefa muda automaticamente também a forma de avaliá-la, sem reescrever o verificador.
Restam também questões em aberto — quão bem o roteamento lida com tarefas na fronteira entre famílias, como a etapa fina se comporta em instruções deliberadamente ambíguas. Mas a própria formulação já parece mais útil do que mais uma tentativa de tornar um modelo universal um pouco mais preciso.