
Sinyal lampu lalu lintas dikendalikan oleh model VLA VLALight: inferensi tindakan end-to-end langsung dari video kamera pinggir jalan
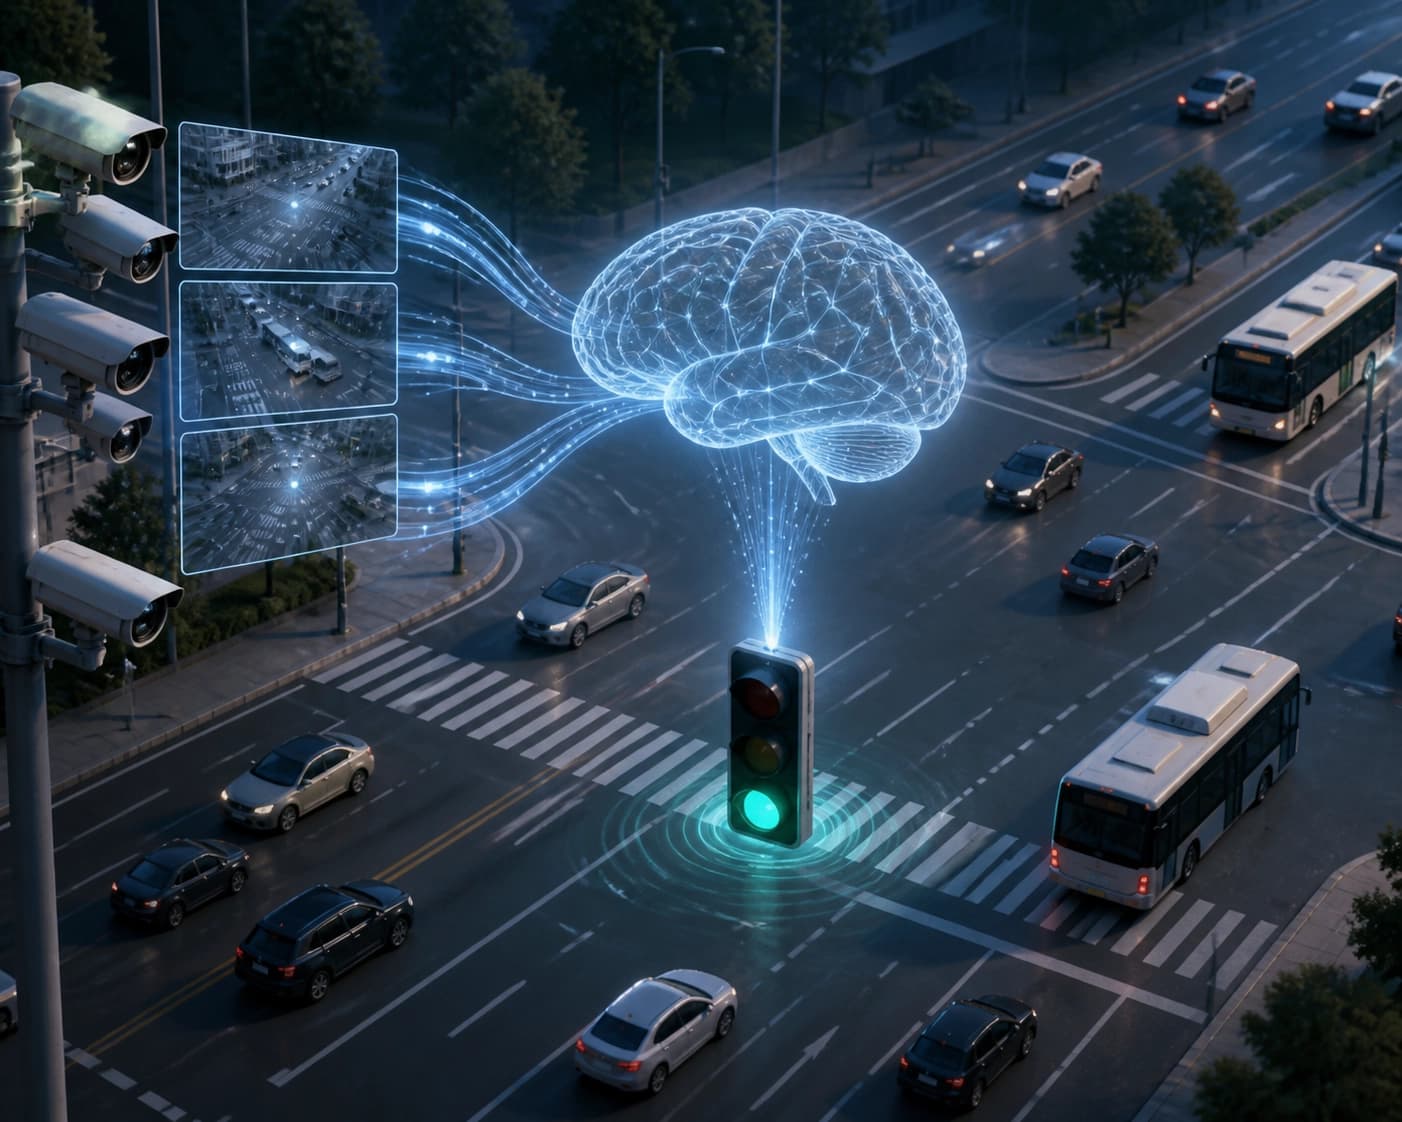
Para penulis memperkenalkan VLALight — model end-to-end kelas “visi–bahasa–aksi” yang mengubah rekaman multikamera dari persimpangan langsung menjadi pergantian sinyal, tanpa perlu menetapkan status arus lalu lintas secara manual. Model ini mengandalkan persepsi bersama yang memperhitungkan topologi persimpangan, pembelajaran penguatan pada tingkat jaringan perkotaan, serta pemilihan adaptif antara penalaran cepat dan mendalam; pada tujuh set data nyata di tiga kota, solusi ini mengungguli baseline berbasis model transportasi, pembelajaran penguatan, dan LLM/VLM.
Apa itu model VLA untuk mengendalikan lampu lalu lintas
VLALight adalah model vision-language-action untuk mengendalikan lampu lalu lintas. Penulis: Pan Zhang, Siqi Lai, Kemu Dong, Hao Liu. Makalah diajukan pada 29 September 2026. Ini adalah model VLA pertama untuk pengendalian lampu lalu lintas secara end-to-end menggunakan video multi-view dari kamera tepi jalan.
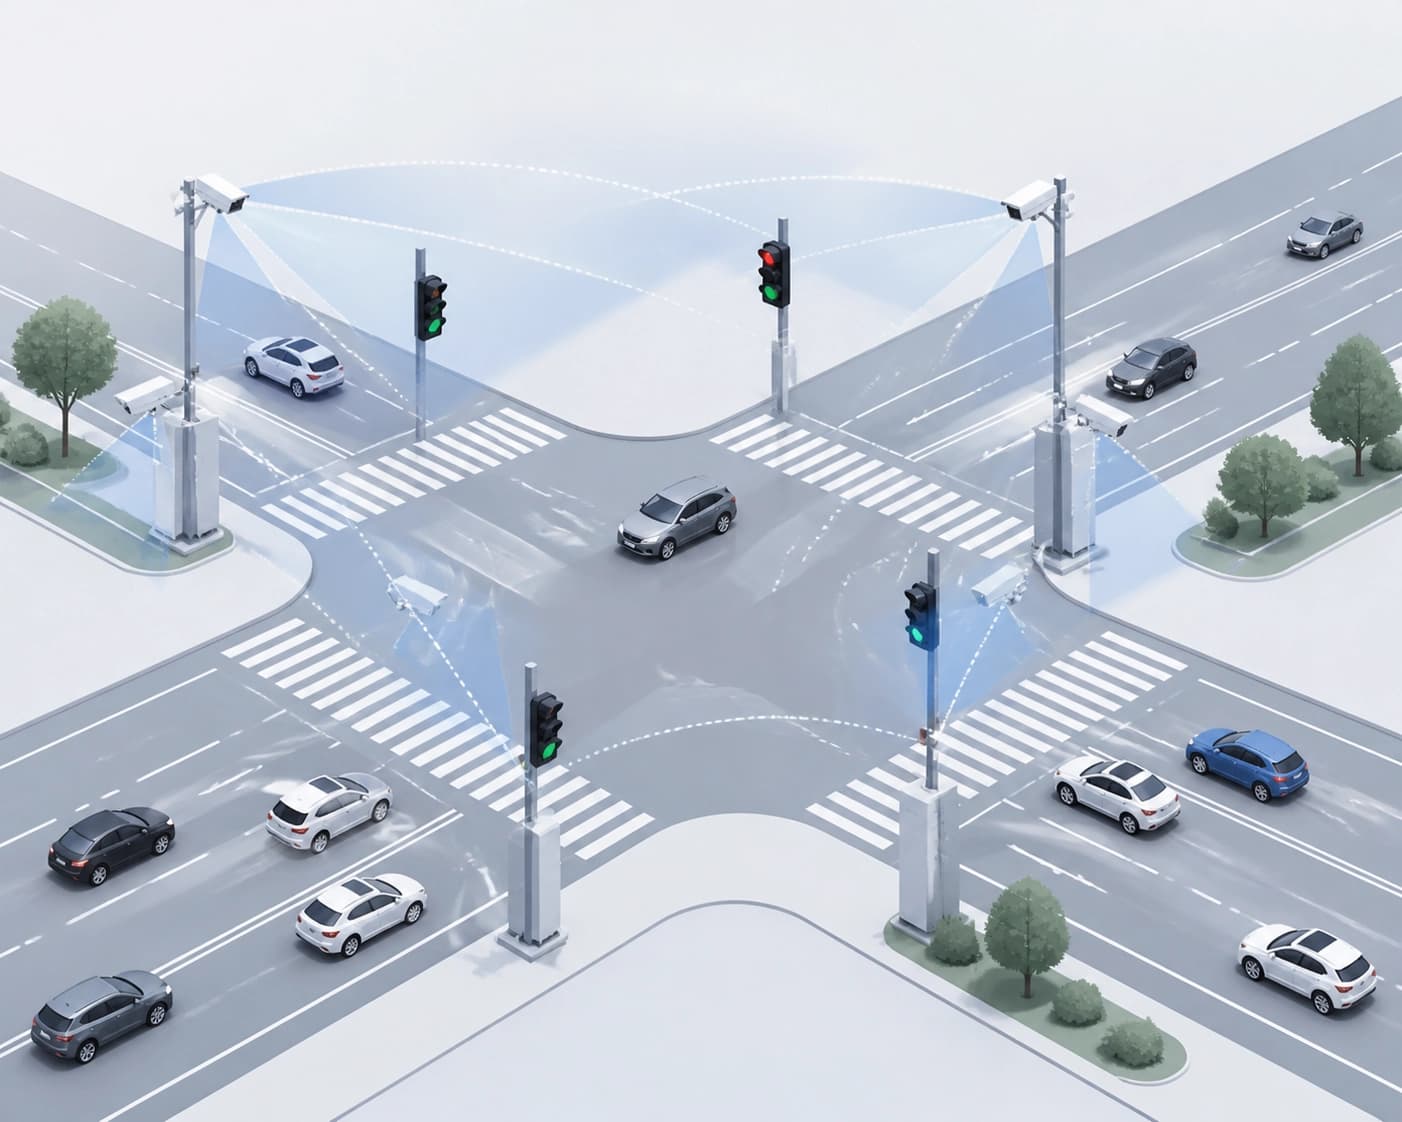
Model ini secara langsung mengubah pengamatan visual menjadi tindakan lampu lalu lintas yang terkoordinasi. Model menggunakan penalaran spasiotemporal atas beberapa target. Model juga memperhitungkan persepsi bersama di persimpangan secara topologis.
Karakteristik utama pendekatan ini:
- Inferensi end-to-end: pengamatan visual diubah menjadi tindakan lampu lalu lintas.
- Video multi-view: data berasal dari kamera tepi jalan.
- Penalaran spasiotemporal: model mempertimbangkan beberapa target.
- Perhitungan topologis: persepsi bersama di persimpangan.
Kriteria pemilihan: pendekatan VLA menggabungkan persepsi dan pengendalian dalam satu model. Hal ini membedakannya dari skema yang memisahkan kedua tugas tersebut. Keterkaitan end-to-end antara video dan tindakan adalah kriteria utamanya.
Cara melatih VLALight: dua tahap
Pelatihan VLALight mencakup strategi dua tahap. Pertama, diterapkan supervised cold-start. Tahap ini mengembangkan pemahaman visual terhadap situasi jalan dan pengambilan keputusan terkait sinyal. Kemudian, cooperative agentic reinforcement learning diterapkan.
Tahap kedua mengoptimalkan pengendalian lokal dan efisiensi jaringan transportasi secara keseluruhan secara bersamaan. Tahap pertama berfokus pada pemahaman adegan dan sinyal. Tahap kedua mengoptimalkan pengendalian lokal dan jaringan.
| Tahap | Tugas | Yang dioptimalkan |
|---|---|---|
| Supervised cold-start | Pemahaman visual terhadap situasi jalan dan pengambilan keputusan terkait sinyal | Keterampilan awal model |
| Cooperative agentic reinforcement learning | Optimisasi bersama | Pengendalian lokal dan efisiensi jaringan |
Kriteria pemilihan: periksa apakah pendekatan ini mencakup optimisasi bersama di tingkat jaringan. Keputusan lokal tanpa konteks jaringan membatasi dampaknya. Pembagian menjadi dua tahap memisahkan pelatihan persepsi dan penyempurnaan interaksi.
Mode penalaran adaptif dan biaya inferensi
VLALight menggunakan mode penalaran cepat dan lambat yang adaptif. Penalaran yang lebih mendalam hanya diterapkan ketika memberikan manfaat yang cukup untuk pengendalian. Model menggunakan mode-aware rollouts yang seimbang dan relative advantage optimization. Model belajar menemukan kompromi antara kualitas keputusan dan biaya inferensi.
| Mode | Kondisi aktivasi | Dampak |
|---|---|---|
| Cepat | Penalaran mendalam tidak memberikan manfaat yang cukup | Biaya inferensi lebih rendah |
| Lambat | Penalaran mendalam memberikan manfaat yang cukup | Keputusan berkualitas lebih tinggi |
Kriteria pemilihan: kompromi antara kualitas keputusan dan biaya inferensi. Mode harus beralih berdasarkan manfaatnya untuk pengendalian. Pengoperasian terus-menerus pada tingkat kedalaman maksimum akan meningkatkan biaya.
Hasil eksperimen
Eksperimen dilakukan pada tujuh kumpulan data arus lalu lintas nyata. Kumpulan data tersebut mencakup tiga jaringan perkotaan. VLALight mengungguli metode dasar. Metode dasar tersebut mencakup model transportasi, pembelajaran penguatan, dan LLM/VLM.
| Kelas metode dasar | Peran dalam perbandingan |
|---|---|
| Model transportasi | Baseline |
| Pembelajaran penguatan | Baseline |
| LLM/VLM | Baseline |
Studi ablasi mengonfirmasi efektivitas persepsi bersama, optimisasi tingkat jaringan, dan penalaran adaptif. Para penulis mencatat potensi model VLA untuk mengendalikan sistem transportasi fisik di dunia nyata.
Kriteria pemilihan: periksa komposisi metode dasar dan keberadaan studi ablasi. Eksperimen mencakup arus lalu lintas nyata dan tiga jaringan perkotaan. Kontribusi setiap komponen harus dikonfirmasi secara terpisah.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Anotasi gambar hibrida: otomatisasi mempercepat pelatihan model visi komputer
Artikel ini menjelaskan bagaimana praanotasi oleh algoritme mengurangi pekerjaan manual dan meningkatkan kebersihan kumpulan data pelatihan, serta mengapa verifikasi secara sampling oleh manusia tetap diperlukan. Artikel ini juga membahas keterbatasan metode tersebut dalam kondisi pengambilan gambar yang sulit dan pada jenis objek yang jarang ditemui.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026