
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
Pekerjaan dan status
- Judul: Pareto-Optimal RTL Code Generation via Multi-Objective Reinforcement Learning with Large Language Models.
- Penulis: Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa.
- Tanggal pengajuan: 16 Oktober 2026.
- Status: komentar menyebutkan bahwa makalah ini diterima di COLM 2026.
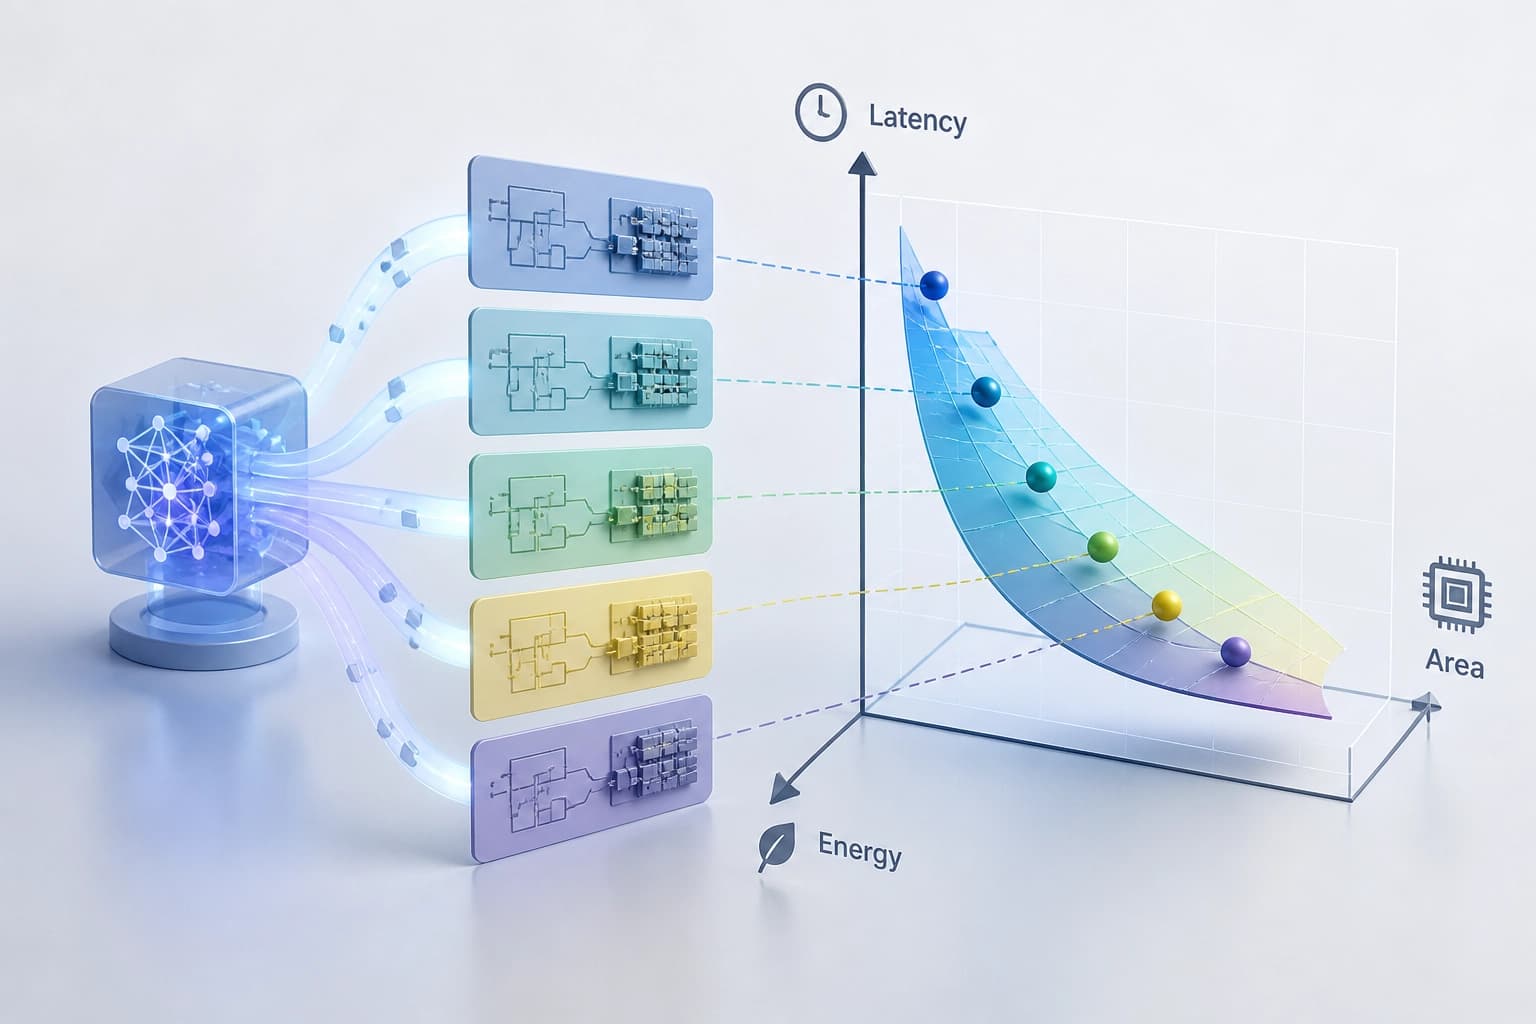
Pracetak tersedia sebagai arXiv:2610.26904. Makalah ini membahas generasi RTL menggunakan model bahasa besar. Metode ini melatih model untuk menghasilkan sekumpulan kandidat, bukan satu rangkaian saja. Sekumpulan kandidat ini dievaluasi dalam ruang PPA.
Kesimpulan: makalah ini diterima di COLM 2026 dan mengusulkan pendekatan multiobjektif untuk sintesis RTL dengan LLM. Pergeseran tujuan itu sendiri—dari satu rangkaian ke sekumpulan rangkaian—penting dalam memilih pendekatan.
Masalah dengan reward skalar
Pendekatan yang ada menggabungkan beberapa tujuan menjadi satu reward skalar. Akibatnya, sulit untuk sekaligus memperoleh solusi beragam yang optimal menurut Pareto. Berbagai kompromi antara konsumsi daya rendah, latensi rendah, dan area kecil sulit dicapai. Reward skalar menetapkan bobot tujuan sebelum generasi.
Tingkat kepentingan relatif setiap tujuan bergantung pada persyaratan produk dan batasan proyek. Reward yang telah ditetapkan sebelumnya tidak berubah mengikuti persyaratan tersebut. Karena itu, diperlukan sekumpulan kandidat dengan berbagai kompromi.
| Pendekatan | Yang dioptimalkan | Kapan kompromi dipilih |
|---|---|---|
| Reward skalar | Satu rangkaian berdasarkan gabungan tujuan | Sebelum generasi |
| Pendekatan multiobjektif | Sekumpulan rangkaian pada front Pareto | Setelah generasi |
Kesimpulan: reward skalar menetapkan kompromi sebelum generasi. Formulasi multiobjektif memindahkan pemilihan ke tahap setelah generasi.
Yang dioptimalkan oleh metode ini
Metode ini mengoptimalkan kualitas dan keragaman seluruh kumpulan rangkaian. Kumpulan tersebut dihasilkan melalui beberapa proses generasi. Evaluasi dilakukan dalam ruang tujuan PPA: Power, Performance, Area. Metode ini tidak berfokus pada kualitas satu rangkaian.
Tujuan PPA memiliki kompromi satu sama lain. Rangkaian yang berbeda menghasilkan kombinasi konsumsi daya rendah, latensi rendah, dan area kecil yang berbeda. Karena itu, metode ini melatih model agar mencakup berbagai titik pada front Pareto. Perancang mendapatkan beberapa kandidat.
Kesimpulan: metode ini berfokus pada cakupan front, bukan pada satu jawaban terbaik.
Dua elemen metode
Pipeline pelatihan berbasis generasi
Pipeline ini mengubah peningkatan cakupan seluruh himpunan solusi Pareto menjadi tugas generasi rangkaian yang berurutan. Pelatihan dilakukan secara bertahap. Tugas generasi memiliki struktur berurutan.
Reward berbasis Hypervolume Contribution
Fungsi reward HVC mengukur kontribusi rangkaian yang dihasilkan terhadap front Pareto. Reward ini mencerminkan peningkatan cakupan, bukan kualitas absolut dari satu rangkaian. HVC menghubungkan pelatihan dengan cakupan front.
Kesimpulan: pipeline menentukan urutannya, sedangkan HVC memberikan sinyal atas kontribusi terhadap cakupan.
Hasil pada RTLLM v2
Evaluasi pada benchmark RTLLM v2 menunjukkan peningkatan Hypervolume relatif. Dibandingkan dengan varian dasar tanpa optimasi PPA, peningkatannya sebesar +13,3 poin persentase. Dibandingkan dengan metode RL satu tujuan, peningkatannya sebesar +14,4 poin persentase. Penulis juga melaporkan keunggulan dalam keragaman rangkaian.
| Perbandingan | Peningkatan Hypervolume relatif |
|---|---|
| Varian dasar tanpa optimasi PPA | +13,3 poin persentase |
| Metode RL satu tujuan | +14,4 poin persentase |
Kesimpulan: pada RTLLM v2, metode ini meningkatkan cakupan front dan keragaman. Angka-angka tersebut merujuk pada Hypervolume relatif, bukan kualitas absolut setiap rangkaian.
Kriteria praktis untuk memilih
Pendekatan dipilih berdasarkan kapan kompromi ditetapkan. Reward skalar mengharuskan bobot PPA ditentukan sebelum generasi. Pendekatan multiobjektif memindahkan pemilihan ke tahap setelah generasi. Pendekatan ini menghasilkan sekumpulan kandidat dengan berbagai kompromi.
Evaluasi metode ini terbatas pada benchmark RTLLM v2. Alur desain lain memerlukan pengujian tersendiri. Angka peningkatan tidak dapat diterapkan pada kondisi lain tanpa pengujian.
Kesimpulan: jika persyaratan PPA berubah dari satu produk ke produk lain, pendekatan multiobjektif sesuai untuk memilih setelah generasi. Jika bobot tujuan sudah diketahui dan tetap, reward skalar sesuai untuk kasus dengan kompromi yang ditetapkan sebelumnya.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026
Model dunia untuk agen berbasis LLM tertutup: koreksi pada titik risiko
PAWM diusulkan sebagai prediktor eksternal yang tidak menduplikasi observasi langkah demi langkah, tetapi aktif saat kegagalan mungkin terjadi dan mengarahkan agen menjauhi tindakan yang keliru. Setelah SFT pada skenario sintetis dan pelatihan bersama GRPO, metode ini menghasilkan peningkatan 24,3% di ScienceWorld dan 7,7% di WebArena-Lite untuk Claude Sonnet 4.5.
4 November 2026