
Cara melatih segmentasi bahasa pada USG ketika data berlabel hampir tidak ada
Para peneliti mengusulkan metode adaptasi model terhadap kumpulan gambar USG baru tanpa akses ke data asli: metode ini menggabungkan penyempurnaan pseudo-labeling, kontrol kualitas kontur, dan generasi gambar sintetis bergaya domain target. Pendekatan ini secara signifikan meningkatkan akurasi segmentasi bahkan saat dimulai hanya dengan lima frame berlabel.
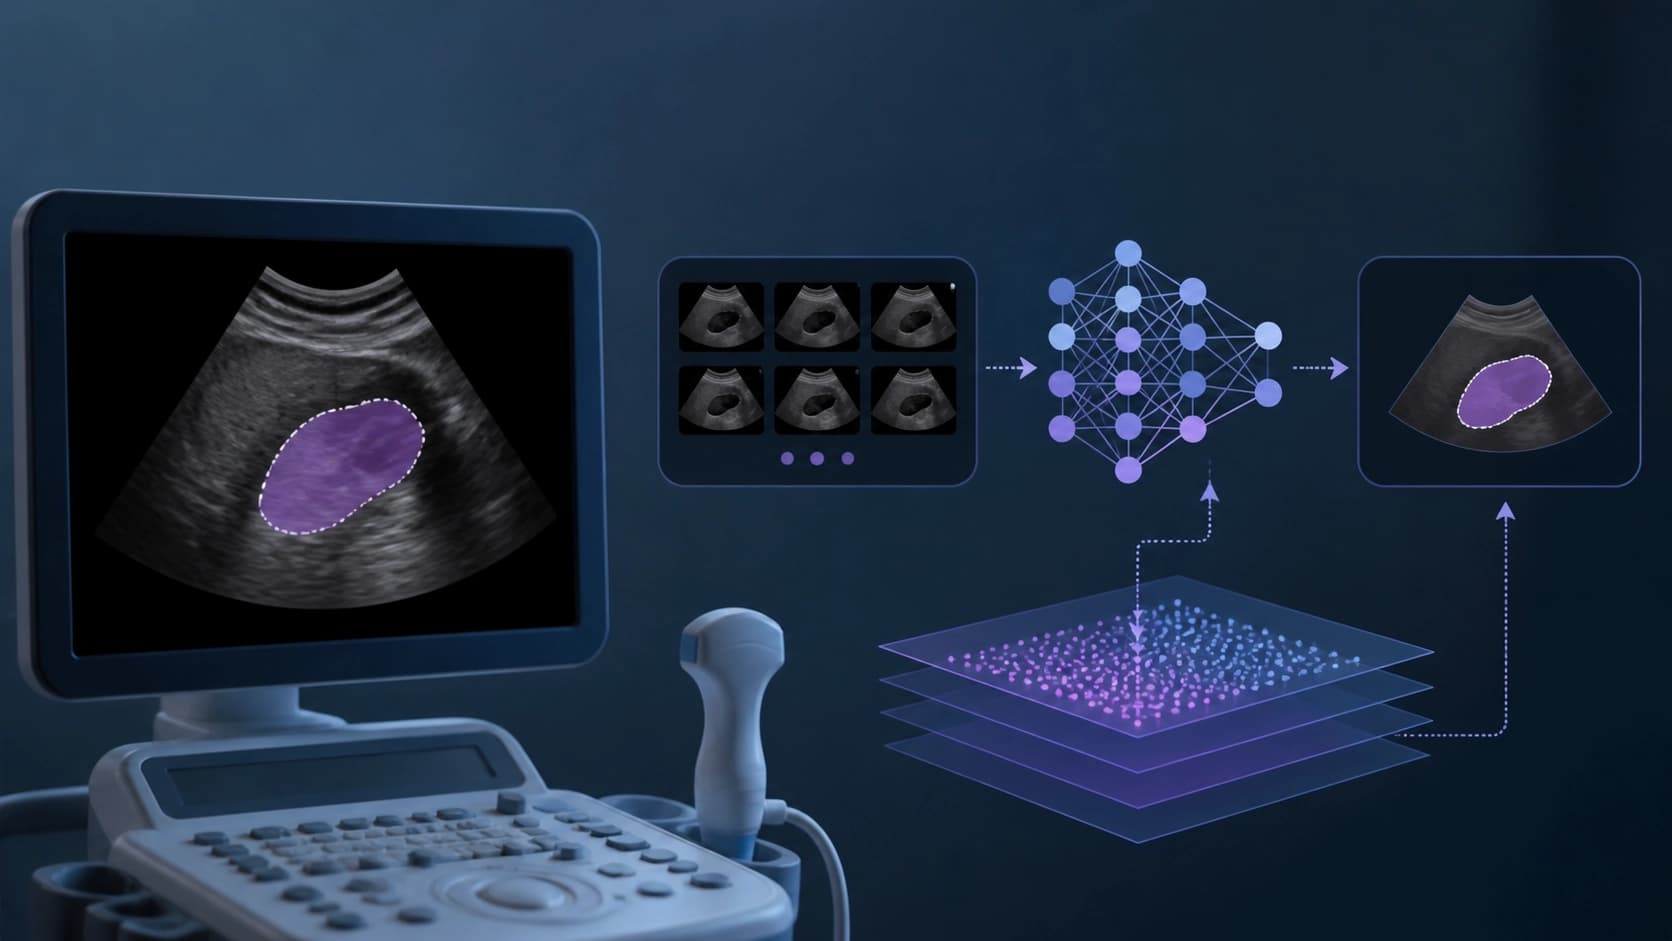
Segmentasi lidah pada citra ultrasonografi diperlukan untuk menganalisis artikulasi dan mendiagnosis gangguan bicara, tetapi mengumpulkan data yang berlabel itu sulit: dibutuhkan para ahli, dan citra yang dihasilkan sangat bervariasi antar perangkat. Ketika data berlabel hampir tidak ada, pelatihan jaringan saraf standar tidak berfungsi: model menghafal karakteristik sumber tertentu dan tidak dapat menggeneralisasi ke kondisi baru.
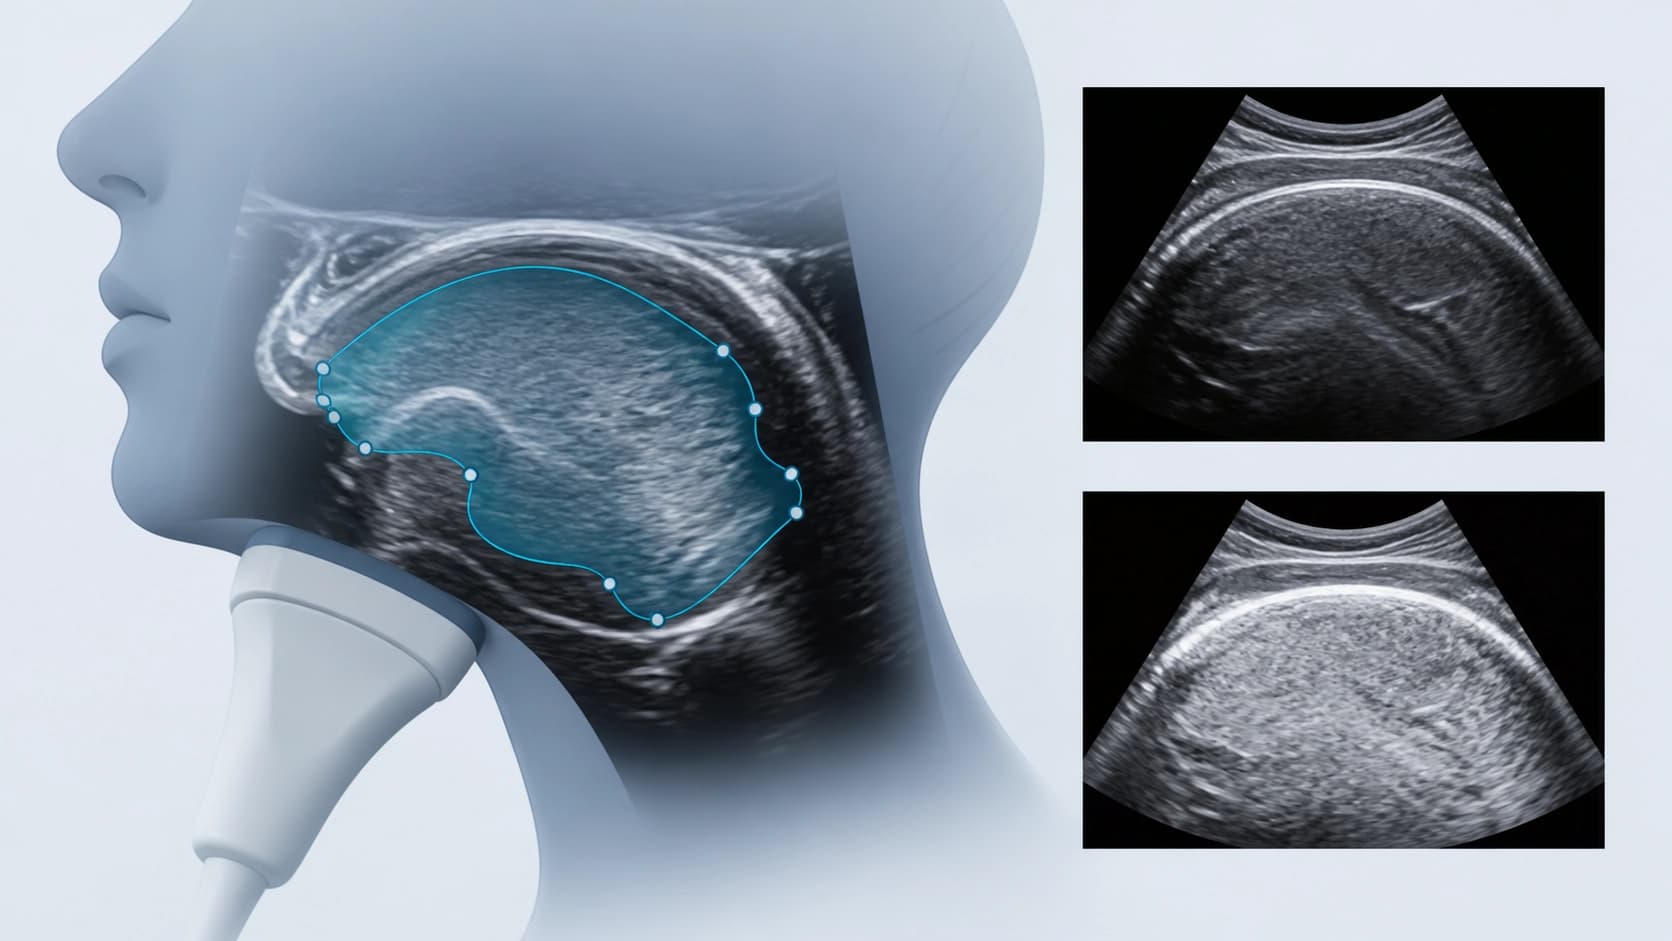
Mengapa Ini Sulit
Masalahnya bukan hanya pada sedikitnya jumlah anotasi. Data USG lidah dikumpulkan dengan sensor yang berbeda, pengaturan yang berbeda, dan dari orang yang berbeda, sehingga distribusi citra pada setiap kumpulan data baru berbeda-beda. Ini disebut domain shift. Jika model dilatih pada satu kumpulan data lalu diterapkan ke kumpulan data lain, kualitas segmentasi akan menurun drastis. Metode adaptasi klasik memerlukan akses ke data berlabel dari domain sumber, tetapi dalam tugas nyata sering kali hanya tersedia model yang sudah dilatih sebelumnya dan citra tanpa label dari domain baru.
Ide: Adaptasi Source-Free
Para penulis penelitian terbaru mengusulkan kerangka kerja yang mengadaptasi model ke domain baru tanpa data berlabel sama sekali dan tanpa akses ke citra sumber. Sebagai dasar, mereka menggunakan backbone ringan UltraUNet, yang dilatih sebelumnya hanya pada lima citra berlabel. Ini adalah titik awal yang sengaja dibuat lemah — untuk mensimulasikan situasi ketika model kurang terlatih karena kekurangan data. Selanjutnya, dilakukan adaptasi ke domain target, di mana tidak ada contoh berlabel sama sekali.
Pseudo-Label dengan Penyaringan
Pertama, model membuat prediksi pada citra target. Masker kasar ini disebut pseudo-label. Tetapi tidak semuanya bisa dipercaya: sebagian kontur akan tidak akurat atau bahkan salah. Oleh karena itu, kerangka kerja ini menggunakan modul kontrol kualitas kontur khusus yang menyaring masker yang tidak dapat diandalkan. Pseudo-label bersih yang tersisa digunakan untuk pelatihan. Proses ini diulang secara iteratif — dengan setiap siklus, kualitas label meningkat, dan model semakin beradaptasi dengan domain target.
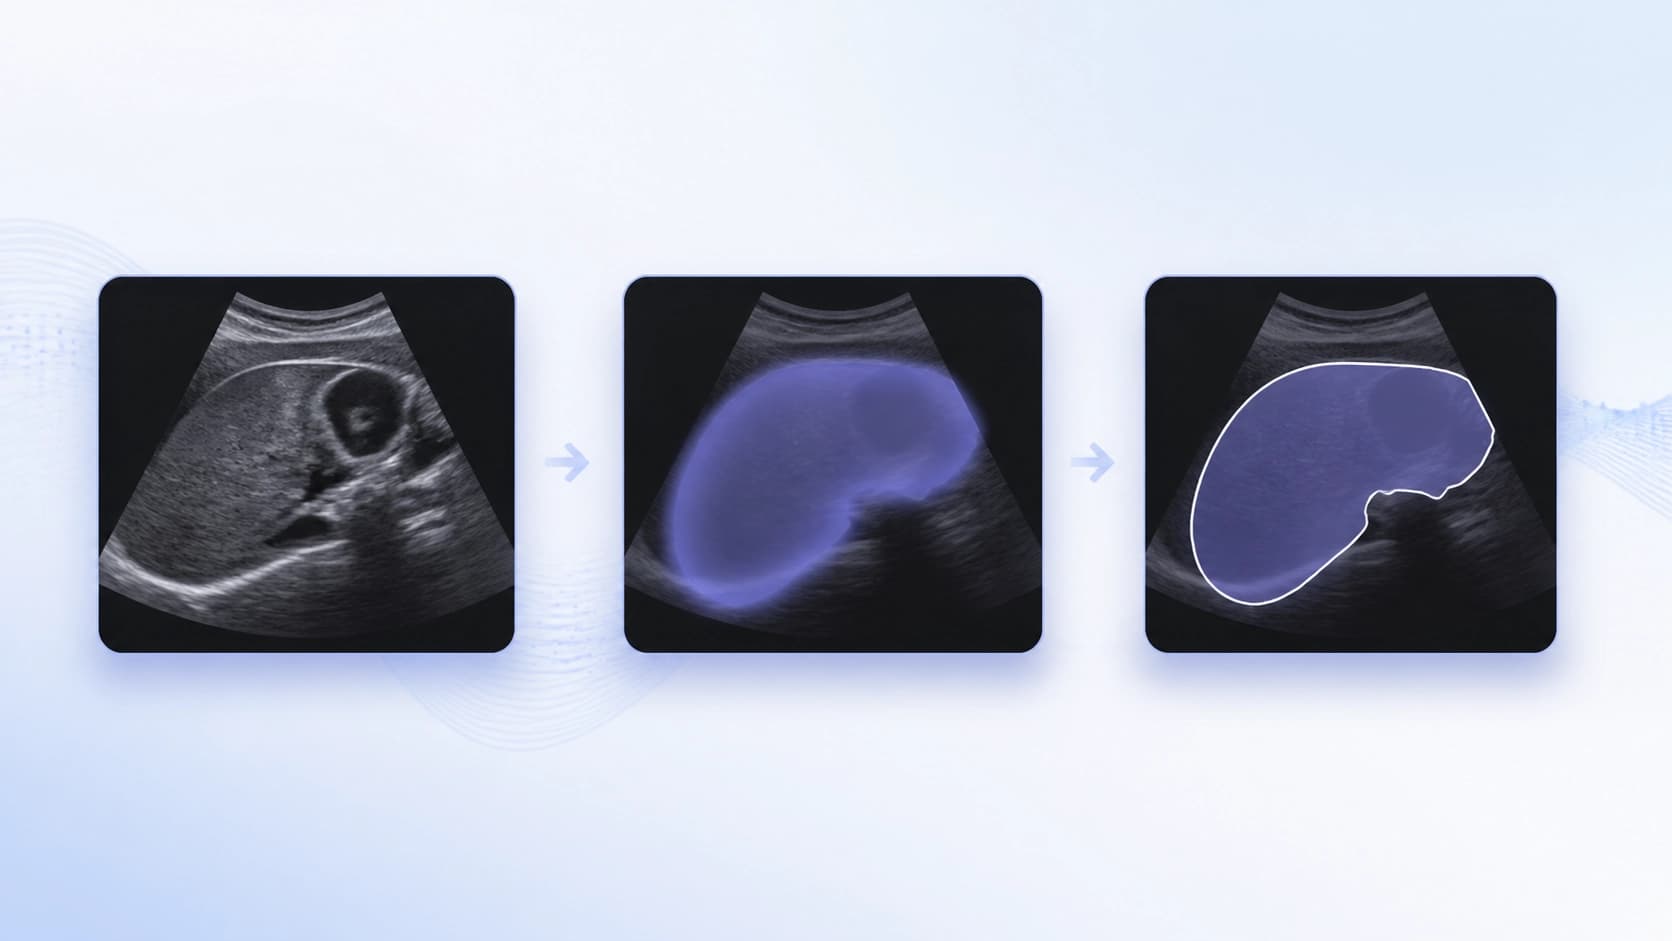
Data Sintetis dengan Gaya Target
Selain itu, digunakan GAN kondisional yang dikendalikan segmentasi untuk menghasilkan pasangan sintetis "citra-masker" dengan gaya domain target. Ini mirip dengan augmentasi, tetapi data dibuat bukan melalui transformasi acak, melainkan secara khusus disesuaikan dengan gaya domain baru. Model siswa dilatih pada campuran tiga sumber: citra target dengan pseudo-label bersih, pseudo-label berisik dengan regularisasi konsistensi, dan sampel sintetis yang dihasilkan. Campuran ini membuat model tahan terhadap kesalahan dan membantunya tidak overfit pada noise.
Hasil
Metode ini diuji pada 12 pasangan "sumber-target" yang disusun dari delapan kumpulan data USG lidah. Dalam semua eksperimen, kerangka kerja yang diusulkan mengungguli pendekatan dasar, termasuk pelatihan terawasi biasa pada data terbatas. Tumpang tindih segmentasi (overlap) dan akurasi kontur juga meningkat. Para penulis menyimpulkan bahwa penyempurnaan pseudo-label dan augmentasi sintetis dengan gaya domain target adalah komponen kunci yang memungkinkan adaptasi hampir tanpa pelabelan.
Pendekatan ini membuka jalur praktis: cukup melatih model sekali pada kumpulan data kecil, lalu secara bertahap mengadaptasinya ke kondisi baru — sensor baru, posisi sensor yang berbeda, atau populasi pasien yang berbeda — tanpa pelabelan manual yang memakan waktu.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
OpenCollab: koordinasi agen yang dapat diprogram, lingkungan eksekusi terkontrol, dan metrik kepatuhan terhadap kebijakan
Framework ini menyatukan penetapan struktur interaksi agen, lingkungan eksperimen bersama, dan pelacakan peristiwa yang terperinci, sementara metrik Adherence yang diperkenalkan menunjukkan sejauh mana pelaksanaan aktual sesuai dengan skema yang dinyatakan. Dalam benchmark, konfigurasi Duo mencapai tingkat SOTA baru, sedangkan varian agen tunggal memiliki konsumsi token terendah.
11 November 2026
Toollery: memilih alat untuk agen LLM dari puluhan ribu opsi tanpa fine-tuning
Toollery membangun indeks pencarian berdasarkan deskripsi keterampilan dan alat, lalu saat ada permintaan hanya meneruskan sekumpulan kandidat terbatas ke model. Dalam eksperimen pada pustaka berskala hingga puluhan ribu fungsi, pendekatan ini mampu mempertahankan kualitas pemilihan dengan top-K tetap, meskipun dampak akhirnya bergantung pada profil beban dan caching di penyedia.
11 November 2026
Diagnostik bertahap agen GUI dalam analisis dasbor: benchmark DashAct
DashAct diperkenalkan sebagai tolok ukur yang terdiri atas 348 trajektori yang diverifikasi manusia, yang menguraikan kerja agen GUI dengan panel interaktif menjadi tiga tahap dan empat kondisi visual. Hasilnya menunjukkan masalah yang terus berulang dalam memprediksi tindakan dan mengaitkannya dengan target visual, serta ketergantungan respons agen pada dukungan kontekstual dan spasial.
11 November 2026