
SPARSEUP dari Linkup: encoder sparse dengan 149 juta parameter
Artikel ini membahas arsitektur SPARSEUP dan hasilnya: 56,4 nDCG@10 pada BEIR-13, serta recall lebih dari 97% saat dipasangkan dengan indeks Seismic, dengan waktu sekitar 380 mikrodetik per kueri. Ulasan ini mencakup teknik untuk mempertahankan sparsitas vektor, perbandingan dengan model lain, dan ketentuan distribusi berdasarkan Apache 2.0.
Apa itu model dan cara mengaksesnya
SPARSEUP adalah encoder sparse terbuka dari Linkup Research dengan 149 juta parameter. Backbone-nya adalah ModernBERT, dengan lisensi Apache 2.0.
Bobot tersedia di Hugging Face. Model dapat dimuat melalui Transformers atau Sentence Transformers dengan mencantumkan trust_remote_code=True.
Linkup menyebut model ini sebagai encoder sparse berbasis kosakata publik terkuat yang diketahui perusahaan di antara model dengan jumlah parameter kurang dari 150 juta.
Cara kerja representasi sparse
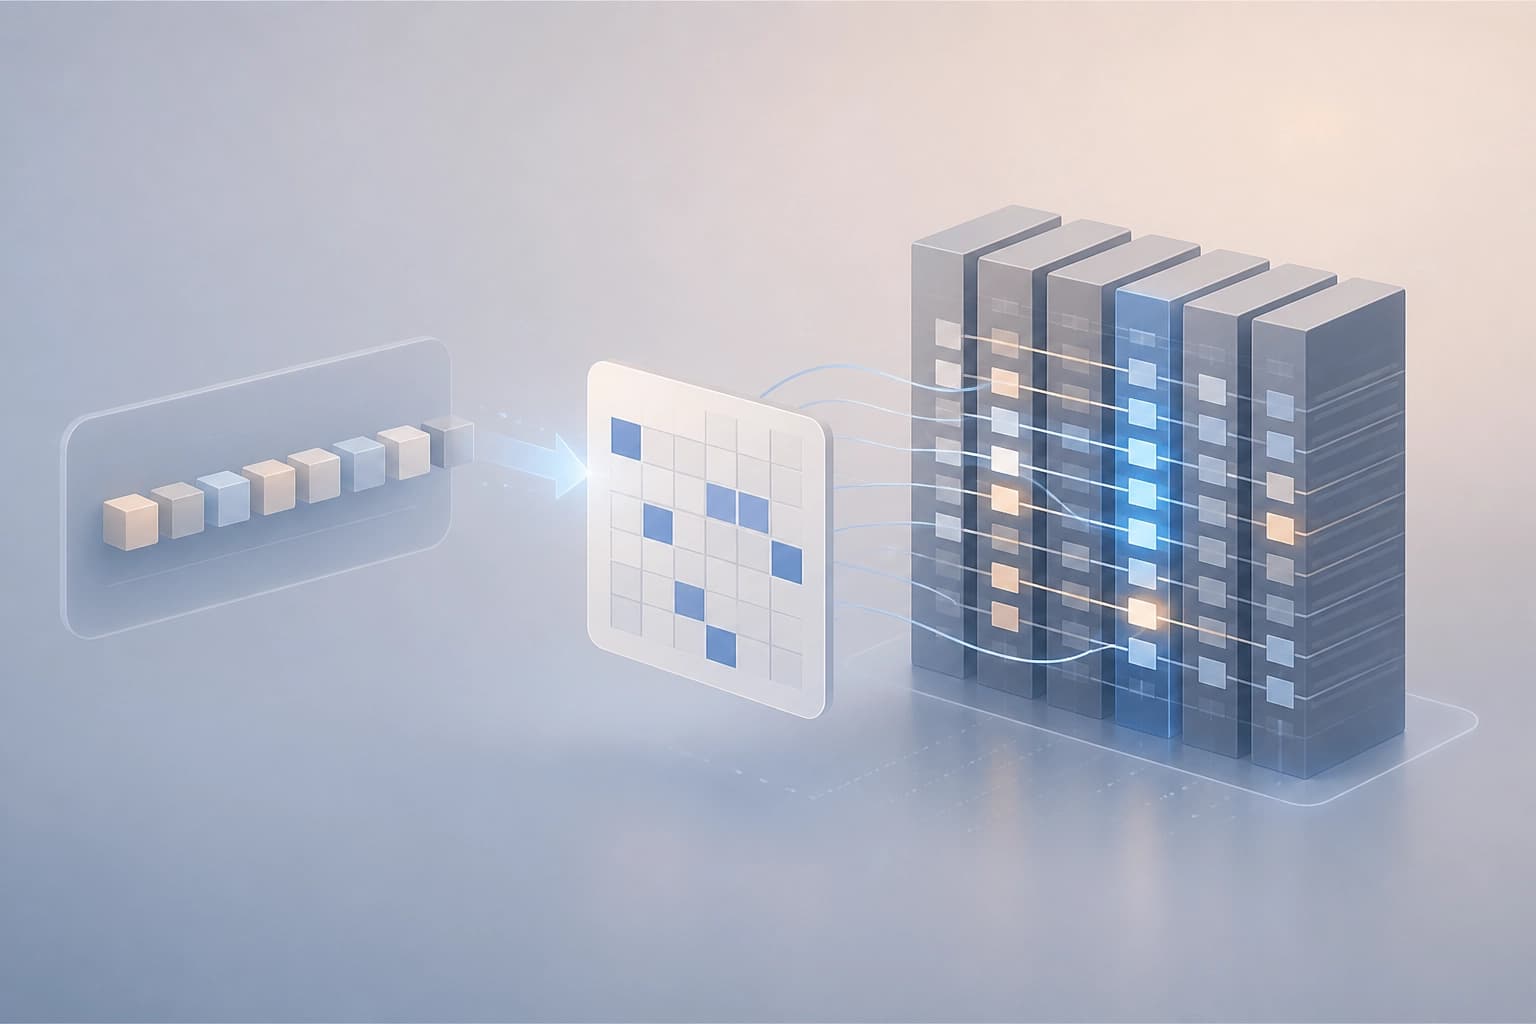
Dalam SPARSEUP, setiap dimensi vektor berkorespondensi dengan sebuah token kosakata. Vektor seperti ini cocok untuk indeks terbalik dan lebih baik dalam mencocokkan kata-kata langka.
Model menghitung aktivasi dengan rumus log(1 + ReLU(x - 15)). Kemudian, untuk setiap token masukan, model mempertahankan 12 dimensi terkuat sebelum max pooling.
Hal ini membatasi jumlah dimensi aktif per token, bukan ukuran vektor secara keseluruhan. Case folding menyatukan varian Byte-level BPE, seperti heat, Heat, Ġheat dan ĠHeat, dengan mempertahankan bobot tertinggi.
Setelah penyatuan, jumlah dimensi keluaran berkurang dari sekitar 50 ribu menjadi 34 ribu. Awalan [Q] dan [D] ditambahkan pada kueri dan dokumen; penilaian dilakukan dengan hasil kali skalar.
Panjang maksimum saat penilaian adalah 128 token untuk kueri dan 512 untuk dokumen. Batasan ini penting saat mengatur pemrosesan masukan.
Cara model dilatih
Pelatihan SPARSEUP dimulai dari checkpoint LateOn-unsupervised. Tim mengembalikan head MLM ModernBERT asli.
Untuk fine-tuning, tim menggunakan campuran data LightOn dan hanya menerapkan pelatihan kontrastif. Untuk setiap kueri, tujuh hard negative dipilih dari kumpulan berisi 50, dan in-batch negative juga digunakan.
Tim tidak menerapkan distilasi cross-encoder. Pelatihan diselesaikan dengan satu H100.
Hasil perbandingan
Rata-rata hasil SPARSEUP pada BEIR-13 tanpa MS MARCO adalah 56,4 nDCG@10. Model card mencantumkan hasil encoder sparse berikut:
| Model | BEIR-13, nDCG@10 |
|---|---|
| SPARSEUP | 56,4 |
| opensearch-neural-sparse-encoding-doc-v3-gte | 54,6 |
| opensearch-neural-sparse-encoding-v1 | 52,44 |
| ModernBERT-VT | 52,4 |
| splade-v3 | 51,7 |
| granite-embedding-30m-sparse | 50,6 |
LACONIC-1B meraih 58,7, tetapi termasuk dalam kelompok ukuran yang berbeda: model ini memiliki 1 miliar parameter.
Dalam perbandingan terkontrol dengan backbone dan data yang sama, LateOn meraih 58,9, DenseOn 57,9, sedangkan SPARSEUP 56,4. Kesimpulan artikel menyebutkan selisih 1,52 poin di bawah DenseOn dan 2,5 poin di bawah LateOn.
SPARSEUP mengungguli DenseOn pada ArguAna dan HotpotQA, serta menunjukkan hasil lebih baik pada Touché. Pada kumpulan data dengan kueri yang lebih semantis, model ini tertinggal; hal ini terutama terlihat pada FiQA. DBPedia juga disebut sebagai kelemahannya.
Pada BEIR yang telah didekontaminasi, selisih dengan DenseOn menyusut menjadi 0,17 poin. Untuk NQ dan MS MARCO yang telah didekontaminasi, masing-masing hanya digunakan 21 dan 46 kueri, sehingga Linkup memperingatkan bahwa hasilnya rentan terhadap noise.
Sparsitas dan kriteria pemilihan
Pada MS MARCO, SPARSEUP menggunakan rata-rata 47 term nonnol per kueri dan 190 per dokumen. Untuk SPLADE-v3, tercatat 25 term per kueri dan 170 per dokumen.
Dengan indeks terbalik Seismic, model mencapai recall lebih dari 97% dibandingkan exact search dengan waktu sekitar 380 mikrodetik per kueri dalam satu thread.
SPARSEUP patut dipertimbangkan jika representasi sparse dan pencarian melalui indeks terbalik menjadi prioritas. Saat mengevaluasinya, hasil pada kumpulan data yang relevan juga perlu diperhatikan: model ini lebih lemah pada kueri semantis, FiQA, dan DBPedia.
Linkup menilai bahwa memperbesar ukuran vektor dapat meningkatkan hasil BEIR sebanyak 1–2 poin. Tim memutuskan untuk mempertahankan sparsitas model.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026