
RLTLDR: agen merumuskan sendiri pelajaran dari kegagalan dan menerapkannya pada percobaan berikutnya
Setelah gagal, agen diperlihatkan sinyal dari verifikator dan diminta merangkumnya menjadi satu petunjuk; pelatihan berlangsung menggunakan pasangan “tugas — petunjuk”, tanpa pengajar maupun solusi acuan. Pada benchmark yang sulit untuk pemrograman dan pemanggilan alat, metode ini meningkatkan Pass@1 dari 0–1% pada GRPO menjadi 12–31%, dengan kontribusi penentu berasal dari pembelajaran pasangan tersebut.
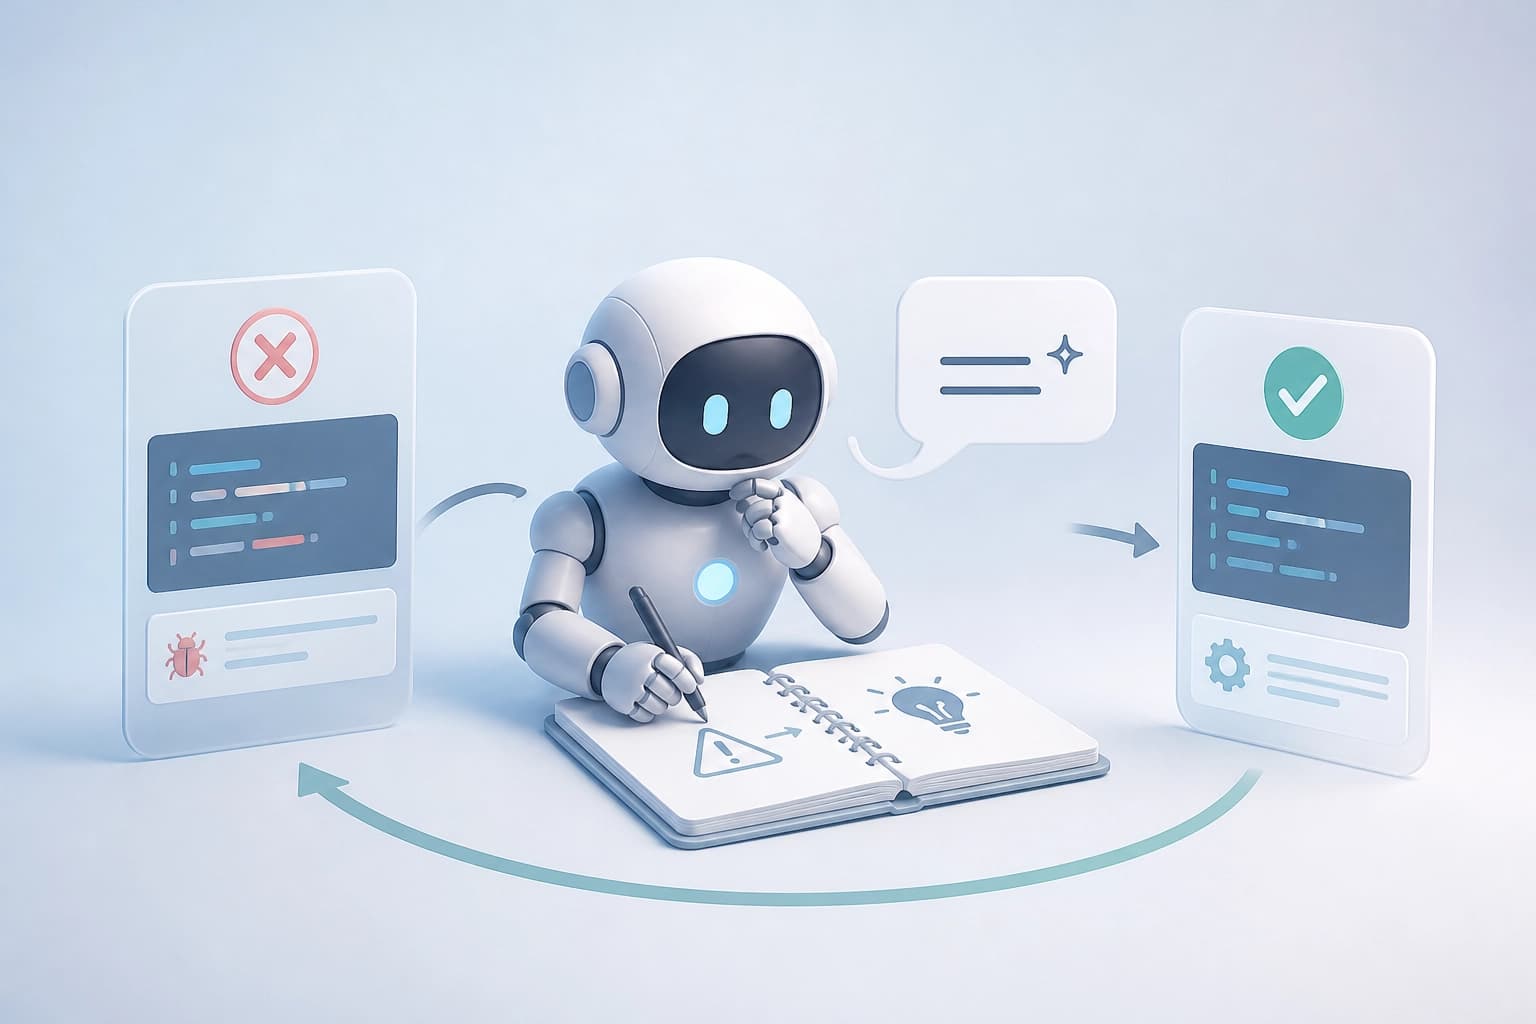
RLTLDR adalah metode untuk meningkatkan kemampuan agen secara mandiri pada tugas yang sulit diselesaikan dengan sukses. Setelah percobaan gagal, agen melihat keluaran verifier dan merumuskan sendiri satu kesimpulan singkat — TL;DR insight. Percobaan berikutnya mempertimbangkan semua kesimpulan sebelumnya. Karya Michael Kirchhof, Eleonora Gualdoni, Andrew Szot, dan rekan-rekannya menguraikan pendekatan ini. Versi pertama diajukan pada 29 September 2026. Revisi terakhir pada 19 Oktober 2026.
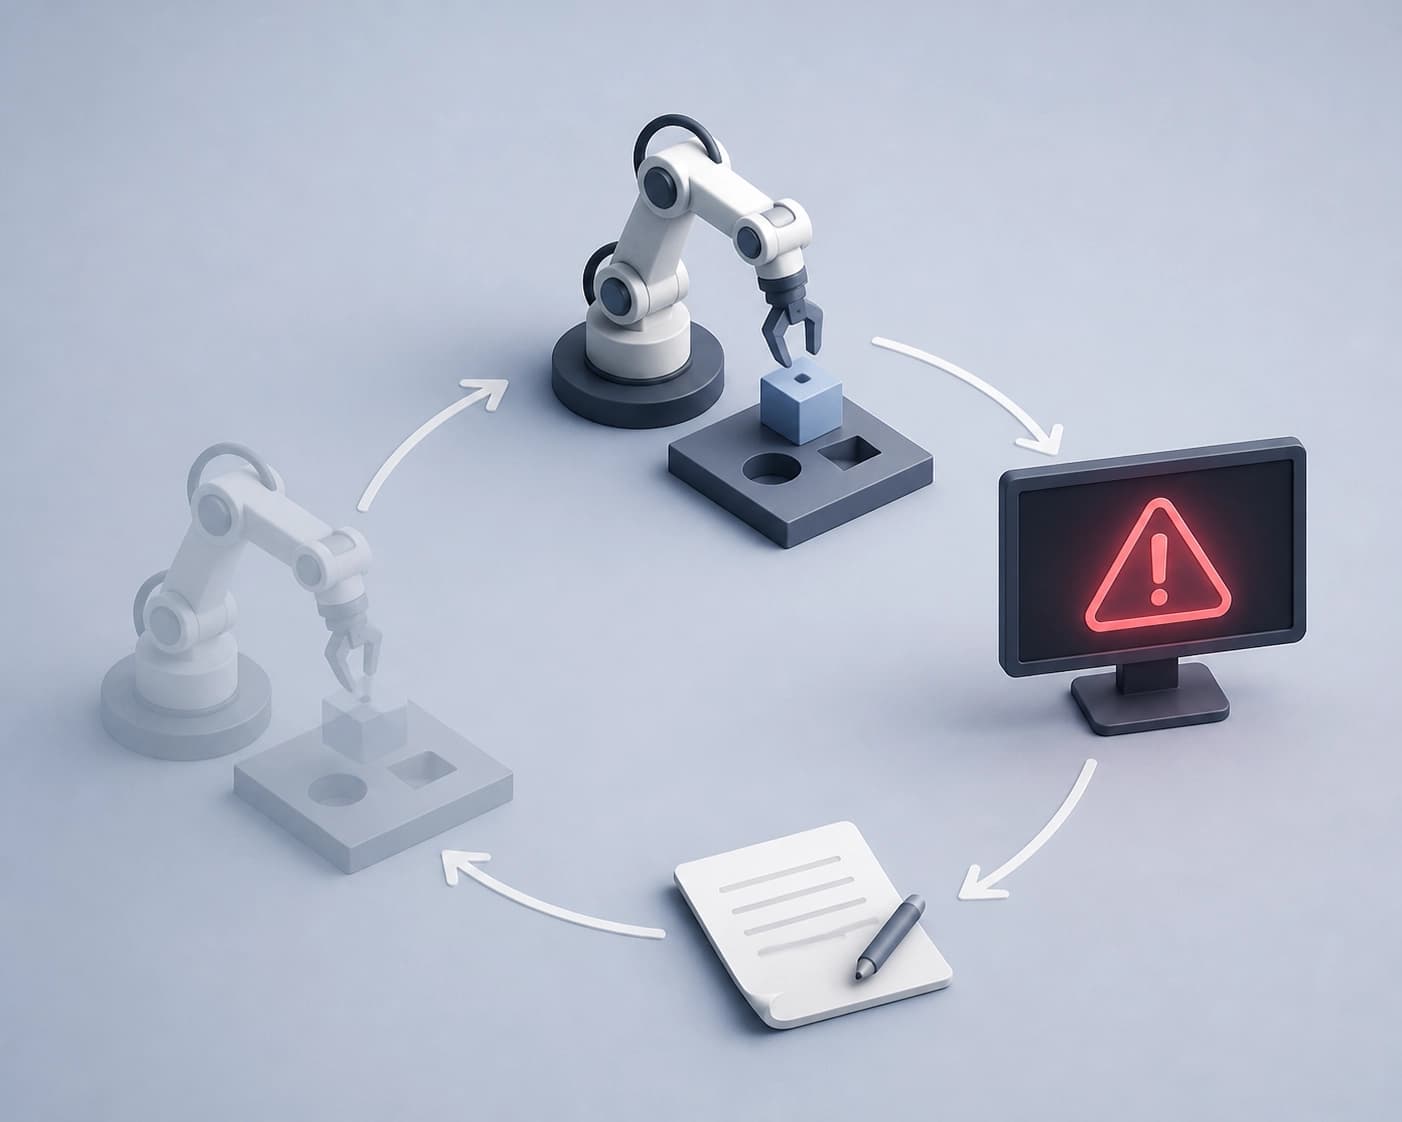
Masalah yang diatasi RLTLDR
RLTLDR ditujukan untuk meningkatkan kemampuan agen secara mandiri. Pada tugas semacam ini, agen sulit mencapai keberhasilan. Tidak ada model guru maupun contoh solusi untuk distilasi. Karena itu, kegagalan dan keluaran verifier menjadi sumber umpan balik.
Kondisi tugas:
- tidak ada model guru;
- tidak ada contoh solusi untuk distilasi;
- agen sulit mencapai keberhasilan;
- keluaran verifier tersedia setelah kegagalan.
Kesimpulan: RLTLDR dibutuhkan ketika tidak ada solusi siap pakai dan guru, tetapi kegagalan dapat diverifikasi. Kriteria praktisnya adalah adanya verifier yang keluarannya dapat diberikan kepada agen.
Cara kerja siklus
Siklus RLTLDR berpusat pada percobaan yang dilakukan secara berurutan. Setiap kegagalan menyediakan bahan untuk langkah berikutnya.
Tahapan:
- Agen menjalankan rollout dan gagal.
- Agen melihat keluaran verifier.
- Agen merumuskan umpan baliknya sendiri — satu TL;DR insight singkat.
- Rollout berikutnya mempertimbangkan semua kesimpulan sebelumnya.
- Rollout berlanjut secara berurutan hingga solusi ditemukan.
- Pelatihan dengan backpropagation atas keluaran dalam konteks mempelajari pemetaan «tugas → kesimpulan».
Kesimpulan: nilai siklus ini bukan hanya petunjuk untuk percobaan berikutnya. Faktor utamanya adalah mempelajari hubungan antara tugas dan kesimpulan.
Hasil pada tugas-tugas sulit
Pengujian dilakukan pada kumpulan data sulit untuk tool-calling dan coding. Para penulis menyaring kumpulan data berdasarkan kriteria Pass@128=0. Perbandingan menggunakan kebijakan Qwen 3.5 9B Thinking.
| Pendekatan | Kondisi evaluasi | Pass@1 |
|---|---|---|
| Pelatihan GRPO standar | Tanpa siklus kesimpulan yang dijelaskan | 0–1% |
| RLTLDR | Kesimpulan tersedia dalam konteks selama pelatihan | 14–31% |
| RLTLDR | Tidak ada kesimpulan dalam konteks selama evaluasi | 12–13% |
Pelatihan GRPO standar tetap berada pada tingkat Pass@1 dari 0% hingga 1%. RLTLDR mencapai 14–31% ketika kesimpulan tersedia dalam konteks selama pelatihan. Tanpa kesimpulan dalam konteks selama evaluasi, hasilnya mencapai 12–13%. Para penulis menyoroti pembelajaran pemetaan «tugas → kesimpulan» sebagai faktor utama.
Kesimpulan: kesimpulan dalam konteks meningkatkan Pass@1. Untuk menguji apakah pemetaan telah dipelajari, evaluasi metode ini dengan dan tanpa kesimpulan.
SFTLDR: pelatihan dengan pasangan «tugas — kesimpulan»
SFTLDR adalah varian pelatihan yang ringkas. Metode ini hanya belajar dari pasangan (tugas, kesimpulan). Rollout dan backpropagation atas rollout tidak digunakan.
Yang diketahui tentang SFTLDR:
- pelatihan hanya menggunakan pasangan (tugas, kesimpulan);
- SFTLDR tidak menggunakan rollout;
- SFTLDR tidak menerapkan backpropagation atas rollout;
- pelatihan dengan 4k pasangan semacam ini memulihkan hampir seluruh kinerja RLTLDR;
- SFTLDR hampir menyamai kinerja SFT klasik pada rollout lengkap;
- para penulis menjelaskan pendekatan ini sebagai paradigma ringkas: «untuk tugas seperti ini, ingatlah hal-hal seperti ini».
Kesimpulan: SFTLDR adalah varian untuk pelatihan ringkas. Kriterianya: mengujinya ketika pasangan «tugas — kesimpulan» dapat dikumpulkan.
Kriteria penerapan
RLTLDR memerlukan umpan balik yang dapat diverifikasi dan percobaan yang dilakukan secara berurutan. Tanpa kondisi ini, siklusnya tidak dapat dibangun. Kriteria di bawah ini membantu menilai apakah metode ini dapat diterapkan.
Kriteria:
- tugas memungkinkan percobaan yang gagal dan rollout berulang;
- ada verifier yang keluarannya dapat ditunjukkan kepada agen;
- agen mampu merumuskan satu kesimpulan singkat;
- percobaan berikutnya mempertimbangkan semua kesimpulan sebelumnya;
- evaluasi mencakup mode tanpa kesimpulan dalam konteks jika penting untuk menguji apakah pemetaan telah dipelajari.
Kesimpulan: RLTLDR dipilih untuk tugas yang memiliki verifier dan sulit diselesaikan dengan sukses. SFTLDR dipilih ketika diperlukan mode ringkas dengan pasangan «tugas — kesimpulan».
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan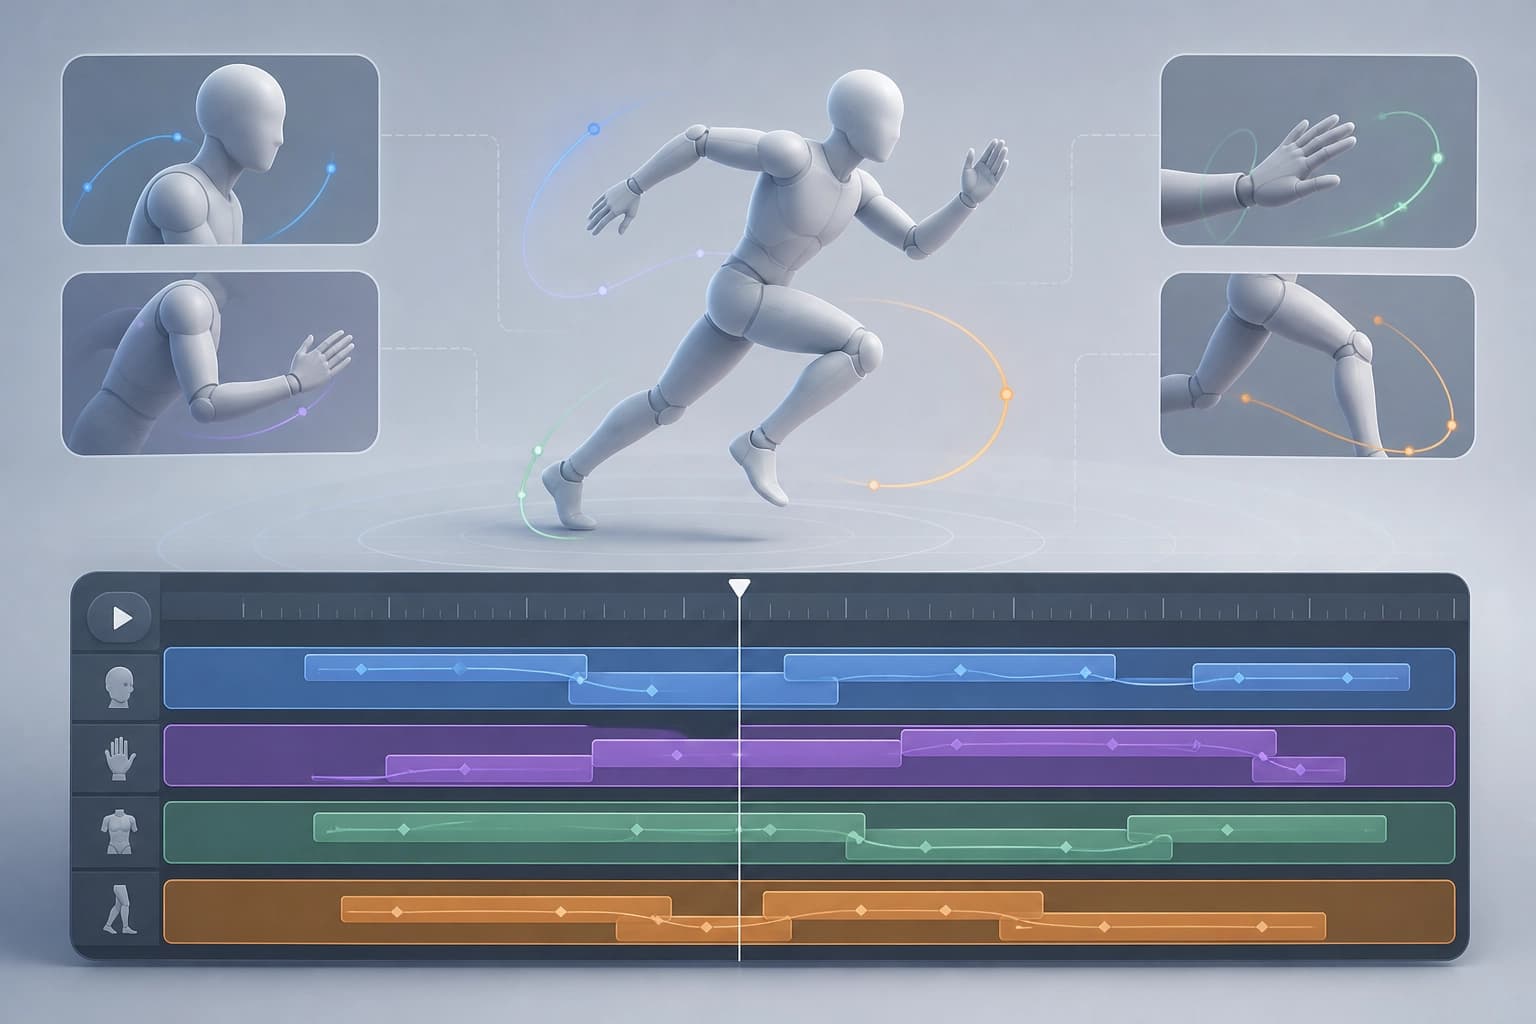
Kontrol baru selama proses sintesis: linimasa multitrack untuk gerakan manusia 3D
Metode yang diusulkan menerima instruksi teks baru bahkan saat sintesis berlangsung dan memungkinkan penentuan rentang aksi yang saling tumpang tindih secara independen. Koordinasi gerakan serentak pada berbagai bagian tubuh dijamin melalui pengondisian interval dan prosedur denoising yang mempertimbangkan bagian tubuh; pada TimelineMotion dan MTT, penulis melaporkan kesesuaian yang lebih baik terhadap semantik dan batasan waktu dibandingkan solusi streaming dasar.
12 November 2026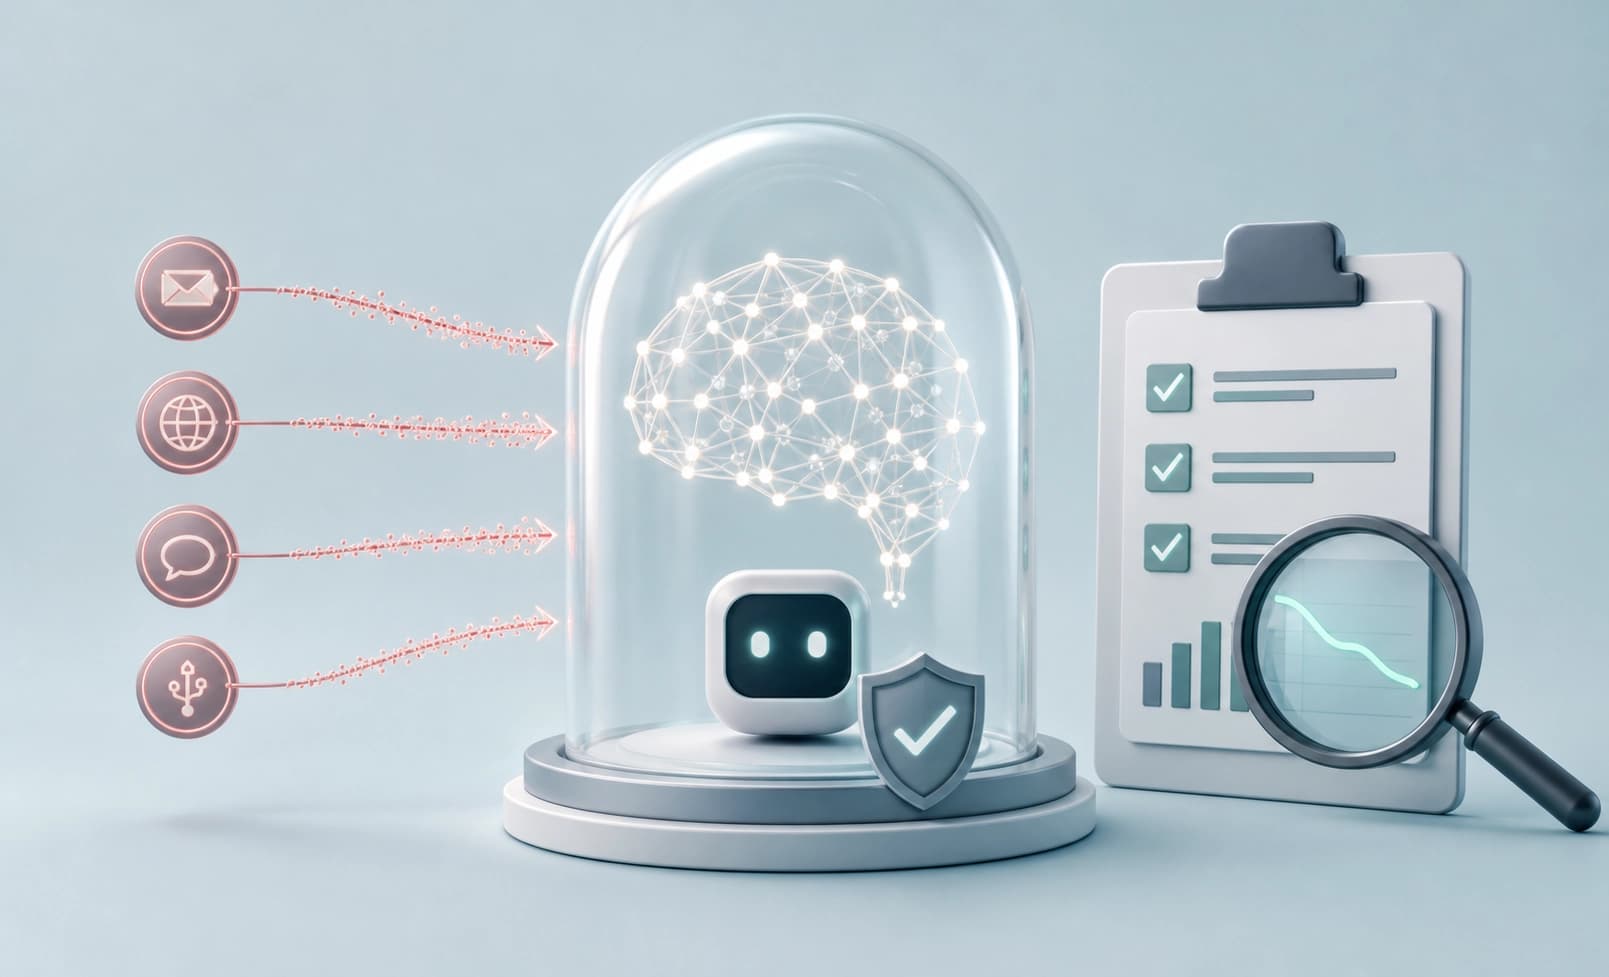
COPEX membantu membedakan kerentanan model dari kelemahan infrastruktur MCP
Benchmark terkontrol ini menetapkan kerangka kerja agen dan hanya menilai pemilihan alat oleh model bahasa dalam 125 skenario serangan melalui empat kanal MCP. Dalam 3.375 uji coba pada sembilan model, rata-rata tingkat keberhasilan serangan mencapai 64,4%, sementara pemeriksaan bersama terhadap input dan konteks menurunkannya hampir separuh.
12 November 2026
Koreksi probabilistik prakiraan gelombang: BridgeCast menghubungkan model fisik dengan reanalisis melalui pencocokan streaming
Disajikan sebuah metode hibrida yang menggunakan pencocokan aliran bersyarat, arsitektur transformer, dan fitur atmosfer eksogen untuk mengubah keluaran model fisik gelombang menjadi medan yang mendekati hasil reanalisis. Para penulis melaporkan keunggulan yang konsisten dibandingkan solusi baseline mutakhir sebelumnya pada berbagai jangka waktu prakiraan dan di berbagai wilayah.
12 November 2026