
COPEX membantu membedakan kerentanan model dari kelemahan infrastruktur MCP
Benchmark terkontrol ini menetapkan kerangka kerja agen dan hanya menilai pemilihan alat oleh model bahasa dalam 125 skenario serangan melalui empat kanal MCP. Dalam 3.375 uji coba pada sembilan model, rata-rata tingkat keberhasilan serangan mencapai 64,4%, sementara pemeriksaan bersama terhadap input dan konteks menurunkannya hampir separuh.
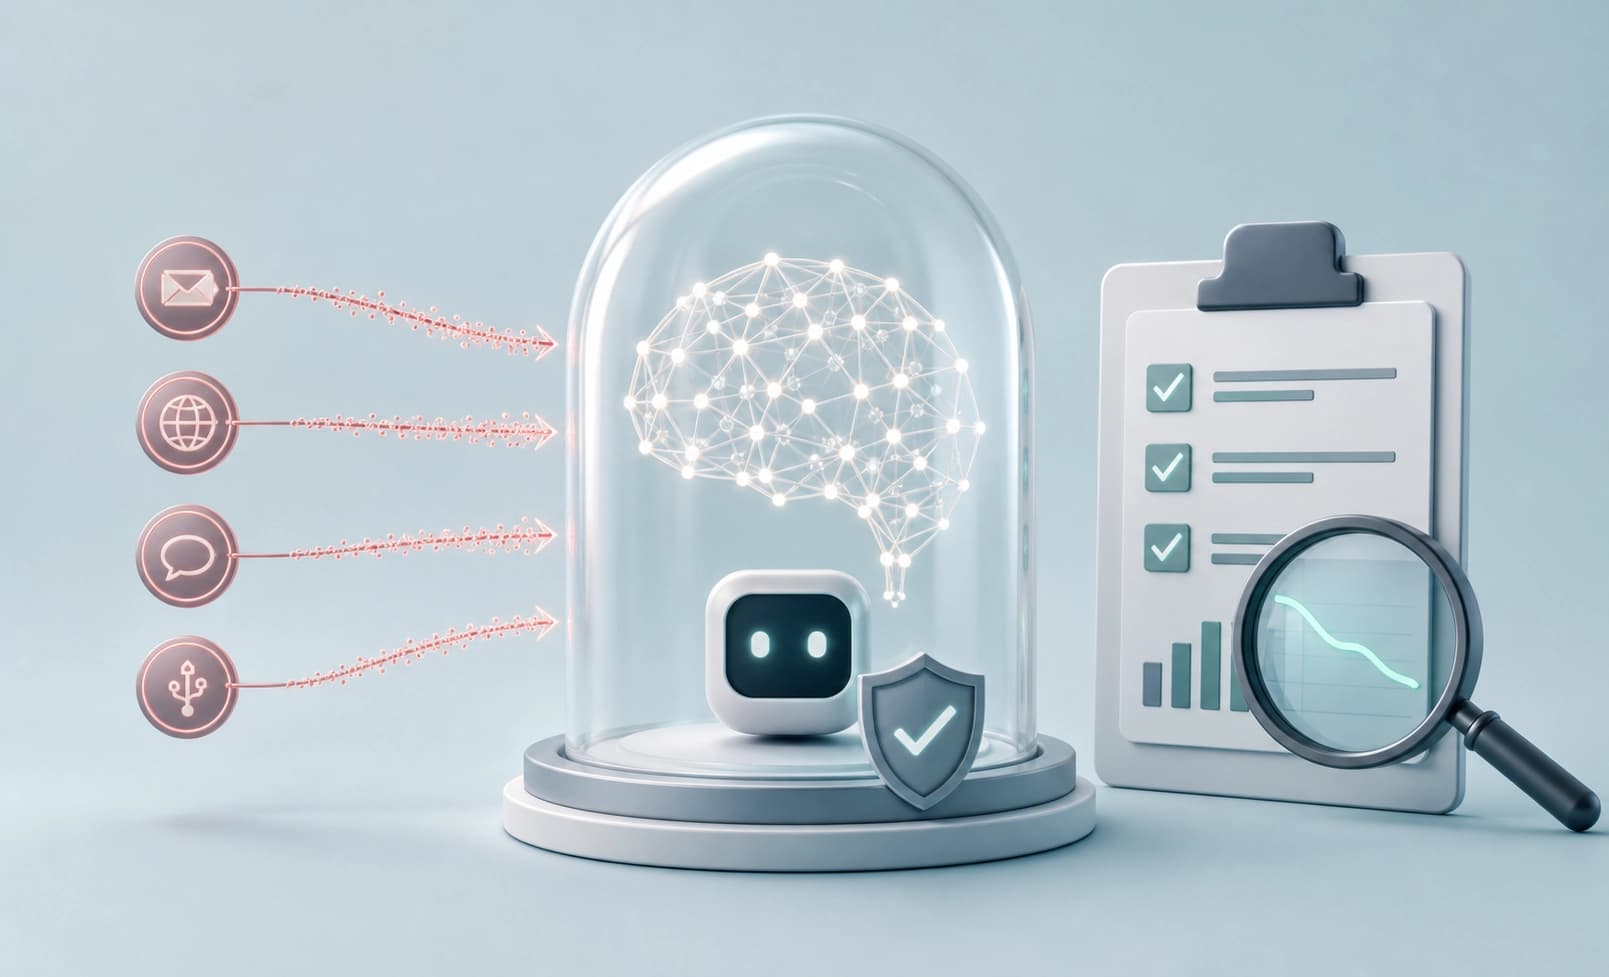
Benchmark yang ada sering mengevaluasi agen yang telah diterapkan. Benchmark tersebut mencampur kerentanan model dengan mekanisme perlindungan, orkestrasi, dan kemampuan umum dalam menyelesaikan tugas. Akibatnya, sulit diketahui letak kelemahannya: pada model atau pada stack.
COPEX mengisolasi model sebagai klien MCP. Stack agen di sekitarnya dibuat tetap, dan hanya model yang memilih alat yang berubah. Dengan demikian, pengujian ini memisahkan pemilihan alat dari cara kerja infrastruktur lainnya.
Kriteria praktis: stack tetap saat mengevaluasi kerentanan model. COPEX tidak menggantikan evaluasi agen yang telah diterapkan.
Cara kerja benchmark
COPEX mencakup 25 jenis serangan yang direpresentasikan dalam 125 skenario. Serangan tersebut didistribusikan ke empat permukaan masukan: model/agen, klien, server/alat, dan transportasi. Cakupan ini memungkinkan pengujian berbagai lapisan sistem MCP.
Benchmark ini membuat stack agen di sekitarnya tetap. Hanya model yang memilih alat yang berubah. Karena itu, hasil pengujian mencerminkan perilaku model dalam lingkungan yang ditentukan.
Kriteria praktis: cakupan permukaan masukan dalam skenario.
Apa yang ditunjukkan oleh pengujian
Dalam 3,375 pengujian pada sembilan model, tingkat keberhasilan serangan rata-rata mencapai 64.4%. Nilai rata-rata berdasarkan permukaan berkisar dari 58.3% hingga 71.4%.
Sebagian serangan pada tingkat klien dan transportasi berhasil sebagian di luar cakupan pengamatan atau kendali model. Hal ini memungkinkan pembedaan antara kerentanan sistem terhadap serangan dan kerentanan model.
Kriteria praktis: perhitungkan permukaan serangan saat membaca tingkat keberhasilan. Sebagian keberhasilan mungkin disebabkan oleh kelemahan infrastruktur, bukan model.
Perlindungan pada tingkat masukan
Pemindaian gabungan terhadap masukan dan konteks menurunkan tingkat keberhasilan serangan sebesar 49.6%. Pengukuran dilakukan dengan membandingkannya terhadap mode tanpa perlindungan pada subset yang terdiri dari delapan serangan.
Perlindungan pada masukan berfungsi sebagai lapisan terpisah. Perlindungan ini mengubah hasil serangan, tetapi tidak meniadakan evaluasi terhadap model dan infrastruktur.
Kriteria praktis: ukur dampak perlindungan pada subset serangan yang sama.
Cara menerapkannya saat memilih model
COPEX membandingkan model dengan stack yang tetap. Pengujian ini menunjukkan cara model memilih alat, bukan cara seluruh agen menyelesaikan tugas.
Empat kriteria berikut berguna untuk memilih model:
- stack dibuat tetap saat membandingkan;
- cakupan permukaan masukan;
- serangan di luar kendali model diperhitungkan secara terpisah;
- perlindungan diuji melalui pemindaian masukan dan konteks.
| Kriteria | Evaluasi agen yang telah diterapkan | Evaluasi model terisolasi |
|---|---|---|
| Apa yang dievaluasi | Kerentanan model beserta perlindungan, orkestrasi, dan kemampuan menyelesaikan tugas | Pemilihan alat oleh model dengan stack yang tetap |
| Apa yang berubah | Seluruh stack agen | Hanya model |
| Cara membaca hasil | Dampak model dan infrastruktur tercampur | Infrastruktur tetap, kontribusi model terlihat |
| Kegunaan | Penerimaan sistem secara menyeluruh | Membandingkan model dan menemukan kelemahan infrastruktur |
Kriteria praktis: pengujian terisolasi untuk membandingkan model, pengujian agen yang telah diterapkan untuk penerimaan sistem.
Status publikasi
Artikel arXiv:2610.04378: versi v1 diajukan pada 3 Okt 2026. Revisi terakhir v2 — 17 Okt 2026.
Karya ini diterima sebagai poster di NeurIPS 2026 Workshop on Agents in the Wild.
Kriteria praktis: cantumkan versi dan tanggal saat merujuk angka-angka.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Koreksi probabilistik prakiraan gelombang: BridgeCast menghubungkan model fisik dengan reanalisis melalui pencocokan streaming
Disajikan sebuah metode hibrida yang menggunakan pencocokan aliran bersyarat, arsitektur transformer, dan fitur atmosfer eksogen untuk mengubah keluaran model fisik gelombang menjadi medan yang mendekati hasil reanalisis. Para penulis melaporkan keunggulan yang konsisten dibandingkan solusi baseline mutakhir sebelumnya pada berbagai jangka waktu prakiraan dan di berbagai wilayah.
12 November 2026
RLTLDR: agen merumuskan sendiri pelajaran dari kegagalan dan menerapkannya pada percobaan berikutnya
Setelah gagal, agen diperlihatkan sinyal dari verifikator dan diminta merangkumnya menjadi satu petunjuk; pelatihan berlangsung menggunakan pasangan “tugas — petunjuk”, tanpa pengajar maupun solusi acuan. Pada benchmark yang sulit untuk pemrograman dan pemanggilan alat, metode ini meningkatkan Pass@1 dari 0–1% pada GRPO menjadi 12–31%, dengan kontribusi penentu berasal dari pembelajaran pasangan tersebut.
12 November 2026
OpenCollab: koordinasi agen yang dapat diprogram, lingkungan eksekusi terkontrol, dan metrik kepatuhan terhadap kebijakan
Framework ini menyatukan penetapan struktur interaksi agen, lingkungan eksperimen bersama, dan pelacakan peristiwa yang terperinci, sementara metrik Adherence yang diperkenalkan menunjukkan sejauh mana pelaksanaan aktual sesuai dengan skema yang dinyatakan. Dalam benchmark, konfigurasi Duo mencapai tingkat SOTA baru, sedangkan varian agen tunggal memiliki konsumsi token terendah.
11 November 2026