Apa yang sebenarnya digunakan ulang
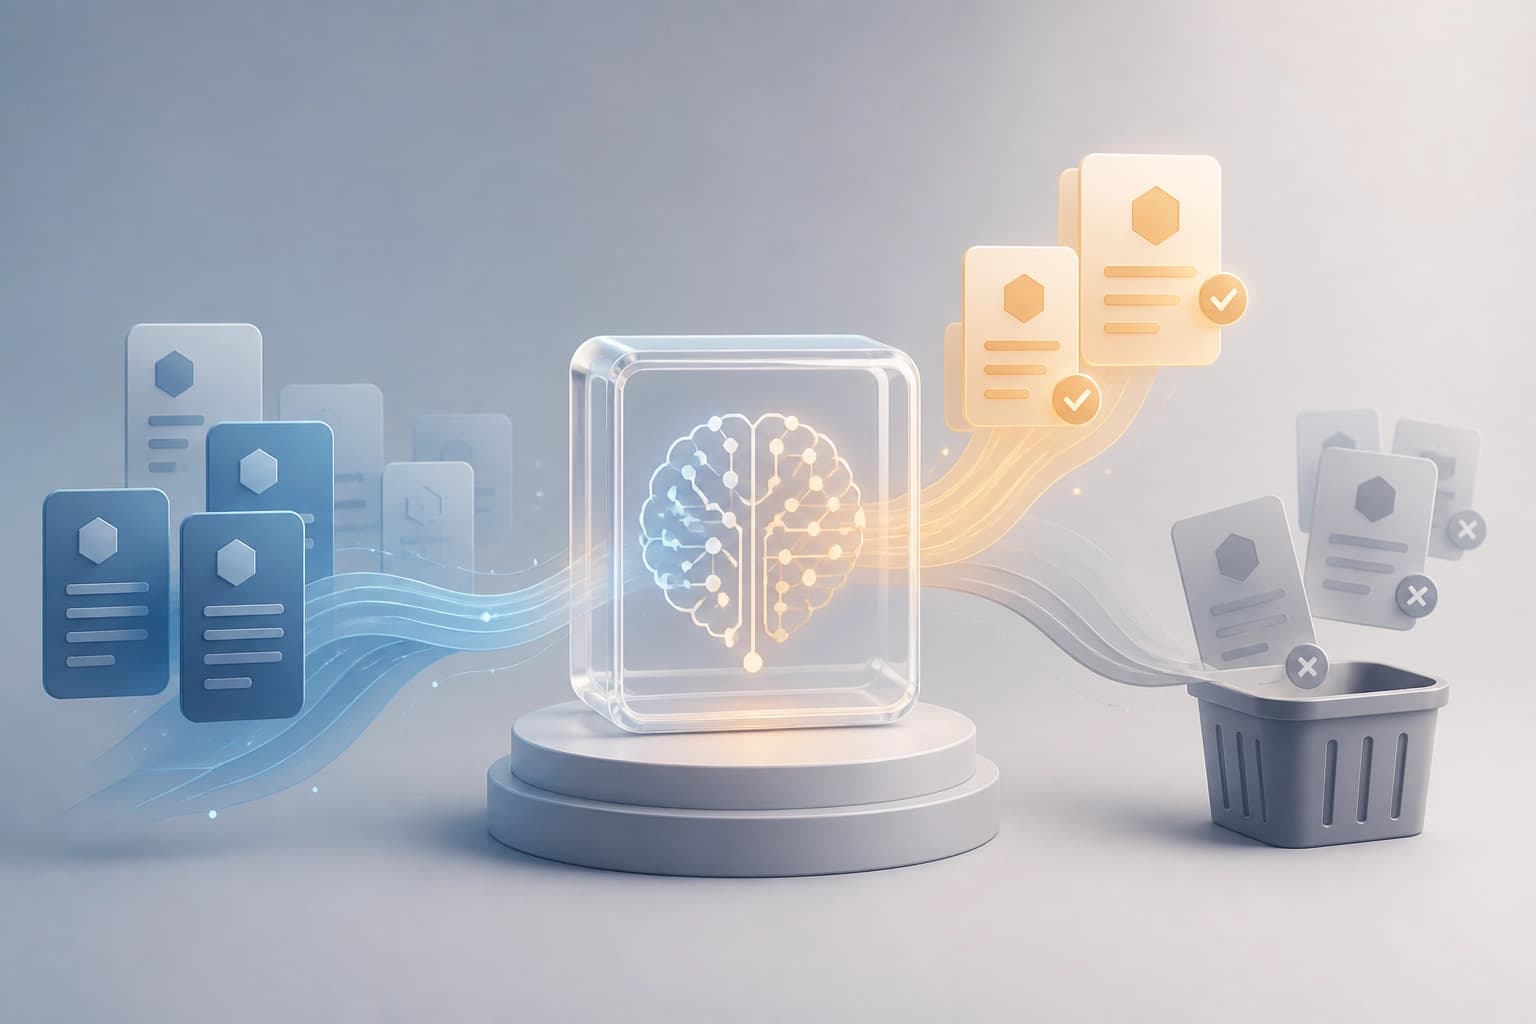
Dalam GRPO biasa, setiap rollout digunakan dalam satu pembaruan gradien, lalu dibuang. Metode dalam artikel mengubah siklus ini: metode tersebut menyimpan rollout secara terpisah dan mengembalikan rollout yang dipilih ke dalam pelatihan.
Buffer menyimpan generasi individual, bukan kelompok utuh. Replay memprioritaskan generasi berdasarkan besar advantage: rollout dengan nilai lebih besar digunakan ulang.
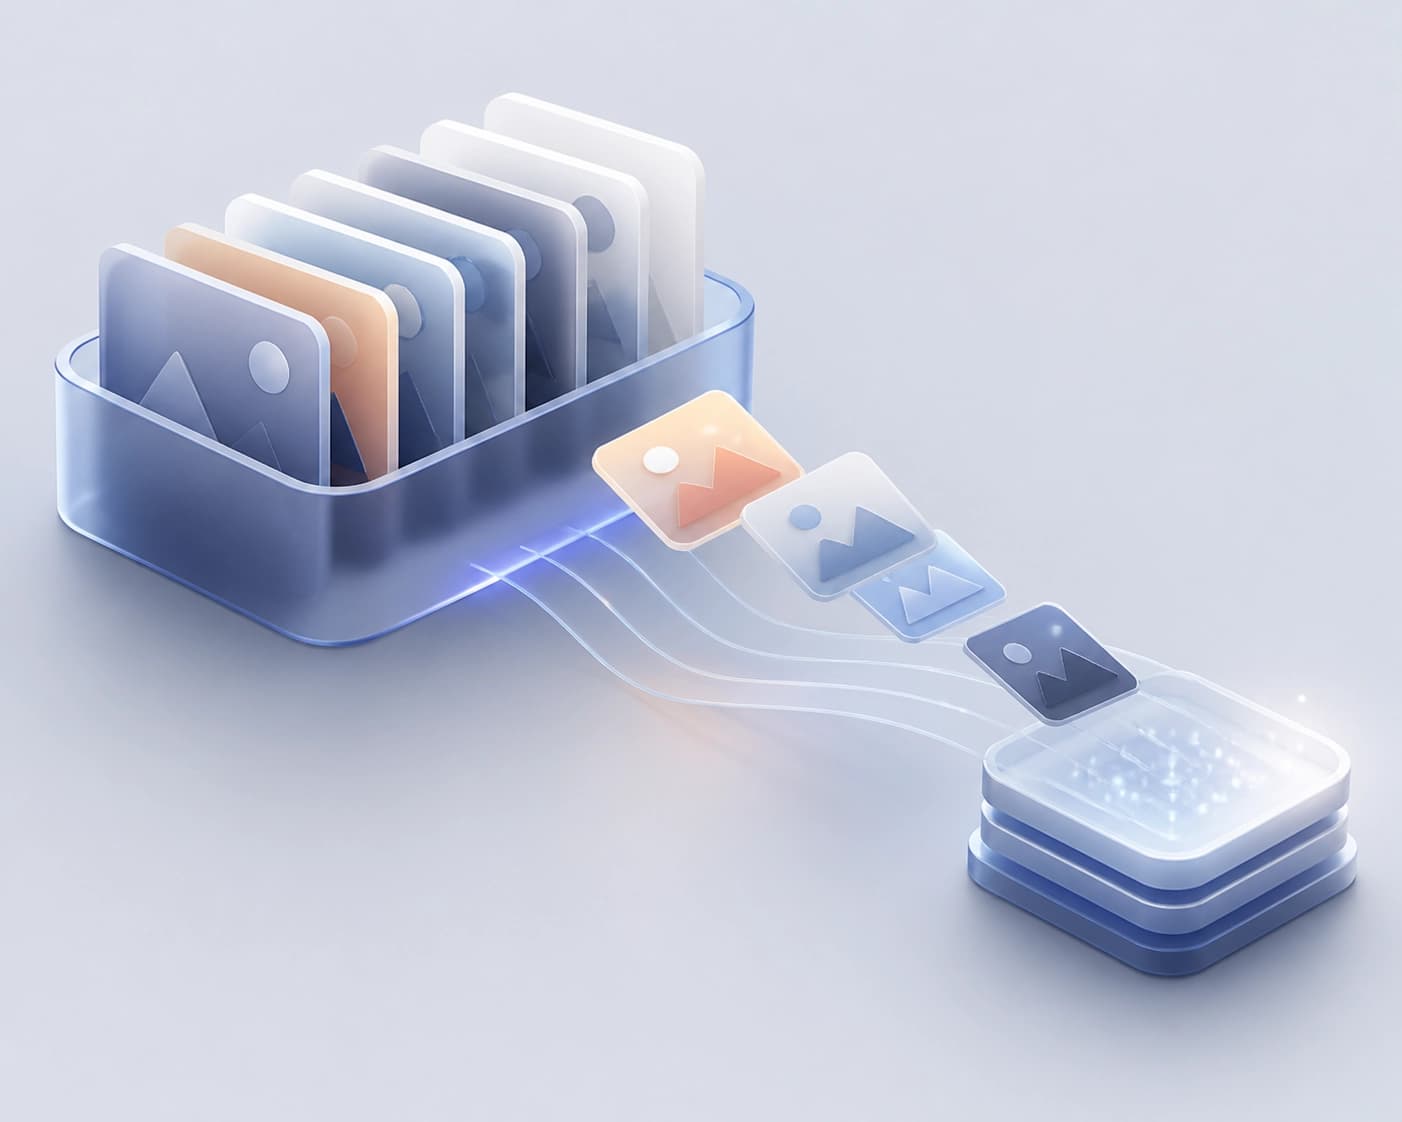
Kriteria praktis: yang digunakan ulang adalah rollout individual, bukan kelompok.
Cara kerja replay
Setiap batch dibentuk dalam dua tahap:
- Rollout on-policy terbaru dimasukkan ke dalamnya.
- Rollout yang dipilih secara terpisah dari buffer ditambahkan.
Saat memilih elemen replay, besar advantage setiap rollout dipertimbangkan. Porsi replay dalam batch tidak disebutkan dalam fakta yang dijelaskan.
Perbedaan utama metode ini adalah rollout terbaru tetap berada dalam batch, sementara buffer melengkapinya dengan generasi yang dipilih.
Cara membatasi keusangan
Para penulis mencatat masalah naive replay: kebijakan LLM berubah dengan cepat pada setiap langkah gradien. Rollout yang disimpan dapat menjadi usang dan membuat pelatihan tidak stabil.
Metode ini menghapus dari buffer setiap rollout yang lebih lama dari tau_max langkah pelatihan. Ini menetapkan batas penyimpanan, tetapi tidak menghilangkan penggunaan ulang itu sendiri.
Kriteria pengendalian di sini adalah usia rollout individual dalam langkah pelatihan, bukan keanggotaannya dalam suatu kelompok.
Hasil evaluasi
Metode ini diuji pada tiga skala Qwen3-Base dan lima benchmark matematika. Hasilnya mengungguli GRPO dan baseline naive replay.
- Pada setiap skala, peningkatan rata-rata pada lima benchmark bernilai positif.
- Pada skala 4B, peningkatannya mencapai +1.66 pp.
- Untuk AES, metrik evaluasi gabungan akurasi dan efisiensi token, metode ini menjadi satu-satunya opsi yang mengungguli GRPO pada setiap skala.
Kriteria praktis untuk memilih bergantung pada evaluasi yang dituju: hasilnya mencakup akurasi, efisiensi token, dan perbandingan dengan dua baseline.