
Mengapa format penyajian bukan sekadar detail implementasi
Ketika kita menguji memori model bahasa atau kualitas pipeline RAG, kita biasanya hanya tertarik pada satu hal: apakah model berhasil mencapai fakta yang dibutuhkan. Sedangkan dalam bentuk apa fakta itu muncul di konteks masukan — sebagai entri memori tersendiri, ringkasan yang dipadatkan, catatan terstruktur dengan bidang-bidang, atau potongan percakapan mentah — biasanya dianggap sebagai urusan internal sistem. Logikanya sederhana: kalau faktanya ada, tidak peduli bagaimana ia dikemas.
Penulis pracetak arXiv:2608.23568 mengajak kita untuk tidak menyetujuinya. Karya mereka "RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation" (Yuan Si, Simeng Han, Daming Li, Jialu Zhang; v1 tanggal 5 Juni 2026) menyerang gagasan bahwa memori memiliki satu penilaian yang jujur dan universal. Sebagai gantinya, mereka mengusulkan agar memori diukur seperti mengukur sifat-sifat lain yang sensitif terhadap konfigurasi: fiksasikan satu variabel dan iterasi nilai variabel lainnya.
Apa yang sebenarnya dikendalikan RENDER
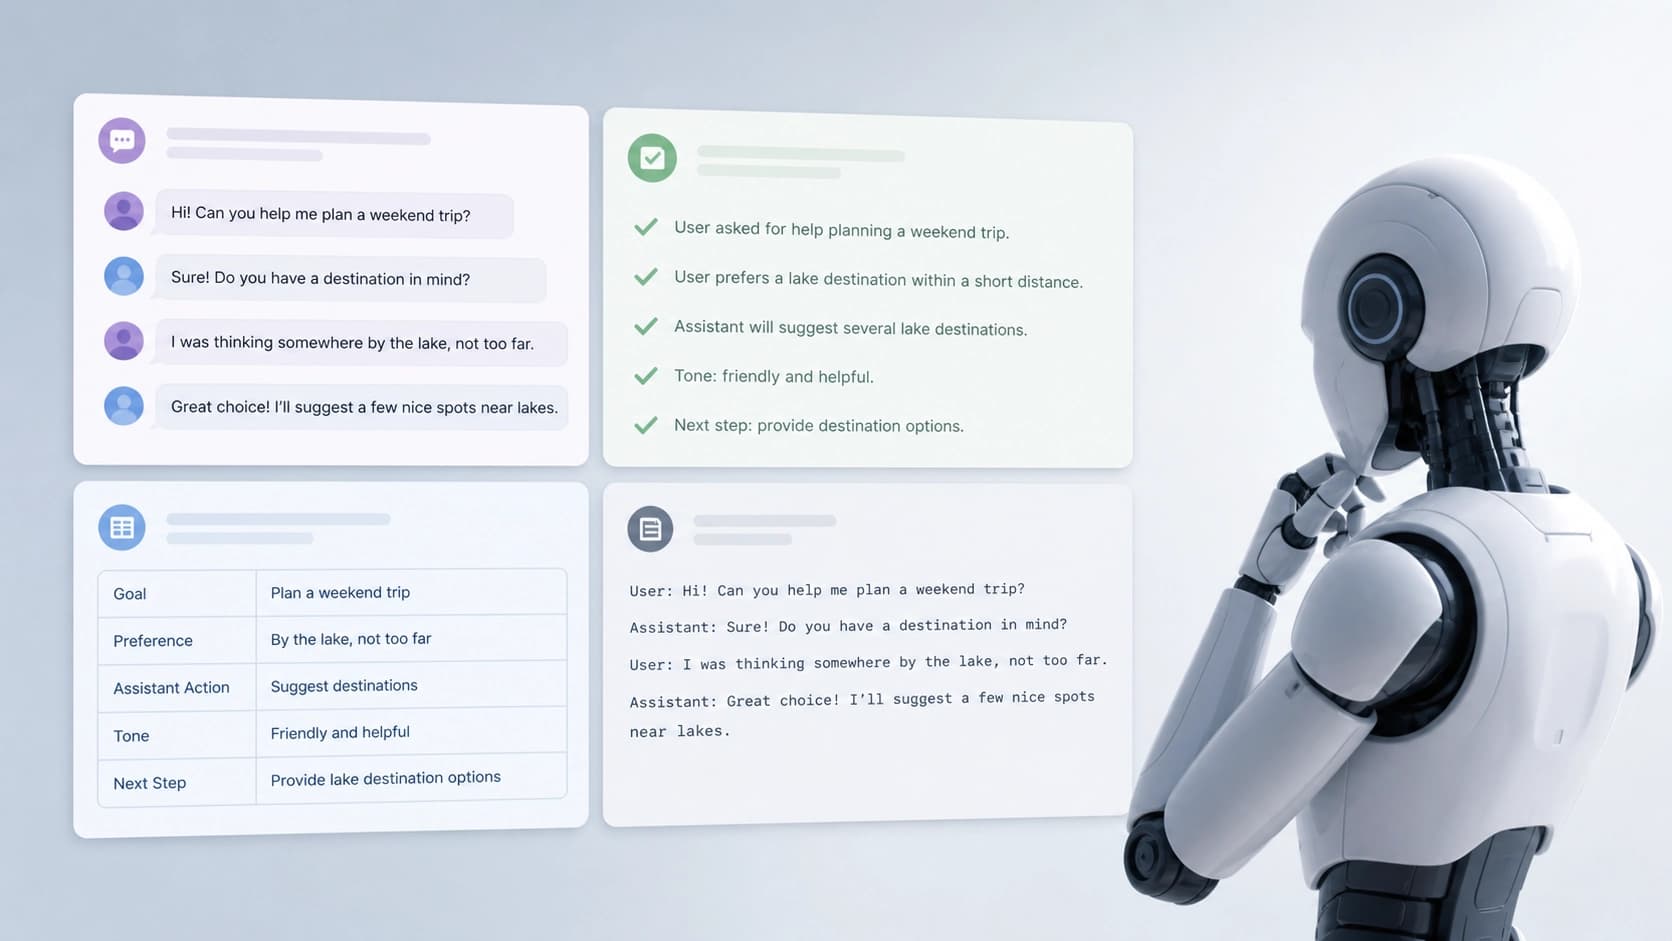
Dialognya tidak berubah. Yang berubah hanya artefak yang dihadapkan kepada pembaca: apa yang sebenarnya dilihat oleh model penjawab di hadapannya. Lapisan inilah — reader-facing artifact — yang RENDER jadikan variabel yang dapat dikendalikan.
Tangga lima tingkat
Inti metodologinya adalah five-level packet ladder. Ini bukan sekadar kumpulan format, melainkan skala yang melokalisasi momen ketika konten pembawa jawaban masuk ke masukan model penjawab. Tujuannya adalah memisahkan dua jenis kegagalan yang secara fundamental berbeda: sistem tidak menemukan fakta yang dibutuhkan, dan sistem menemukannya tetapi tidak mampu menyampaikannya dalam bentuk yang layak. Tanpa skala seperti ini, kedua kasus tersebut melebur menjadi satu baris laporan, dan selanjutnya muncul kesimpulan yang keliru — misalnya bahwa model "memiliki memori yang buruk", padahal sebenarnya ia hanya gagal mengurai kemasannya.
Empat templat penyajian
Elemen kedua adalah templat deterministik yang mengaproksimasi cara-cara tipikal menampilkan riwayat kepada pengguna. Ada empat:
- entri bergaya ChatGPT — blok rapi yang mirip dengan apa yang dilihat orang di antarmuka chatbot;
- ringkasan bergaya LangChain — parafrase padat yang kehilangan formulasi tetapi mempertahankan esensi;
- entri bertipe bergaya MemGPT — struktur dengan bidang dan kategori, cocok untuk pemrosesan mesin;
- dialog mentah — tuturan apa adanya, tanpa markup dan pengemasan ulang.
Templatnya deterministik: masukan yang sama selalu menghasilkan teks yang sama setiap kali. Ini penting, karena jika tidak, kita tidak akan bisa membedakan efek format dari variasi acak dalam generasi.
Apa yang ditunjukkan oleh angka-angka
Eksperimen ini bersandar pada 500 pertanyaan dari LongMemEval dan sembilan model. Di sini perlu berhenti sejenak: ini bukan satu kali eksekusi atau satu kali percobaan demi angka yang indah, melainkan kisi "model × format penyajian" yang memungkinkan kita melihat efeknya.
Hasil utama: matched-budget resolved packets mengungguli recency-truncated raw dialogue sebesar 42,4–72,6 poin. Dengan kata lain, jika format disetarakan pada anggaran yang sebanding dan model diberi konten yang benar-benar membawa jawaban, kesenjangan dengan cara penyajian paling naif — dialog mentah yang dipotong berdasarkan kebaruan — ternyata bukan kosmetik, melainkan sangat besar.
Pada templat bergaya deployed, gambarannya lebih lembut, tetapi tetap besar: rentang antara format terbaik dan terburuk mencapai 24,6–48,8 poin untuk masing-masing dari sembilan model. Artinya, dalam satu model yang sama, pada pertanyaan yang sama, dengan anggaran yang sama, kita bisa "kehilangan" atau "mendapatkan" puluhan poin hanya karena bagaimana bukti itu ditampilkan.
Satu detail lagi dari penilaian awal: pada 7 dari 9 model, entri bergaya ChatGPT memperoleh skor titik yang lebih tinggi daripada dialog mentah. Ini mungkin kesimpulan yang paling tidak nyaman bagi mereka yang membangun metrik berdasarkan riwayat percakapan yang "murni".
Juri juga bukan kebenaran mutlak
Alur terpisah — apa yang terjadi jika penilaian dihitung ulang bukan oleh skorer otomatis, melainkan oleh model juri (judge rescoring). Efek positif format yang teragregasi tetap bertahan, tetapi signifikansi pada masing-masing model menjadi campuran. Sederhananya: tren pada tingkat seluruh sampel tidak hilang, tetapi klaim titik seperti "model X menang justru karena format Y" setelah penjurian ulang tidak lagi begitu andal.
Ini bukan alasan untuk meninggalkan juri LLM, tetapi pengingat yang baik: setiap penilaian memori itu sendiri adalah alat ukur dengan sensitivitasnya sendiri terhadap format masukan. Dan jika sistem dan juri bereaksi berbeda terhadap pengemasan bukti, maka perbedaannya bisa hilang ke dalam derau atau, sebaliknya, menjadi sinyal palsu.
Hasil paling mencolok: nol versus lima puluh
Jika hanya satu angka yang diambil dari artikel ini, inilah yang layak diambil. Tiga model yang menunjukkan 0 % pada formal ledger packets menjawab fakta yang sama persis dari natural-language entries dengan akurasi 45,4–53,4 %.
Bukan "sedikit lebih baik", bukan "dalam batas kesalahan" — dari nol total hingga mencapai setengah kasus dengan percaya diri pada konten yang identik. Kesenjangan seperti ini sulit dijelaskan oleh kurangnya pengetahuan model atau pencarian yang buruk: faktanya ada, hanya cara penyajiannya yang berubah. Catatan formal yang dapat dibaca mesin entah mengapa menjadi tidak terlewati bagi model, sementara informasi yang sama yang disampaikan dalam bahasa biasa terbaca tanpa masalah.
Bagi seorang engineer, ini adalah sinyal praktis: jika pipeline Anda menyimpan memori dalam blok terstruktur yang ketat, Anda mungkin secara sistematis meremehkan kemampuan model — dan sekaligus melebih-lebihkan manfaat formalisasi.
Seberapa stabilkah ini
Efeknya tidak runtuh ketika kondisi menjadi lebih kompleks: ia bertahan di bawah retrieval noise, yaitu ketika fragmen-fragmen tambahan dicampurkan ke dalam konteks. Lebih dari itu, ia juga terbawa ke HotpotQA — kumpulan data lain yang dibangun di sekitar pertanyaan multi-langkah. Ini penting, karena menghilangkan kecurigaan bahwa semuanya hanya soal kekhasan satu benchmark memori panjang.
Keterbatasannya juga perlu diingat: templat mengaproksimasi cara penyajian nyata, bukan mereproduksinya secara literal, dan kesimpulan untuk model tertentu setelah penjurian ulang bersifat campuran. Jadi ini bukan tentang resep siap pakai, melainkan tentang perlunya menyadari variabel ini sama sekali.
Apa yang harus dilakukan dalam praktik
Kesimpulan penulis cukup langsung: laporan evaluasi memory/RAG harus menyatakan artefak reader-facing mana yang digunakan, atau secara eksplisit mengendalikannya. Berikut bagaimana ini terlihat secara terapan:
- Fiksasikan format dalam deskripsi pengujian. "Kami menjalankan model pada LongMemEval" adalah deskripsi yang tidak memadai jika tidak disebutkan dalam bentuk apa riwayat masuk ke masukan.
- Jalankan setidaknya dua-tiga format. Satu yang baik dan satu yang naif (misalnya, dialog mentah yang dipotong) sudah cukup memberi gambaran tentang sensitivitas sistem Anda.
- Jangan membandingkan model satu sama lain pada pengemasan yang berbeda. Perbedaan 20–30 poin bisa sepenuhnya milik format, bukan model.
- Uji skema memori terstruktur Anda. Nol pada catatan formal sementara jawaban atas fakta yang sama dalam teks biasa sangat percaya diri — itu bug penyajian, bukan bug memori.
- Uji secara terpisah kanal "model-juri". Jika penilai itu sendiri sensitif terhadap format, metriknya menjadi bias.
- Pertimbangkan biaya format. Ringkasan dan catatan bertipe menghemat token; sekarang ada sisi lain yang terukur, dan itu layak ditimbang secara sadar.
Gagasan utama RENDER sederhana dan karena itu tidak nyaman: "penilaian memori model" tanpa menyebutkan cara penyajian bukti adalah pernyataan yang tidak lengkap. Dialog yang sama, pertanyaan yang sama, model yang sama, tetapi jawaban yang berbeda. Perbedaannya terletak pada bagaimana Anda menunjukkan kepadanya apa yang harus ia ingat.


