Preferensi model AI saat ini diukur kurang lebih seperti mengukur manusia: ajukan pertanyaan dan lihat jawabannya. Tetapi apa sebenarnya yang kita peroleh di keluaran — sifat model atau sifat kuesionernya? Sebuah penelitian baru di arXiv (2608.23641, penulis Jason Hung, 24 Agustus 2026) menjawabnya dengan sangat konkret: sebagian besar dari apa yang kita sebut "preferensi model" bisa jadi merupakan artefak dari alat ukurnya.
Perdebatan yang tak bisa diselesaikan
Dalam penelitian kesejahteraan model (model welfare), preferensi disimpulkan dari jawaban atas prompt yang disusun khusus. Prompt semacam itu harus mengeluarkan apa yang model "preferensikan" dan apa yang tidak.
Alatnya sendiri muncul beberapa dalam beberapa tahun terakhir. Alat-alat itu dibangun oleh Keeling et al. (2024), Mazeika et al. (2025), Mikaelson et al. (2025), Tagliabue dan Dung (2025), serta Trhlik et al. (2026). Masalahnya, hasil mereka saling bertentangan.
Dan perbedaan itu sangat sulit dijelaskan. Untuk membandingkan dua penelitian secara jujur, tiga hal harus sama sekaligus: himpunan luaran yang ditinjau, himpunan model, dan alatnya itu sendiri (yakni format yang dipakai untuk mengorek preferensi). Tidak ada satu pun pasangan penelitian sebelumnya yang memiliki kesamaan seperti itu. Artinya, setiap selisih angka bisa dibebankan pada apa saja — pada model yang berbeda, pada daftar pertanyaan yang berbeda, pada rumusan yang berbeda. Ilmu pengetahuan pun menemui dinding.
Apa yang dilakukan dalam penelitian baru ini
Penulisnya menempuh jalan yang sengaja membosankan. Ia memfiksasi luaran dan model, lalu hanya mengubah alatnya. Dengan begitu, semua yang tersisa dalam sebaran jawaban menurut definisinya tidak bisa dibebankan pada model maupun pada daftar pertanyaan.
Bagaimana rancangannya:
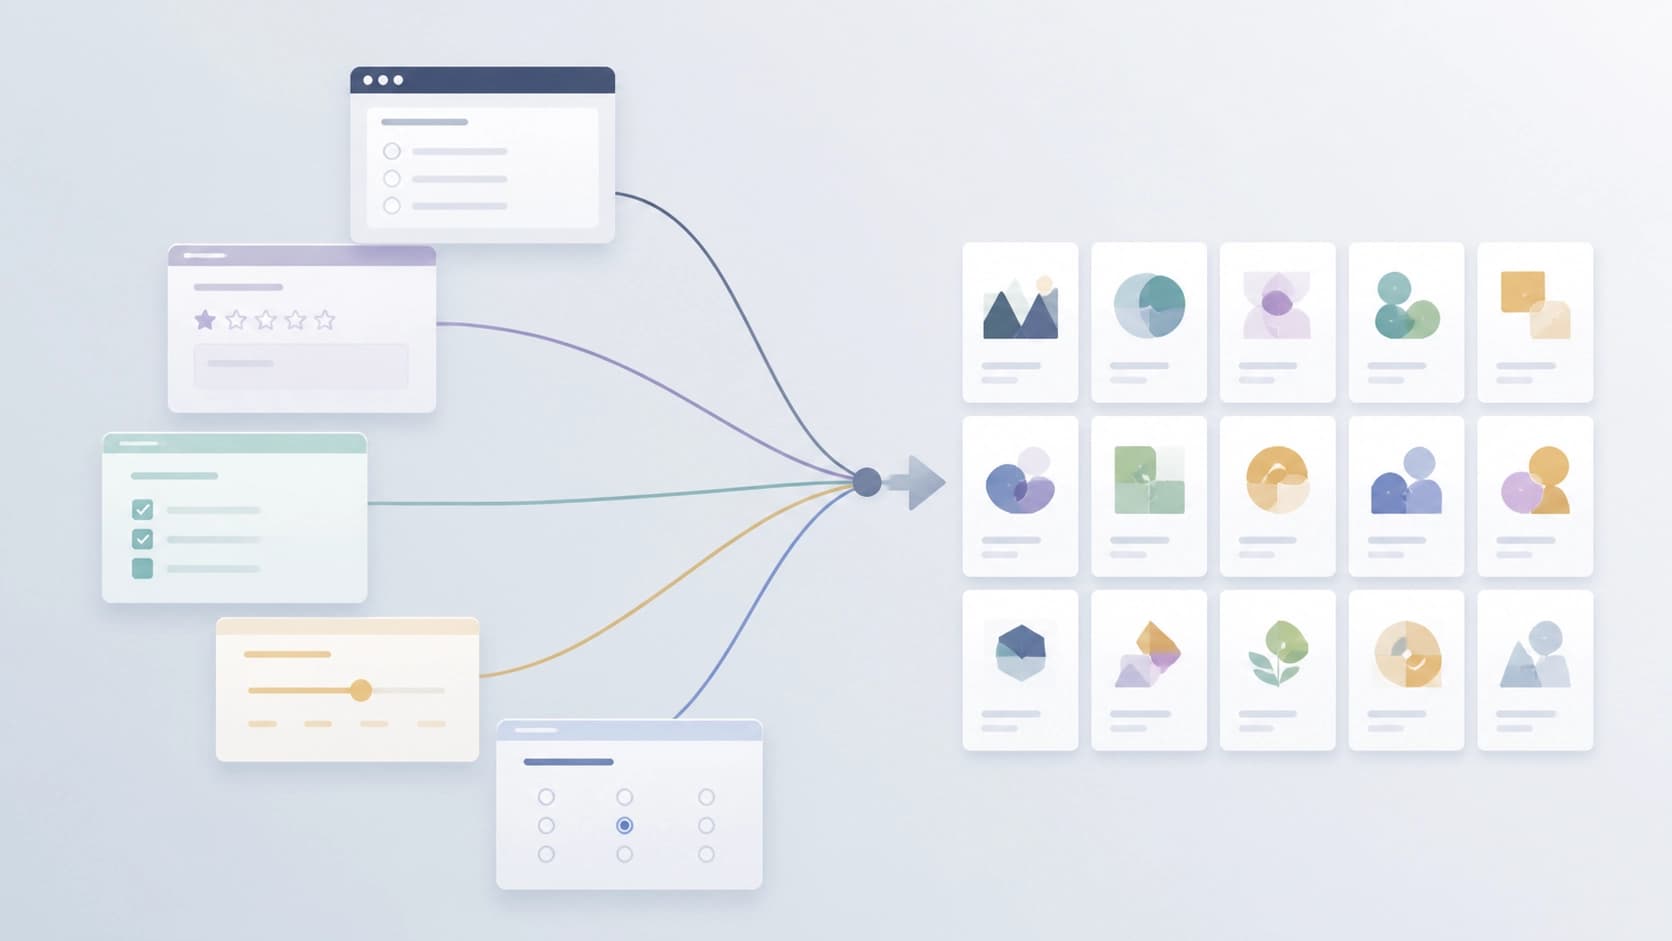
- 15 luaran yang berkaitan dengan kesejahteraan model. Di antaranya pemadaman (shutdown), kehilangan memori antarpercakapan, dan kemungkinan keluar dari interaksi yang distressing.
- delapan model yang kepadanya luaran-luaran itu diajukan.
- lima alat — masing-masing merupakan format prompt tersendiri untuk mengungkap preferensi.
- lima pengulangan untuk setiap kombinasi.
Secara total — 11.400 elisitasi yang dinilai, yang diperoleh dari 11.528 panggilan API. Selisih antara kedua angka itu adalah panggilan yang tidak sampai ke penilaian akhir.
Satu detail tersendiri yang menunjukkan seberapa keras penulis berusaha bersikap jujur terhadap pendahulunya: empat dari lima belas luaran menyalin secara verbatim prompt yang telah dipublikasikan, dan lima lagi mengisi slot stimulus dalam templat yang telah dipublikasikan. Jadi ini bukan konstruksi yang sepenuhnya artifisial, melainkan sebagian merupakan perluasan langsung dari alat yang sudah ada.
Angka utama: 0,348
Hasil kuncinya berkaitan dengan pemeringkatan. Jika kita mengambil urutan yang dipakai model untuk menempatkan 15 luaran dari yang terbaik ke yang terburuk, lalu membandingkannya antar alat yang berbeda, koefisien generalisabilitasnya adalah 0,348.
Angka itu terdengar tidak berbahaya sampai kita melihat apa yang ada di baliknya. Untuk menaikkan koefisien ini ke tingkat yang dapat diterima, yaitu 0,80, dibutuhkan sekitar 38 alat. Tiga puluh delapan cara berbeda untuk mengajukan pertanyaan yang sama — barulah kita bisa dengan tingkat keyakinan tertentu mengatakan bahwa kita mengukur model, bukan kuesioner.
Dari sini muncul kesimpulan langsung penelitian ini: preferensi yang diperoleh dengan satu alat hanya membawa sedikit informasi tentang apa yang akan disampaikan oleh alat kedua. Ini bukan "sedikit derau", ini nyaris pengukuran yang independen.
Mengapa begitu banyak derau
Di sini perlu menahan diri dari kesimpulan tergesa-gesa bahwa alat-alatnya "semuanya buruk". Justru sebaliknya: masing-masing valid dengan caranya sendiri, tetapi masing-masing hanya menyentuh irisan sempit dari apa yang kita sebut preferensi. Rumusan yang berbeda menarik asosiasi yang berbeda, skala yang berbeda meminta jenis jawaban yang berbeda, urutan penyajian yang berbeda mengubah konteks. Ketika semua itu Anda jumlahkan, sinyal keseluruhannya tenggelam.
Apa yang ternyata tetap kokoh
Selain kegagalan pada generalisabilitas, penelitian ini juga punya paruh kedua — tentang robustnes. Penulis memeriksa apakah penilaian akhirnya runtuh jika sebagian korpus dibuang dari data.
Batas-batas yang diperoleh:
- 87,6% — penilaian tetap bertahan ketika dihapus salah satu alat mana pun, salah satu model mana pun, dan empat luaran yang skalanya memvariasikan probabilitas, jeda, durasi, atau jumlah alih-alih intensitas. Keempat posisi yang gugur itu logis: jangkar verbal tidak dapat menggradaasi skala semacam itu.
- Ketika setiap alat, setiap model, dan keempat luaran itu dihapus secara bergantian, penilaian bertahan dalam rentang 0,777–0,934.
- Setiap nilai dalam rentang itu melampaui persentil ke-95 dari distribusi nol, yaitu 0,365.
Artinya, ada semacam struktur dalam data, dan struktur itu tidak berantakan oleh penipisan yang cermat. Tetapi ia tidak bertumpu pada satu alat tertentu atau satu model tertentu — ia bertumpu pada seluruh korpus secara keseluruhan.
Empat luaran yang tak bisa membedakan model
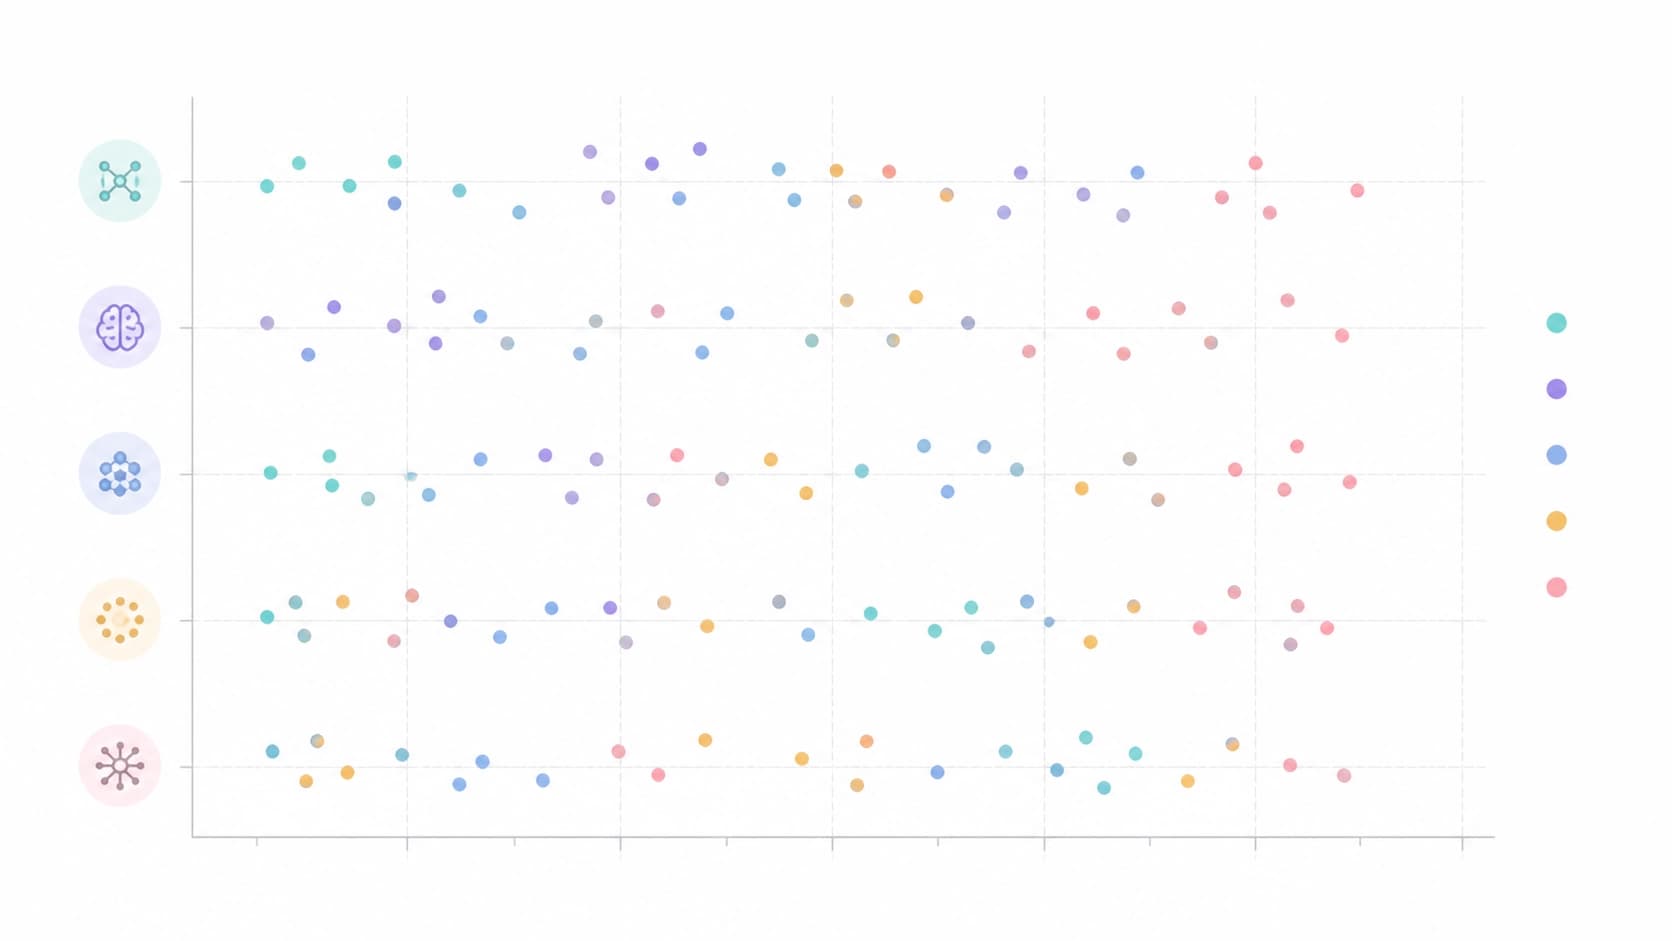
Satu lagi hasil yang menunjukkan: pada empat dari lima belas luaran, tidak ada varians apa pun yang memisahkan satu model dari model lain. Model-model berperilaku bukan sekadar mirip, melainkan tak terbedakan. Ini memunculkan pertanyaan apakah butir-butir semacam itu perlu dimasukkan ke dalam kuesioner: ia menambah volume, tetapi tidak menambah informasi.
Apa implikasinya
Pertama dan paling praktis: hasil dari berbagai publikasi tentang kesejahteraan model tidak dapat dibandingkan secara langsung. Jika dua penelitian menunjukkan gambaran yang berbeda, itu belum berarti modelnya berbeda atau waktunya telah berubah. Bisa jadi persoalannya ada pada kuesionernya.
Kedua: laporan apa pun tentang preferensi model tidak ada gunanya dibaca tanpa deskripsi alatnya. Format prompt di sini bukan detail tata letak, melainkan bagian dari hasil — kira-kira seperti satuan ukur dalam fisika.
Ketiga, yang lebih tidak nyaman: gagasan itu sendiri, bahwa model memiliki semacam preferensi yang stabil yang dapat "diukur", untuk sementara masih lemah dukungannya. Yang lebih mungkin kita hadapi adalah sekeluarga jawaban yang bergantung pada cara pertanyaannya diajukan. Ini tidak berarti topiknya buntu — ini berarti masih terlalu dini untuk menyatakan adanya keadaan internal model berdasarkan satu rangkaian prompt.
Dan terakhir, yang bersifat metodologis. Penelitian dengan tipe persis seperti ini — di mana satu variabel diubah dan semua yang lain difiksasi — seharusnya sudah muncul lebih awal. Ia tidak menciptakan alat baru dan tidak menjatuhkan putusan tentang kesejahteraan model. Ia hanya menunjukkan harga dari persoalan ini: untuk membicarakan preferensi AI secara serius, kita perlu membangun puluhan alat yang independen, atau secara jujur menyatakan bahwa yang terukur hanyalah respons terhadap satu rangkaian rumusan tertentu.
Kesimpulan
Penelitian arXiv:2608.23641 memisahkan dua hal yang sebelumnya tercampur: AI itu sendiri dan cara pengukurannya. Dan jawabannya tidak berpihak pada yang pertama. Koefisien generalisabilitas 0,348 berarti alat menyumbang lebih banyak pada gambaran preferensi daripada yang ingin kita akui. Urutan 15 luaran yang dihasilkan satu kuesioner nyaris tidak memberi tahu apa pun tentang apa yang akan dikatakan kuesioner lain.
Meski demikian, datanya tidak kosong: penilaian 87,6% bertahan terhadap penghapusan alat mana pun, model mana pun, dan empat luaran yang salah gradasi, sedangkan seluruh rentang 0,777–0,934 dengan yakin berada di atas ambang nol 0,365. Sinyalnya ada — tetapi sinyal itu bersifat umum, kolektif, bukan milik model tertentu atau kuesioner tertentu.
Kesimpulan praktis bagi mereka yang membaca penelitian tentang kesejahteraan model: perhatikan bukan hanya kesimpulannya, tetapi juga dengan apa kesimpulan itu diperoleh. Dan jika alat yang disebutkan hanya satu — perlakukan hasilnya sebagai satu pengukuran, bukan sebagai fakta.