
RBS-Attention: mempercepat prefill prompt panjang dengan mencari blok yang kurang mendapat perhatian
Artikel ini menyajikan metode yang melengkapi pemilihan blok berdasarkan kemiripan rata-rata dengan pencarian kandidat yang dapat menyembunyikan token penting. Pada konteks 128K, penulis melaporkan percepatan attention saat prefill hingga 20,65 kali; pada Qwen3-32B, skor RULER mencapai 88,65 dibandingkan dengan 89,52 pada attention padat.
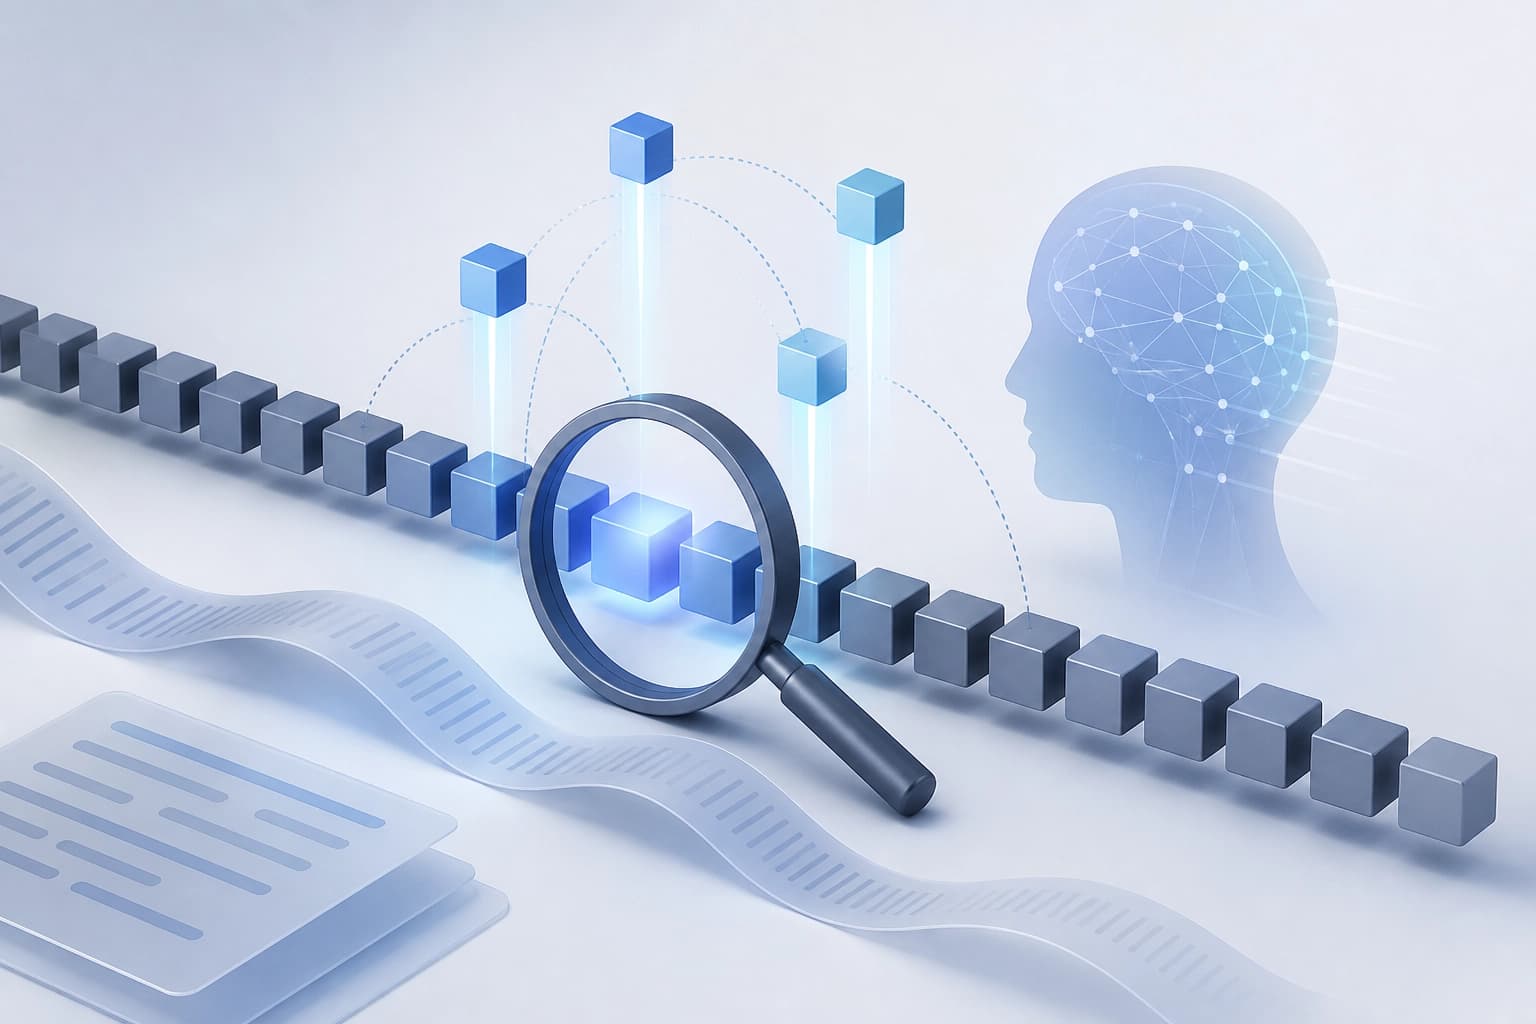
Bagian inferensi mana yang dipercepat metode ini
Prefill memproses prompt sebelum generasi dimulai. Self-attention padat memproses seluruh input, sehingga konteks yang panjang meningkatkan beban komputasi pada tahap ini.
RBS-Attention memilih blok secara sparsial untuk prefill dan dapat mengurangi biaya komputasi. Namun, sentroid blok merata-ratakan relevansi token dan dapat menyamarkan token penting di antara token yang tidak relevan. Penulis menyebut kegagalan ini mean dilution.
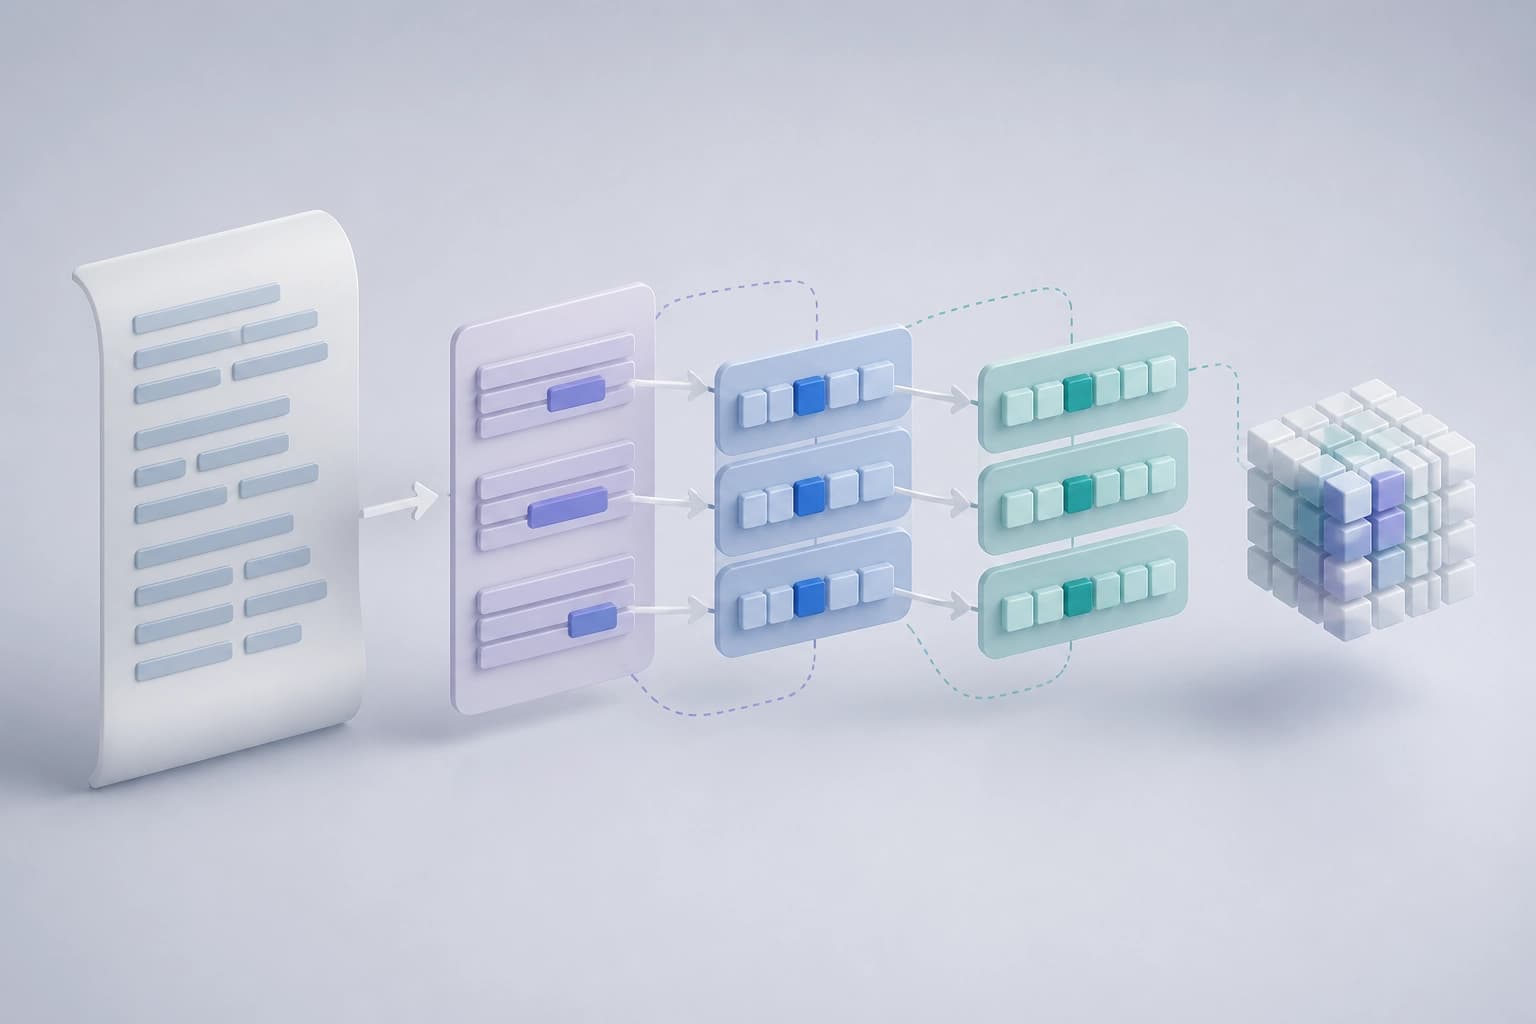
Manfaat praktis metode ini adalah mempercepat prefill tanpa hanya mengandalkan relevansi rata-rata seluruh blok.
Cara kerja pemilihan blok
Metode ini tidak memerlukan pelatihan dan menggunakan dua cabang yang saling melengkapi:
- Cabang dasar memperkirakan relevansi rata-rata blok melalui sentroid.
- Cabang pemulihan memperhitungkan radius maksimum blok key dan distribusinya, yang bergantung pada prompt, layer, dan head. Dengan demikian, cabang ini mengidentifikasi blok dengan relevansi yang berpotensi diremehkan.
Setiap cabang menerapkan ambang secara terpisah pada pilihannya. Kemudian, metode ini menggabungkan mask dan mengontrol kontribusi blok pemulihan. Eksekusi tetap menggunakan FlashAttention blok-sparse reguler.
Rancangan ini cocok untuk skenario ketika pemilihan berdasarkan sentroid dapat melewatkan token tertentu yang relevan, sementara eksekusi blok-sparse perlu dipertahankan.
Hasil kecepatan yang ditampilkan
Pengukuran dilakukan pada H100 dengan konteks 128K. Untuk Qwen3-30B-A3B-Instruct-2507-FP8, artikel melaporkan percepatan berikut:
| Tahap | Percepatan |
|---|---|
| Prefill-attention mandiri | 20.65× |
| Prefill-attention di vLLM | 11.92× |
| Time-to-first-token end-to-end | 5.97× |
Ini adalah hasil dari konfigurasi tertentu. Hasil tersebut sebaiknya dipertimbangkan secara terpisah dari evaluasi kualitas dan tidak diterapkan pada model lain tanpa pengukuran yang sesuai.
Hal yang diketahui tentang kualitas dan pengujian
Pada model padat Qwen3-32B, akurasi keseluruhan RULER mencapai 88.65. Untuk attention padat, angkanya adalah 89.52.
Evaluasi kualitas tambahan dilakukan pada LongBench-v2, InfiniteBench, dan Video-MME. Eksperimen pendukung mengukur retensi data yang relevan, membandingkan selektor pada tingkat sparsitas yang sama, serta menguji berbagai ukuran blok, ambang, dan jumlah memori.
Saat memilih metode, kecepatan dan kualitas sebaiknya dinilai secara terpisah: hasil RULER yang dilaporkan tidak menggantikan pengujian pada tugas-tugas yang penting untuk penggunaan tertentu.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Toollery: memilih alat untuk agen LLM dari puluhan ribu opsi tanpa fine-tuning
Toollery membangun indeks pencarian berdasarkan deskripsi keterampilan dan alat, lalu saat ada permintaan hanya meneruskan sekumpulan kandidat terbatas ke model. Dalam eksperimen pada pustaka berskala hingga puluhan ribu fungsi, pendekatan ini mampu mempertahankan kualitas pemilihan dengan top-K tetap, meskipun dampak akhirnya bergantung pada profil beban dan caching di penyedia.
11 November 2026
Diagnostik bertahap agen GUI dalam analisis dasbor: benchmark DashAct
DashAct diperkenalkan sebagai tolok ukur yang terdiri atas 348 trajektori yang diverifikasi manusia, yang menguraikan kerja agen GUI dengan panel interaktif menjadi tiga tahap dan empat kondisi visual. Hasilnya menunjukkan masalah yang terus berulang dalam memprediksi tindakan dan mengaitkannya dengan target visual, serta ketergantungan respons agen pada dukungan kontekstual dan spasial.
11 November 2026
WILSON: menggabungkan tingkat pembesaran dan preparat pasien untuk analisis patomorfologi dan penyusunan laporan
Pracetak ini memperkenalkan WILSON — model vision-language yang mengodekan gambar seluruh slide dan rangkaian preparat dari satu pasien pada berbagai tingkat pembesaran, bukan hanya satu slide “terbaik”. Tanpa pelatihan lanjutan untuk tugas tertentu, model ini mengungguli model slide khusus dan berukuran lebih besar pada sejumlah metrik dengan beban komputasi yang jauh lebih rendah, sementara deskripsi diagnostiknya mendapat penilaian lebih tinggi dari para ahli patologi.
11 November 2026