
WILSON: menggabungkan tingkat pembesaran dan preparat pasien untuk analisis patomorfologi dan penyusunan laporan
Pracetak ini memperkenalkan WILSON — model vision-language yang mengodekan gambar seluruh slide dan rangkaian preparat dari satu pasien pada berbagai tingkat pembesaran, bukan hanya satu slide “terbaik”. Tanpa pelatihan lanjutan untuk tugas tertentu, model ini mengungguli model slide khusus dan berukuran lebih besar pada sejumlah metrik dengan beban komputasi yang jauh lebih rendah, sementara deskripsi diagnostiknya mendapat penilaian lebih tinggi dari para ahli patologi.
Mengapa Satu Kaca Objek Representatif Tidak Cukup
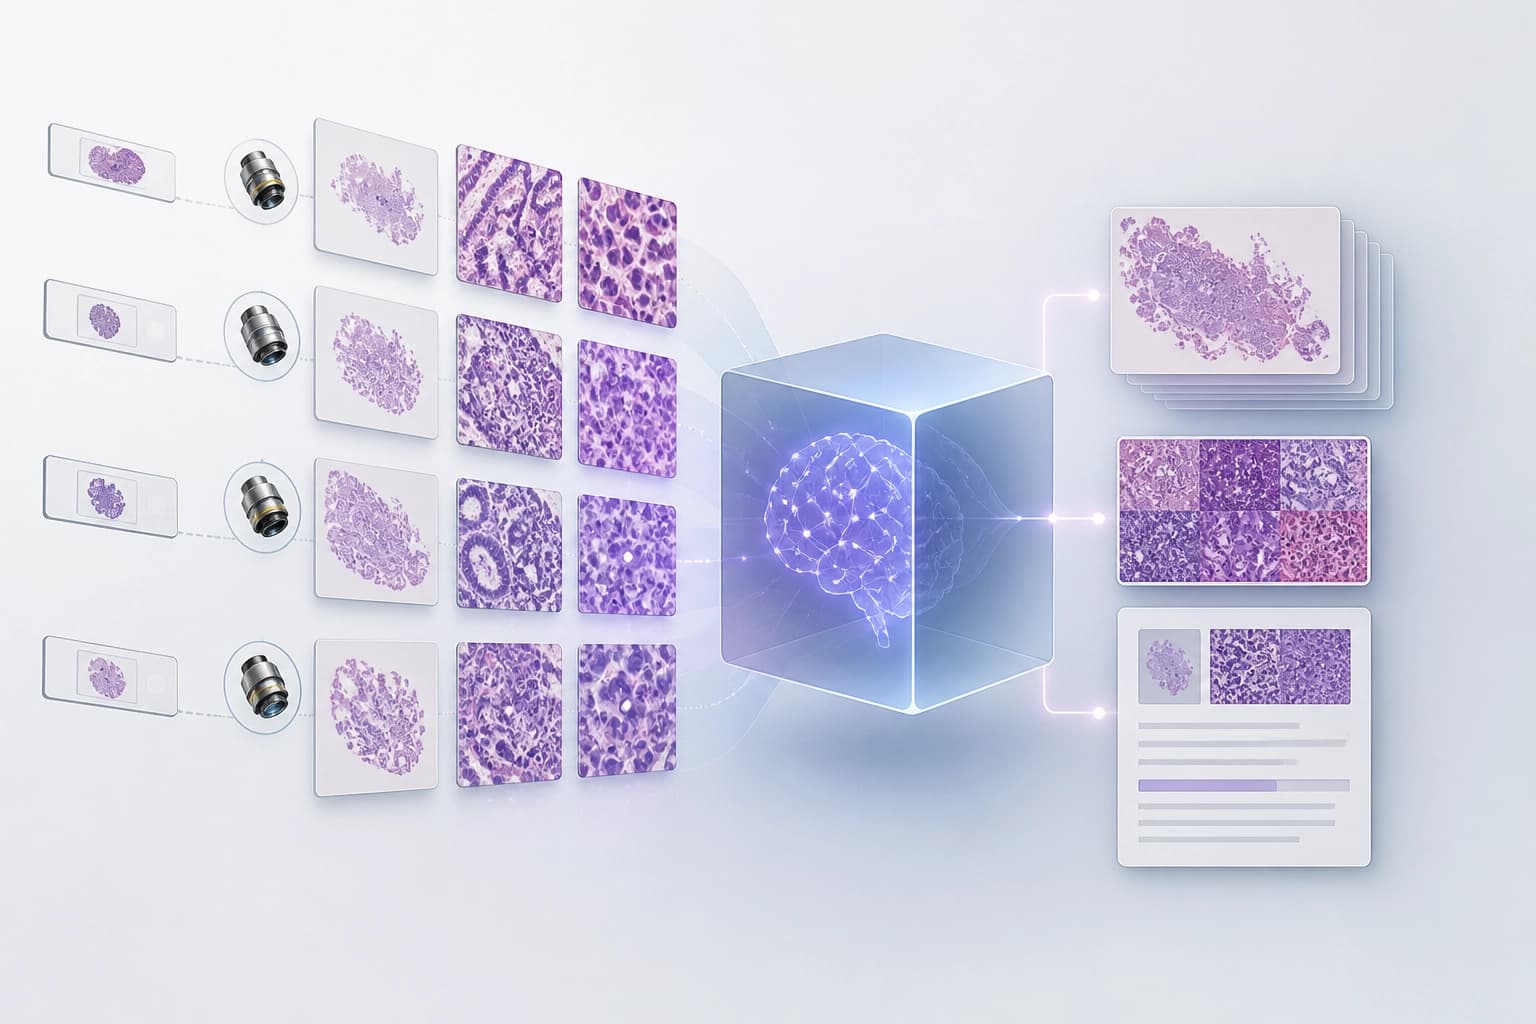
Patolog memeriksa irisan jaringan pada berbagai tingkat pembesaran dan pada beberapa kaca objek. Mereka menggabungkan informasi morfologis untuk menegakkan diagnosis. Sebagian besar model fondasi untuk patologi mengodekan ribuan patch gambar dari satu kaca objek representatif (“best”). Model kemudian mengagregasikan fitur-fitur tersebut.
Keterbatasan pendekatan ini:
- model menerima satu kaca objek “best”, bukan seluruh kasus;
- fitur dari berbagai tingkat pembesaran tidak dihubungkan menjadi satu representasi;
- konteks pada tingkat pasien hilang saat patch diagregasikan.
Kriteria praktis: untuk tugas pada tingkat kasus, diperlukan model yang menerima beberapa kaca objek dan berbagai tingkat pembesaran. Satu slide representatif tidak mencakup kebutuhan tersebut.
Cara Model Menggabungkan Berbagai Tingkat Pembesaran dan Kaca Objek
WILSON adalah model fondasi vision-language. Model ini merepresentasikan whole-slide images dan kasus dengan beberapa kaca objek melalui multi-magnification composites. Model ini mendukung analisis pada tingkat pasien.
Yang tercakup dalam representasi:
- whole-slide images;
- kasus dengan beberapa kaca objek;
- beberapa tingkat pembesaran dalam multi-magnification composites.
Kesimpulan: model mempertahankan informasi morfologis dari berbagai skala dan kaca objek dalam satu representasi. Hal ini membedakannya dari pendekatan yang menggunakan satu kaca objek “best”.
Pelatihan dan Cakupan Data
Data pelatihan WILSON mencakup sekitar 189.000 slide. Data tersebut meliputi 42 organ dan 838 entitas diagnostik.
Cakupan:
- 189.000 slide;
- 42 organ;
- 838 entitas diagnostik.
Daftar organ dan entitas menjadi acuan untuk memeriksa kesesuaian tugas. Spesialis mencocokkan organ dan entitas diagnostik dengan daftar tersebut.
Hasil Tanpa Pelatihan Khusus Tugas
WILSON mengungguli model khusus tingkat kasus dengan macro-F1 tanpa pelatihan khusus tugas. Skornya 0.52 dibandingkan 0.38.
| Perbandingan | WILSON | Alternatif |
|---|---|---|
| Macro-F1 pada tugas tingkat kasus | 0.52 | 0.38 |
| Operasi komputasi | 400–1.350 kali lebih sedikit | model tingkat slide yang jauh lebih besar |
Model ini juga menunjukkan hasil setara dengan model tingkat slide yang jauh lebih besar. Namun, model ini memerlukan operasi komputasi 400–1.350 kali lebih sedikit.
Kesimpulan: kualitas analisis tingkat kasus tidak harus meningkat seiring dengan biaya komputasi. Representasi multiskala yang ringkas memberikan acuan praktis.
Penyempurnaan untuk Tugas Tertentu
End-to-end fine-tuning meningkatkan hasil WILSON pada tugas:
- subtipe kanker payudara;
- penentuan gradasi limfosit stroma.
Kriteria praktis: untuk tugas yang spesifik, end-to-end fine-tuning patut dipertimbangkan. Model dasar tanpa penyempurnaan dapat melakukan analisis tingkat kasus, sedangkan penyempurnaan meningkatkan kinerja pada tugas tertentu.
Pencarian dan Pembuatan Teks Diagnostik
Dalam image-text retrieval, WILSON mengungguli PRISM pada recall@1. Hasilnya 75.6% dibandingkan 58.1%.
| Metrik | WILSON | PRISM |
|---|---|---|
| recall@1 | 75.6% | 58.1% |
Deskripsi diagnostik WILSON mendapat penilaian lebih tinggi dari lima patolog dengan board certification. Model pesaing mendapat penilaian lebih rendah.
Kriteria praktis: untuk pencarian dan penyusunan laporan, dua kemampuan penting adalah retrieval dan pembuatan teks. Keduanya diuji pada tugas yang mendekati alur kerja.
Apa Artinya bagi Pemilihan Model
Para penulis menyimpulkan bahwa representasi multiskala yang ringkas dapat mendukung model fondasi yang efisien secara komputasi dan berorientasi klinis. Untuk pemilihan praktis, hal ini berarti ada beberapa hal yang perlu diperiksa.
Kriteria:
- model menerima beberapa kaca objek;
- model menghubungkan berbagai tingkat pembesaran;
- analisis dilakukan pada tingkat pasien;
- kualitas diukur pada tugas tingkat kasus;
- operasi komputasi diperhitungkan;
- retrieval dan pembuatan teks diuji secara terpisah.
Kesimpulan: satu slide “best” dan agregasi ribuan patch tidak mencakup konteks pasien. Pemilihan model didasarkan pada cara model menyusun konteks tersebut dan jumlah komputasi yang dibutuhkan.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Diagnostik bertahap agen GUI dalam analisis dasbor: benchmark DashAct
DashAct diperkenalkan sebagai tolok ukur yang terdiri atas 348 trajektori yang diverifikasi manusia, yang menguraikan kerja agen GUI dengan panel interaktif menjadi tiga tahap dan empat kondisi visual. Hasilnya menunjukkan masalah yang terus berulang dalam memprediksi tindakan dan mengaitkannya dengan target visual, serta ketergantungan respons agen pada dukungan kontekstual dan spasial.
11 November 2026
Invarian polinomial kanonik dalam diagnostik kegagalan simulator RL: di mana sebenarnya berguna?
Studi ini menguji apakah menyertakan hukum fisika dalam model dinamika yang dapat dilatih memang sepadan: invarian yang diekstrak dari lintasan dan diubah ke bentuk kanonis melalui basis Gröbner hanya sedikit meningkatkan prediksi, tetapi sangat berguna untuk diagnosis—invarian ini dapat membantu menemukan kendala yang dilanggar dan mengidentifikasi parameter spesifik yang keliru.
10 November 2026
AURA-Eval: cara memeriksa apakah agen LLM mengenali risiko dan mengubah langkah berikutnya
Framework ini mengevaluasi perilaku agen LLM bukan berdasarkan keputusan akhir, melainkan respons terhadap risiko di titik-titik penting: rangkaian pemanggilan alat dihentikan, lalu model harus melanjutkan penalaran dan tindakan, sementara panel juri LLM menilai deteksi risiko, karakter, dan keamanan langkah tersebut. Dalam 1.249 tugas yang dikumpulkan dari 157 rangkaian R-Judge, 20 model lebih sering melakukan tindakan tidak aman saat jalur aman tidak tersedia, dan penghapusan pengawasan sebelum eksekusi mengubah 52,3% kasus yang semula aman menjadi tidak aman.
10 November 2026