
Sekilas inti masalahnya
Ada kelas serangan yang biasa disebut indirect prompt injection (IPI): model disodori instruksi berbahaya bukan melalui chat, melainkan melalui hasil kerja alat eksternal — halaman web, email, berkas, atau respons API. Agen dengan patuh membacanya sebagai data dan bisa saja menjalankan tugas sampingan milik pihak lain.
Tim peneliti dari Tiongkok (Jianshuo Dong, Yiming Liu, Maosen Zhang, Nan Deng, Peng Xu, Xiaoping Zhang, Tianwei Zhang, Jie Zhang, Han Qiu) menunjukkan: momen ketika agen "terkena injeksi" sudah terekam dalam representasi internalnya — bahkan sebelum ia mengeluarkan token pertama. Karya ini dipublikasikan di arXiv (2608.02657, v1 — 1 Agustus 2026, v2 — 24 Agustus 2026), DOI: 10.48550/arXiv.2608.02657, kodenya tersedia secara terbuka.
Kejutan utamanya bukan pada kerentanannya sendiri, yang sudah lama diketahui, melainkan pada kenyataan bahwa sinyal kerentanan dapat diekstraksi secara linear, stabil, bahkan pada model berskala ratusan miliar dan triliunan parameter. Artinya, ini bukan korelasi artifak yang rapuh dari satu dataset saja.
IPI exposure: apa sebenarnya yang dicari oleh probe
Para penulis memperkenalkan konsep kerja "IPI exposure" — keadaan model selama pemrosesan yang bersesuaian dengan masuknya instruksi pihak ketiga yang tidak diinginkan ke dalam konteksnya. Ini tidak sama dengan fakta serangan yang berhasil: model bisa saja "menyadari" ancaman tersebut dan tetap menjalankannya. Yang dimaksud di sini adalah keadaan internal exposure itu sendiri.
Kata kuncinya di sini adalah "sebelum generasi". Probe melihat keadaan tersembunyi pada masukan ke dekoder, bukan pada jawaban yang sudah dihasilkan. Ini penting karena dua alasan: pertama, sinyalnya ada bahkan di tempat yang perilaku akhirnya tampak tidak berbahaya; kedua, diagnosis dapat dilakukan sebelum model sempat memanggil alat yang menimbulkan efek samping.
Eksperimen: probe linear pada delapan model
Skala dan cakupan
Pengujian dilakukan pada delapan model. Di antaranya GLM-5.2 — 753 miliar parameter, dan Kimi-K3 — 2,8 triliun parameter; hasil untuk model ini baru ditambahkan pada versi kedua artikel. Digunakan probe linear sederhana (linear probes) yang dilatih pada keadaan tersembunyi — pada dasarnya sebuah klasifier linear di atas vektor.
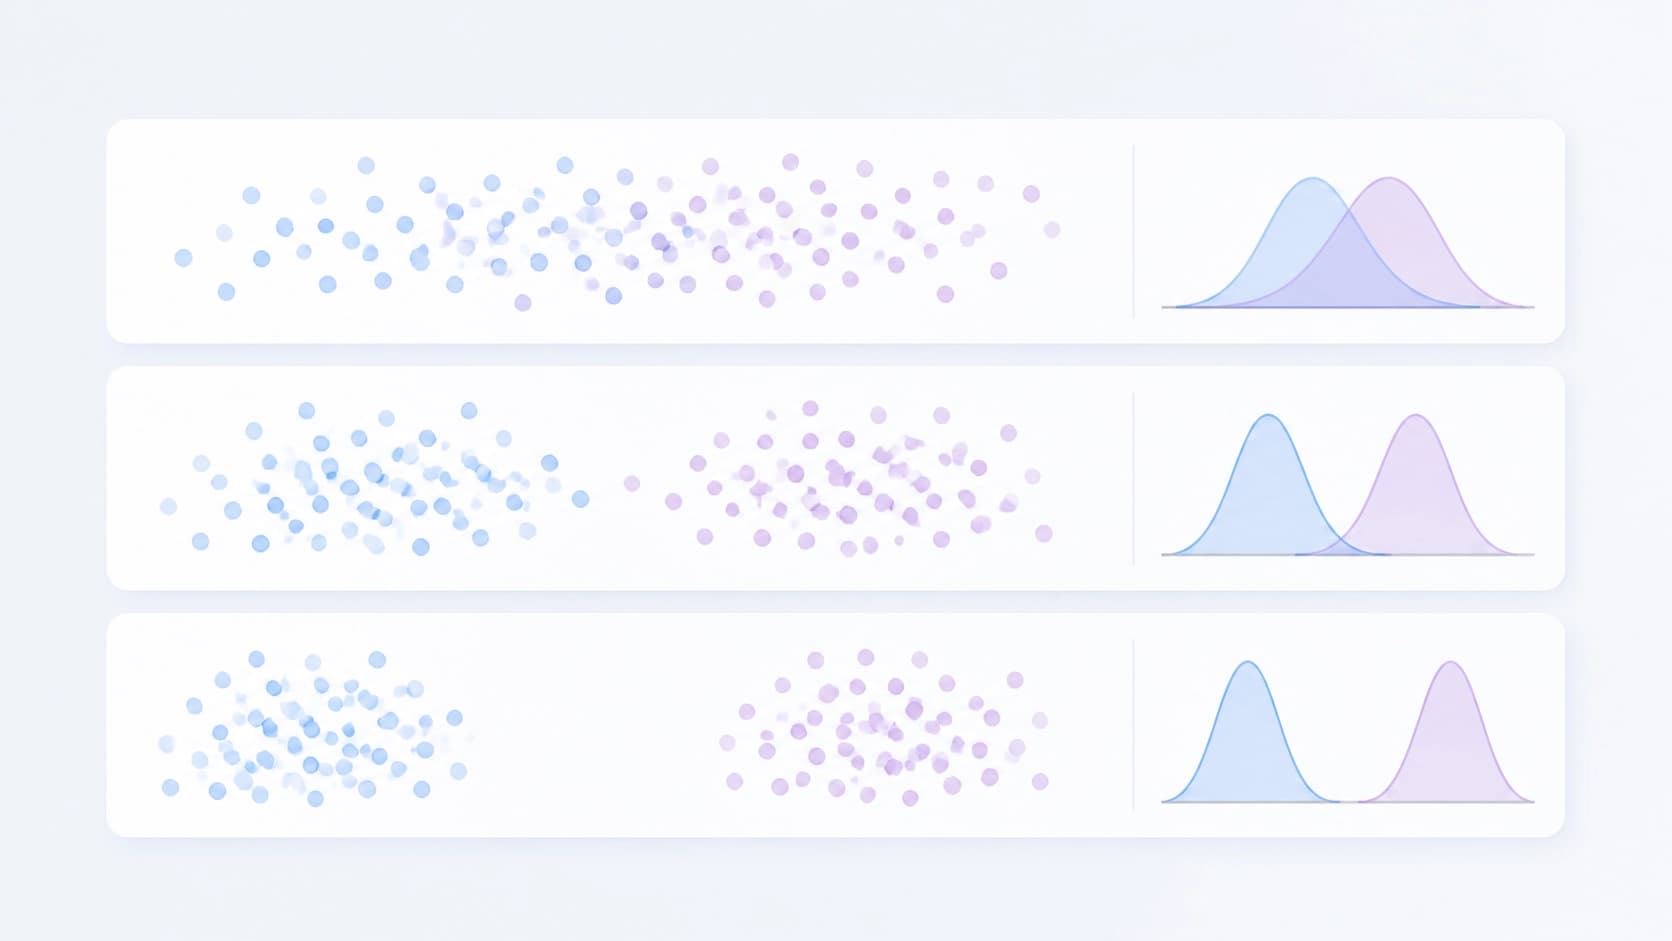
Singkatan AUROC di sini berarti kualitas pemisahan dua kelas: setelah dilatih pada satu data, probe menunjukkan 0,90+ pada serangan, instruksi agen, dan kumpulan tugas yang belum pernah dilihatnya sebelumnya. Dengan kata lain, pelatihannya tidak disesuaikan dengan skenario serangan tertentu.
Ketahanan sinyal
Lini eksperimen tersendiri di v2 dikhususkan untuk kemampuan generalisasi. Probe tetap mempertahankan kemampuan prediktifnya:
- terhadap serangan adaptif, yakni ketika penyerang berusaha menipu probe itu sendiri;
- dalam kondisi lintas bahasa, ketika contoh pelatihan dan pengujian berada dalam bahasa yang berbeda;
- pada jenis tugas dan instruksi baru yang tidak muncul saat pelatihan.
Justru trikotomi inilah yang biasanya menjadi titik terlemah dari detektor apa pun yang berbasis representasi internal, sehingga pengujiannya lebih penting daripada angka AUROC itu sendiri.
Jurang antara pengetahuan dan tindakan
Temuan paling tidak menyenangkan dari artikel ini adalah apa yang disebut knowledge-action gap. Model-model modern setelah pasca-pelatihan memang mengodekan sinyal yang memprediksi IPI exposure, tetapi tidak memanfaatkannya sebagai pemicu yang andal untuk perilaku aman. Model "merasakan" masalahnya dan tetap melangkah maju.
Penyebabnya, dilihat dari logika karyanya, adalah sinyal tersebut ada dalam representasi, tetapi tidak terhubung dengan koneksi yang stabil ke kebijakan tindakan. Baik penolakan biasa maupun instruksi dalam system prompt tidak menutup jurang ini — keduanya bekerja pada tingkat yang berbeda.
Pertahanan yang digerakkan oleh probe
Karena sinyalnya ada, masuk akal untuk memanfaatkannya secara langsung. Para penulis mengusulkan pertahanan di mana penalaran model hanya diaktifkan ketika probe mendeteksi exposure. Sederhananya: detektornya jarang dan tepat dalam menyala, sedangkan prosedur penelusuran yang mahal dijalankan atas perintahnya, bukan sepanjang waktu.
Pada konfigurasi rumit dari benchmark AgentDojo, pendekatan ini secara signifikan menurunkan proporsi serangan yang berhasil — misalnya, dari 34,6% menjadi nol pada Qwen3.5-27B. Detail pentingnya: pada tugas "bersih" yang tidak mengandung injeksi apa pun, metode ini mempertahankan kegunaan lebih baik daripada pertahanan dasar. Inilah yang biasanya kurang dari detektor — mereka entah menangkap sedikit, atau selalu mengganggu pekerjaan.
Apa yang "dikatakan" keadaan tersembunyi dengan kata-kata
Bagian ketiga dari karya ini adalah kerangka penjelasan. Para penulis mencari rumusan dalam bahasa alami yang berkorelasi kuat dengan apa yang dideteksi probe. Hasilnya semacam profil tekstual: ini menunjukkan "pikiran" seperti apa yang menyertai pemicuan detektor.
Yang menarik di sini adalah ketidakseragamannya. Pada sebagian model, sinyal laten bersesuaian dengan perasaan ancaman yang langsung — sesuatu seperti "dalam teks ini ada arahan yang tidak pernah diberikan kepadaku". Pada model lain, sinyal itu terikat pada ciri operasional tidak langsung: format data yang tidak biasa, sumber yang mencurigakan, konflik dengan tugas yang sedang berjalan. Artinya, detektor yang sama dapat bersandar pada mekanisme internal yang berbeda tergantung pada modelnya.
Apa artinya ini dalam praktik
Bagi mereka yang membangun sistem agen, kesimpulannya cukup praktis:
- Pemeriksaan bisa dilakukan sebelum tindakan. Sinyalnya tersedia pada masukan ke generasi — artinya, dapat disematkan ke dalam pipeline lebih awal sebelum agen memanggil alat.
- Probe linear adalah lapisan pertahanan yang murah. Ia jauh lebih ringan dibandingkan dengan lintasan kedua model atau klasifier eksternal untuk setiap permintaan.
- Jangan hanya mengandalkan prompt. Jurang pengetahuan-tindakan berarti bahwa "tolong abaikan instruksi dari dokumen" bukanlah jaminan, bahkan jika model memahami semuanya.
- Hitunglah biaya positif palsu. Argumen utama metode ini adalah ia tidak mengganggu pekerjaan pada tugas bersih, dan hal ini layak diuji pada trafik Anda sendiri.
Pertanyaan terbuka
Artikel ini menjawab pertanyaan "apakah ada sinyal" secara meyakinkan, tetapi meninggalkan beberapa hal yang tidak nyaman. Detektor berbasis keadaan tersembunyi adalah satu lagi permukaan serangan: jika penyerang tahu tentang probe tersebut, ia dapat mengoptimalkan injeksi agar sinyalnya tidak muncul. Ketahanan lintas bahasa sudah diuji, tetapi cakupan bahasa dan domainnya tetap terbatas pada data yang ada dalam eksperimen.
Pertanyaan lain adalah portabilitas. Probe dilatih untuk model tertentu: setiap arsitektur memiliki representasinya sendiri, dan "sensor" universal yang cukup dipasang ke API mana pun tidak dapat disimpulkan dari karya ini. Untuk model tertutup yang hanya menyediakan akses teks, metode ini pada prinsipnya tidak dapat diterapkan — dibutuhkan keadaan tersembunyi.
Meski demikian, arah ini tampak menjanjikan. Alih-alih berdebat tentang seberapa baik model mengikuti instruksi, para peneliti mengusulkan untuk melihat keadaan internalnya dan memastikan bahwa sinyal yang diperlukan sudah ada di sana. Selanjutnya adalah persoalan rekayasa: bagaimana mengubah pengetahuan ini menjadi tindakan secara andal.


