
Penyempurnaan model generatif gambar: mempertimbangkan preferensi dan kategori secara bersamaan
Artikel ini menjelaskan metode pascapelatihan model text-to-image dalam domain terbuka, dengan sinyal preferensi manusia yang dilengkapi pemeriksaan berbasis rubrik terhadap kesesuaian dengan prompt dan sifat yang diinginkan. Hasilnya menunjukkan bahwa perataan berbobot atas reward kalah dari skema yang diusulkan, sementara dalam snapshot Arena, Flux2dev dan Ideogram-4 yang telah disempurnakan menunjukkan peningkatan Elo yang signifikan.
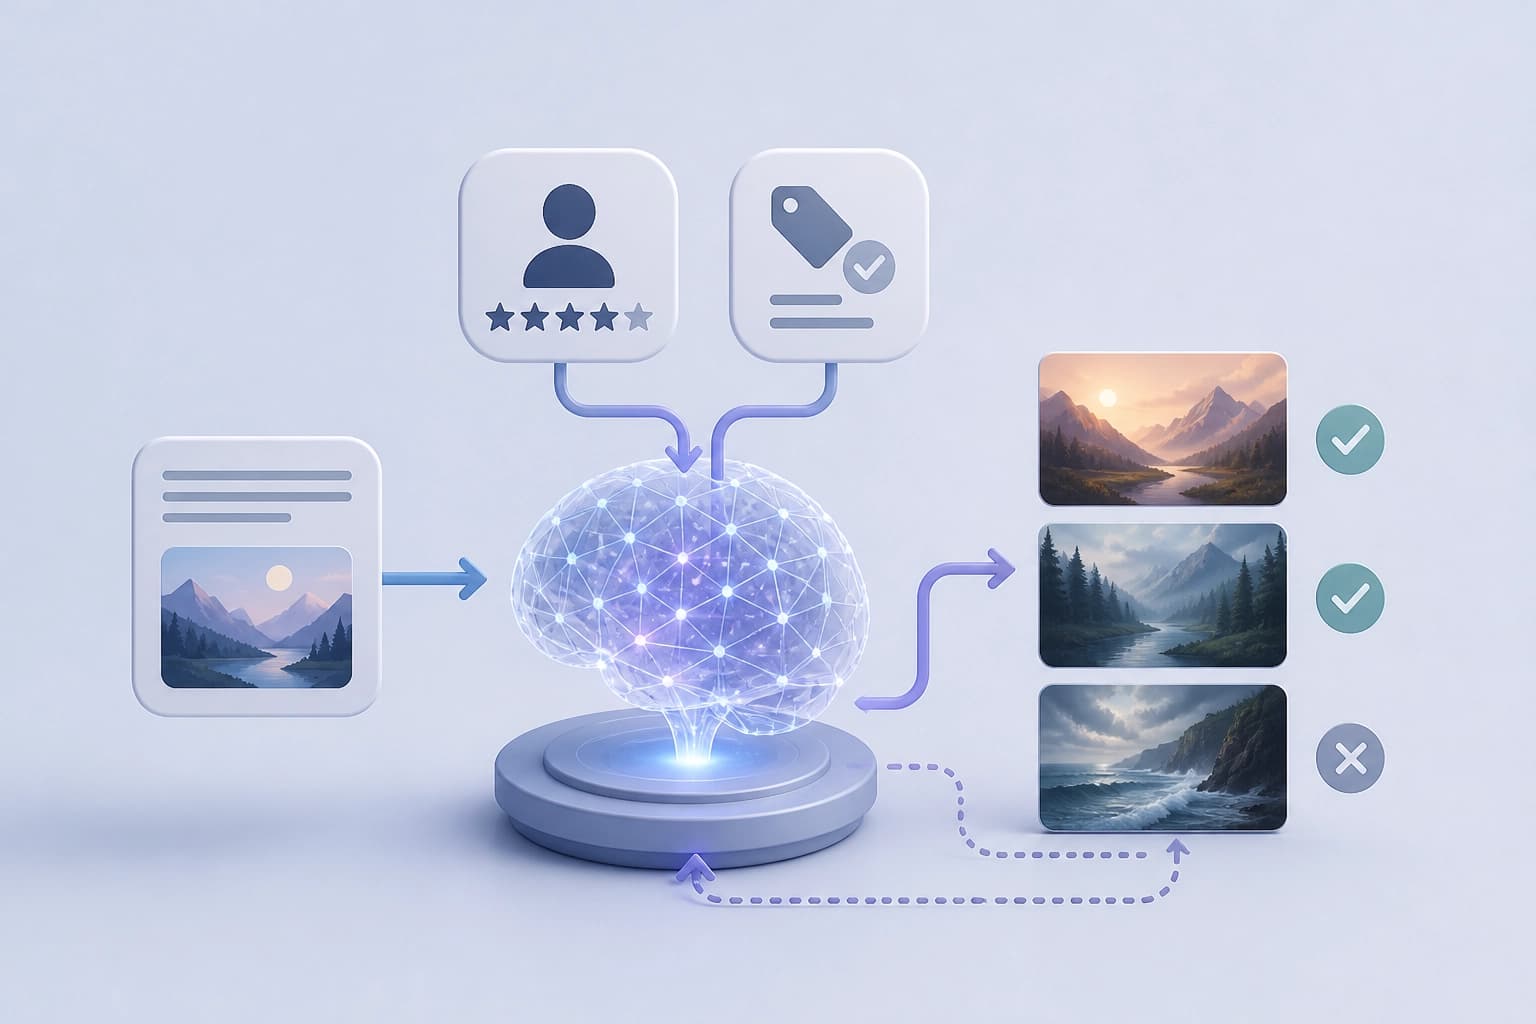
Tugas: domain terbuka dan dua sinyal
Pembuatan gambar dari teks dalam domain terbuka perlu mempertimbangkan berbagai persyaratan. Di antaranya adalah kesesuaian dengan prompt dan preferensi manusia. Satu sinyal reward tidak mencakup kedua jenis persyaratan tersebut. Makalah «Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards» mengusulkan pascapelatihan dengan kombinasi sinyal yang saling melengkapi.
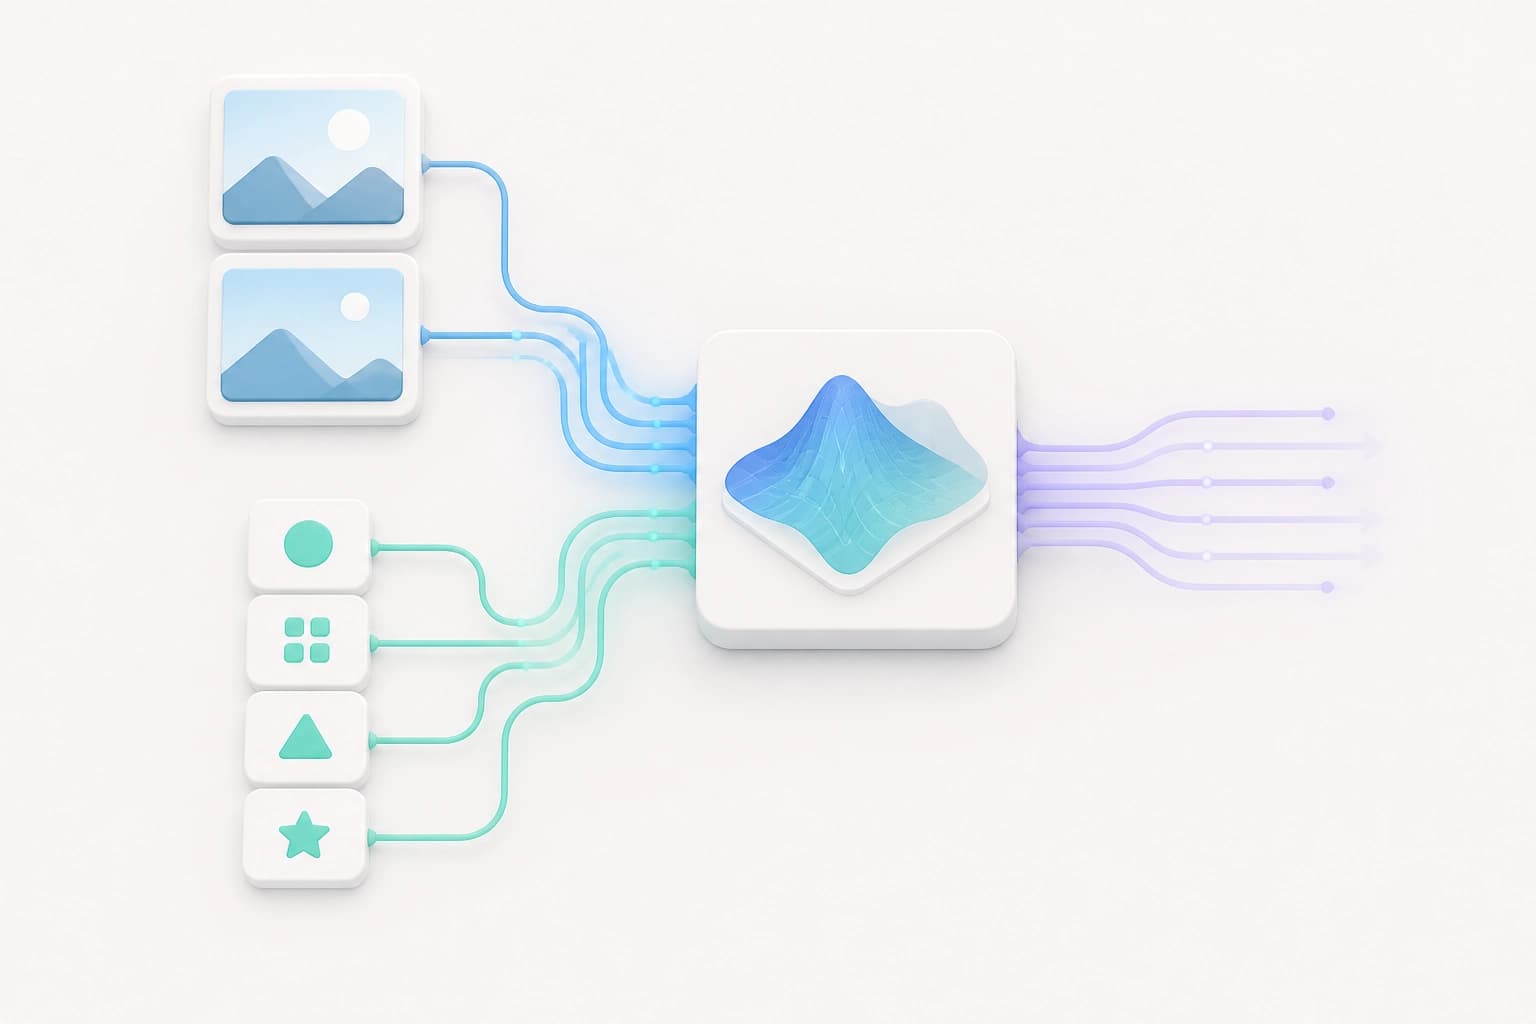
Metode ini menggabungkan reward preferensi dan reward berbasis rubrik. Sinyal pertama mencerminkan preferensi manusia. Sinyal kedua memeriksa kesesuaian dengan prompt dan karakteristik lain yang diinginkan. Kombinasi ini mencakup berbagai aspek permintaan. Kesimpulannya: untuk domain terbuka, kriteria pemilihan adalah adanya sinyal yang saling melengkapi, bukan hanya satu sinyal. Sinyal-sinyal tersebut harus mencakup pilihan subjektif dan pemenuhan tugas.
Struktur sistem reward
Sistem ini mencakup dua komponen utama. Reward preferensi dilatih menggunakan data preferensi manusia berskala besar. Bradley-Terry objective digunakan untuk pelatihan. Sinyal ini mencerminkan pilihan manusia.
Rubrik menilai kesesuaian dengan prompt dan karakteristik lain yang diinginkan. Rubrik juga memberikan perlindungan terhadap reward hacking. Kedua komponen menangani tugas yang berbeda dan saling melengkapi.
| Komponen | Berlandaskan pada | Apa yang diperiksa | Peran |
|---|---|---|---|
| Reward preferensi | Data preferensi manusia berskala besar, Bradley-Terry objective | Pilihan manusia saat membandingkan hasil | Optimisasi preferensi |
| Reward berbasis rubrik | Rubrik dengan kriteria | Kesesuaian dengan prompt dan karakteristik lain yang diinginkan | Perlindungan terhadap reward hacking |
Para penulis merumuskan persyaratan untuk reward yang efektif. Reward tersebut harus mencakup niat pengguna secara luas. Reward juga harus tahan terhadap eksploitasi selama optimisasi.
Kesimpulannya: kriteria pemilihan adalah rubrik harus melengkapi preferensi, bukan menggantikannya. Sistem tanpa rubrik kehilangan perlindungan terhadap reward hacking. Sistem tanpa preferensi tidak berlandaskan pilihan manusia.
Mengombinasikan, bukan sekadar menghitung rata-rata
Para penulis melaporkan adanya masalah dengan rata-rata tertimbang yang naif. Saat dioptimalkan, cara merata-ratakan seperti ini menghasilkan perilaku yang tidak optimal. Makalah ini mengusulkan strategi untuk mengombinasikan reward. Strategi ini menyeimbangkan optimisasi preferensi dan pemenuhan rubrik dengan lebih efektif.
| Pendekatan | Dampak saat optimisasi |
|---|---|
| Rata-rata tertimbang yang naif | Perilaku menjadi tidak optimal |
| Strategi kombinasi | Optimisasi preferensi dan pemenuhan rubrik diseimbangkan dengan lebih efektif |
Strategi kombinasi menjadi bagian tersendiri dari metode ini. Kesimpulannya: kriteria pemilihan adalah adanya strategi kombinasi, bukan sekadar sekumpulan reward. Bobot sinyal tanpa strategi tidak menjamin perilaku yang diinginkan.
Hasil dalam peringkat Arena text-to-image
Dalam peringkat Arena text-to-image, model Flux2dev memperoleh skor Elo 69 poin lebih tinggi daripada model dasar. Model ini menjalani pelatihan RL. Setelah pascapelatihan, model Ideogram-4 mengungguli semua model open source. Skor Elo-nya mencapai 1223.5.
Data ini menunjukkan dampak pascapelatihan dalam konteks peringkat tersebut. Data ini tidak menggambarkan skenario penggunaan lainnya.
| Model | Hasil | Dibandingkan dengan |
|---|---|---|
| RL-trained Flux2dev | Skor Elo 69 poin lebih tinggi | Model dasar |
| Post-trained Ideogram-4 | Skor Elo 1223.5 | Semua model open source |
Kesimpulannya: kriteria evaluasi adalah melihat model dasar dan kondisi pelatihan. Untuk Flux2dev, para penulis menyajikan peningkatan relatif terhadap model dasar. Untuk Ideogram-4, mereka mencatat posisinya di antara model open source.
Batasan cuplikan peringkat dan data
Klaim tentang hasil terdepan mengacu pada cuplikan Arena per 4 September 2026. Cuplikan tersebut mencatat kondisi peringkat pada tanggal itu. Para penulis merilis Arena-T2I-Training. Ini merupakan subset data pelatihan dengan ukuran 1K.
Subset ini memungkinkan sebagian peningkatan dari pelatihan penuh direproduksi. Sebagian peningkatan lainnya tidak tercakup dalam subset tersebut. Untuk memverifikasi metode ini, penting untuk membedakan hasil penuh dari bagian yang dapat direproduksi.
Kesimpulannya: kriteria pemilihan adalah mempertimbangkan tanggal cuplikan dan batas reproduksibilitas. Klaim tanpa batasan tersebut belum lengkap.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Benchmark Zero2Repo: Batas kemampuan membangun proyek secara mandiri dari direktori kosong
Penelitian ini mengusulkan untuk mengevaluasi agen pemrograman pada seluruh proses pembangunan repositori: inputnya adalah spesifikasi, kontrak antarmuka, dan lingkungan kosong; evaluasinya menggunakan tes tersembunyi tanpa penilai LLM. Bahkan agen terkemuka jarang berhasil melewati semua pemeriksaan, dan sebagian besar kegagalan disebabkan oleh persyaratan tertentu yang terlewat.
13 November 2026
FedSocket: Model yang dapat dipertukarkan dengan kemampuan eksekusi wajib di pihak penerima dalam heterogenitas multimodal
Diperkenalkan FedSocket—pendekatan yang mengharuskan model yang dipertukarkan dapat dijalankan di sisi penerima, sementara model-model privat yang heterogen dihubungkan oleh antarmuka prediksi bersama Q. Artikel ini menjelaskan agregasi berbasis keanggotaan, pengiriman hanya parameter Q beserta penghitung, serta eksperimen pada enam dataset yang menunjukkan peningkatan akurasi saat modalitas tidak tersedia dan keunggulan inferensi Joint dibandingkan ensemble independen.
13 November 2026
CyberArena: pertandingan head-to-head antaragen AI mengungkap keterbatasan benchmark siber statis
Benchmark ini menempatkan dua agen dalam sandbox dengan layanan yang terus berubah, lalu merangkum tindakan mereka dalam serangkaian putaran menjadi skor multidimensi untuk kemampuan menyerang dan bertahan. Dalam 466 pertandingan dengan 12 model mutakhir, benchmark ini membedakan kemampuan yang tak terungkap dalam pengujian satu arah yang sudah mencapai batas atas, termasuk perencanaan beberapa langkah ke depan dan pembuatan backdoor.
13 November 2026