
Benchmark Zero2Repo: Batas kemampuan membangun proyek secara mandiri dari direktori kosong
Penelitian ini mengusulkan untuk mengevaluasi agen pemrograman pada seluruh proses pembangunan repositori: inputnya adalah spesifikasi, kontrak antarmuka, dan lingkungan kosong; evaluasinya menggunakan tes tersembunyi tanpa penilai LLM. Bahkan agen terkemuka jarang berhasil melewati semua pemeriksaan, dan sebagian besar kegagalan disebabkan oleh persyaratan tertentu yang terlewat.
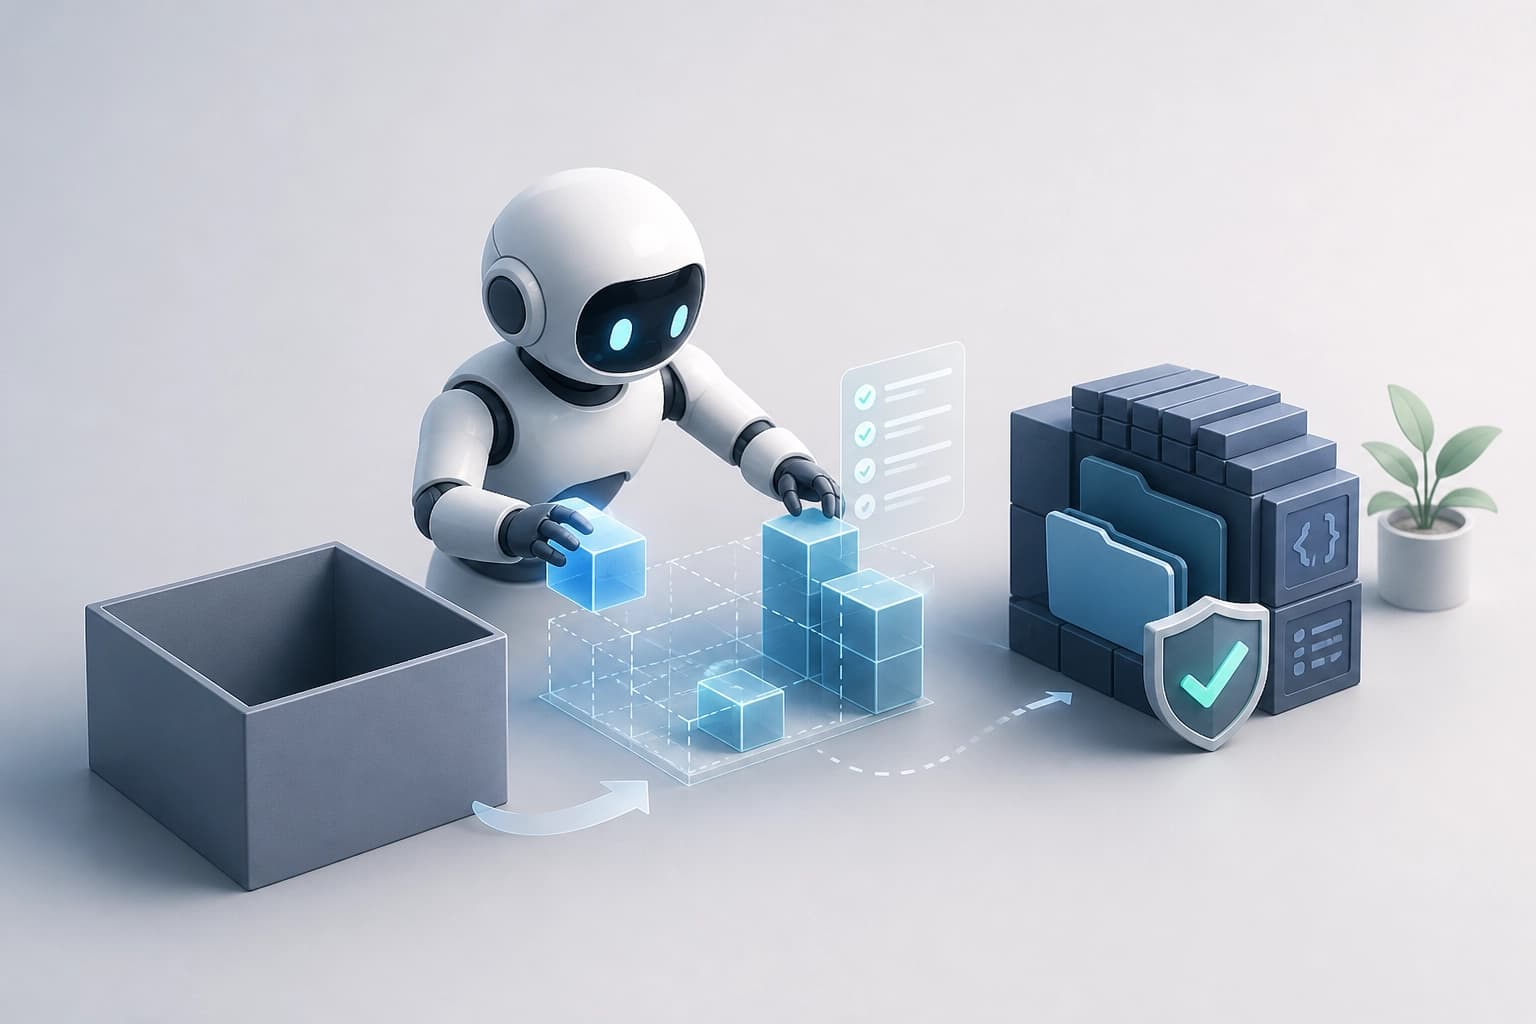
Apa yang diuji Zero2Repo
Benchmark ini menilai apakah agen pengodean dapat membuat repositori dari nol. Agen menerima dokumen persyaratan produk, kontrak antarmuka, dan ruang kerja kosong. Agen harus menyediakan repositori lengkap dalam ekosistem yang sesuai dengan proyek.
Evaluasi mencakup proses membangun proyek secara menyeluruh. Penilaian didasarkan pada repositori yang telah selesai.
- Masukan: dokumen persyaratan produk, kontrak antarmuka, ruang kerja kosong.
- Keluaran: repositori lengkap dalam ekosistem yang sesuai dengan proyek.
- Hal yang dinilai: kemampuan membuat repositori dari nol.
Kesimpulan: benchmark ini menguji pembangunan mandiri dari direktori kosong. Kriteria praktis: gunakan benchmark ini untuk menilai agen dalam tugas membangun proyek secara menyeluruh.
Cara tugas dibuat
Pipeline ini membuat tugas dengan cara yang tidak bergantung pada bahasa pemrograman. Pipeline mengambil proyek sumber terbuka nyata dengan versi yang telah ditetapkan. Lalu, pipeline mengubahnya menjadi spesifikasi perilaku, lingkungan yang dapat direproduksi, dan tes penerimaan tersembunyi.
Tahapan:
- Memilih proyek sumber terbuka nyata dengan versi yang telah ditetapkan.
- Mengubahnya menjadi spesifikasi perilaku.
- Menyiapkan lingkungan yang dapat direproduksi.
- Menyusun tes penerimaan tersembunyi.
Validasi:
- Implementasi acuan dari proyek sumber lolos tes.
- Pemeriksaan adversarial memastikan tes menolak implementasi yang keliru.
Kesimpulan: tugas ini berlandaskan implementasi acuan dan tes yang telah melewati pemeriksaan adversarial. Kriteria praktis: periksa apakah tes divalidasi, bukan hanya apakah tugas dijelaskan.
Cara agen dievaluasi
Benchmark ini mengevaluasi agen pengodean untuk penggunaan produksi dalam kontainer terisolasi. Tes penerimaan tetap tersembunyi hingga solusi dikirimkan secara eksplisit. Hadiahnya bersifat biner: hadiah hanya diberikan jika semua tes lolos. Benchmark ini tidak menggunakan juri LLM.
Kriteria:
- Kontainer terisolasi untuk agen.
- Tes tersembunyi hingga solusi dikirimkan.
- Hadiah biner jika semua tes lolos.
- Tidak menggunakan juri LLM.
Kesimpulan: tes yang hanya lolos sebagian tidak menghasilkan hadiah. Kriteria praktis: evaluasi yang mensyaratkan semua tes tersembunyi lolos cocok untuk membandingkan agen.
Bahasa dan cakupan rilis saat ini
Pipeline dan sistem pengujian tidak mengasumsikan bahasa pemrograman tertentu. Rilis saat ini mencakup tugas dalam Python, TypeScript, Go, dan C++.
Isi rilis:
- Python.
- TypeScript.
- Go.
- C++.
Kesimpulan: benchmark ini tidak terbatas pada satu bahasa, tetapi kumpulan tugas saat ini hanya mencakup empat bahasa. Kriteria praktis: cocokkan bahasa proyek dengan bahasa yang tersedia dalam rilis.
Batasan yang terlihat dari hasil
Batasan terlihat pada kumpulan yang terdiri dari 11 tugas. Tugas-tugas ini diambil dari repositori yang kemungkinan besar pernah ditemui model terdepan selama pelatihan.
Hal yang ditunjukkan oleh hasil:
- Agen terkuat menyelesaikan 10 dari 11 tugas.
- Setiap pengiriman yang gagal lolos 90-99% tes tersembunyi.
- Pada dua agen terkuat, 67-100% tes yang gagal berkaitan dengan satu kelalaian atau aturan langka dalam spesifikasi.
- Kegagalan berkaitan dengan ketepatan mengikuti spesifikasi, bukan dengan tidak adanya subsistem.
- Penulis menyebut setiap kegagalan tersebut sebagai sasaran spesifik untuk perbaikan.
Kesimpulan: batas kemampuan membangun secara mandiri tampak pada kemampuan mempertahankan aturan langka dan kelengkapan spesifikasi. Kriteria praktis: periksa bagaimana agen mempertahankan aturan langka dalam spesifikasi, bukan hanya kemampuannya membangun subsistem.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
FedSocket: Model yang dapat dipertukarkan dengan kemampuan eksekusi wajib di pihak penerima dalam heterogenitas multimodal
Diperkenalkan FedSocket—pendekatan yang mengharuskan model yang dipertukarkan dapat dijalankan di sisi penerima, sementara model-model privat yang heterogen dihubungkan oleh antarmuka prediksi bersama Q. Artikel ini menjelaskan agregasi berbasis keanggotaan, pengiriman hanya parameter Q beserta penghitung, serta eksperimen pada enam dataset yang menunjukkan peningkatan akurasi saat modalitas tidak tersedia dan keunggulan inferensi Joint dibandingkan ensemble independen.
13 November 2026
CyberArena: pertandingan head-to-head antaragen AI mengungkap keterbatasan benchmark siber statis
Benchmark ini menempatkan dua agen dalam sandbox dengan layanan yang terus berubah, lalu merangkum tindakan mereka dalam serangkaian putaran menjadi skor multidimensi untuk kemampuan menyerang dan bertahan. Dalam 466 pertandingan dengan 12 model mutakhir, benchmark ini membedakan kemampuan yang tak terungkap dalam pengujian satu arah yang sudah mencapai batas atas, termasuk perencanaan beberapa langkah ke depan dan pembuatan backdoor.
13 November 2026
Ketahanan detektor terhadap teks buatan mesin yang diparafrasekan: temuan pengujian
Artikel ini merangkum hasil pengujian alat yang menulis ulang teks hasil generasi agar terdengar lebih alami. Setelah diproses, kemungkinan terdeteksi menurun secara signifikan, sementara positif palsu yang masih muncul membuat hasil detektor tidak dapat dianggap sebagai bukti.
13 November 2026