
Apa yang dirilis ke open source
Perdebatan tentang "model mana yang lebih baik" hampir selalu terhenti pada satu masalah: tidak ada yang memverifikasi angkanya. Pengukuran dilakukan di mesin berbeda, dengan kuantisasi berbeda, di build runtime berbeda — dan membandingkannya satu sama lain menjadi tidak bermakna. Perusahaan Liquid AI menawarkan solusi melalui keterbukaan dan reproduksibilitas: mereka merilis Pipette, platform untuk benchmarking model fundamental di perangkat edge. Metodologinya divalidasi secara independen oleh Artificial Analysis.
Gagasan utama yang menopang seluruh konstruksi ini: perilaku di perangkat adalah properti dari sistem yang di-deploy, bukan model secara terisolasi. Artinya, unit pengukurannya juga bukan "model", melainkan konfigurasi lengkap: bobot plus skema kuantisasi plus lingkungan eksekusi plus perangkat keras spesifik. Dari tesis ini tumbuh struktur dataset, dan cara membaca semua perbandingan di bawah.
Apa yang masuk ke dataset awal
- lima metrik performa di perangkat;
- lebih dari seribu konfigurasi dalam kombinasi model × kuantisasi × lingkungan eksekusi × perangkat × panjang konteks;
- lebih dari 30 model dan beberapa format kuantisasi;
- build llama.cpp untuk macOS, iOS, Windows, dan Android;
- panjang konteks dari 256 hingga 8.192 token.
Pengukuran pertama yang dipublikasikan dilakukan pada MacBook Pro dengan M5 Max, iPhone 17 Pro, dan Galaxy S26 Ultra. Untuk AMD Ryzen AI Max+ 395 dan Radeon 8060S, hasilnya masih ditandai sebagai "coming soon" — artinya platform ini sejak awal dinyatakan sebagai lintas platform, tetapi cakupan perangkat kerasnya masih terus bertambah.
Empat kesimpulan dari pengujian pertama
Parameter sama — perilaku berbeda pada konteks panjang
Ilustrasi bagus tentang mengapa pengukuran semacam ini diperlukan. Dua model dengan 350M parameter pada Q4_K_M yang sama di ponsel yang sama berperilaku berbeda saat token input bertambah: Granite-4.0-H-350M mempertahankan 78,4% throughput decoding saat beralih dari 256 ke 4.096 token input, sedangkan Granite-4.0-350M hanya 33,8%. Jumlah parameter di sini tidak memberi petunjuk apa pun: perbedaannya terletak pada arsitektur dan bagaimana arsitektur itu cocok dengan runtime dan chip tertentu.
Aktivasi sparse menghemat komputasi, tetapi tidak menghemat memori
LFM2.5-8B-A1B pada ponsel yang sama dengan 2.048 token input melakukan decoding 2,4 kali lebih cepat daripada Qwen3.5-4B, dan 2,6 kali lebih cepat daripada Ministral-3-3B-Instruct-2512. Rahasianya ada pada aktivasi sparse: untuk setiap token, sekitar 1,5B dari 8,5B parameter diaktifkan. Namun konsumsi memori puncaknya tetap 5,29 GiB, karena semua bobot expert tetap harus berada di memori secara keseluruhan. Kesimpulan praktisnya: arsitektur mirip MoE unggul dalam waktu, tetapi tidak menyelamatkan anggaran RAM — dan di ponsel, batasnya sering kali justru pada memori.
Lebih cepat — bukan berarti lebih berkualitas
Pada iPhone 17 Pro dengan Q4_K_M, MiniCPM5-1B menyelesaikan beban 2.048 token input / 256 token output dalam 3,47 detik, sedangkan LFM2.5-1.2B-Instruct dalam 4,12 detik, artinya yang pertama 15,8% lebih cepat. Namun pada artefak yang sama, LFM meraih 9,0 poin lebih tinggi pada MATH-500. Throughput dan kualitas adalah sumbu yang berbeda, dan memilih model berdasarkan satu angka di tabel adalah tidak masuk akal.
Profil sistem yang hampir identik bisa menyembunyikan perbedaan pada tugas
Pada M5 Max dengan Q4_K_M dan 2.048 token input, Granite-4.1-8B dan Ministral-3-8B-Instruct-2512 hanya berbeda 2,4% pada throughput decoding dan 1,2% pada RAM puncak. Namun pada tugas, gambarannya berubah: Granite unggul 7,3 poin pada IFBench, sedangkan Ministral mengunggulinya 14,0 poin pada GPQA Diamond. Perbedaan pada profil "perangkat keras" berada dalam batas noise, perbedaan pada perilaku bersifat fundamental.
Bagaimana pengukuran dilakukan
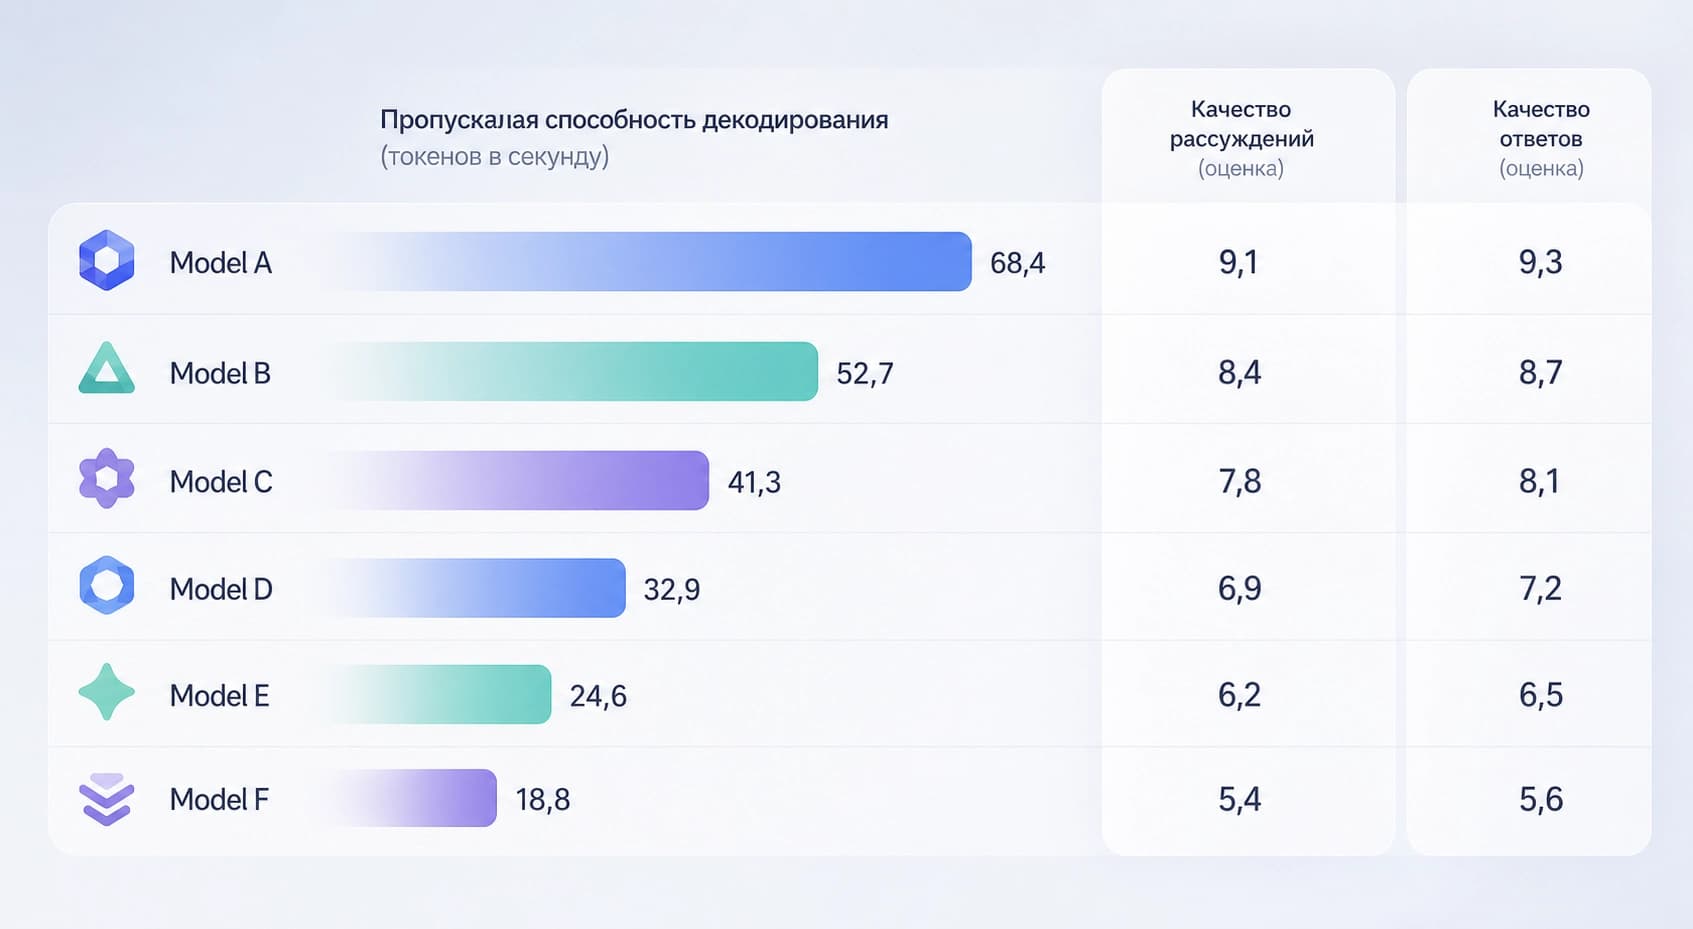
Pengujian performa dibangun berdasarkan bentuk token tetap, decoding greedy, warm-up yang dibuang, dan lima pengulangan terukur. Sebelum setiap pengulangan, readiness gating diaktifkan: pemeriksaan spesifik platform memastikan kondisi termal dan beban latar belakang sesuai standar. Pengujian yang gagal tidak dipublikasikan — inilah yang membedakan benchmark yang dapat direproduksi dari skrip sekali jalan.
Cerita tersendiri adalah kualitas. Kualitas tidak diukur dengan pengujian yang sama: untuk ini digunakan IFBench, GPQA Diamond, dan MATH-500, dan skornya diambil dari eksekusi evaluasi llama.cpp pada sistem referensi dengan NVIDIA H100 80GB. Selanjutnya skor tersebut dibandingkan dengan pengujian di perangkat untuk model dan kuantisasi yang sama. Konsekuensi pentingnya: angka kualitas yang berdampingan dengan throughput ponsel tidak diperoleh di ponsel. Ini metrik yang berguna untuk membandingkan model satu sama lain, tetapi bukan pengukuran apa yang terjadi pada smartphone tertentu.
Apa saja yang dirilis ke open source
Pipette dirilis sepenuhnya, tanpa waitlist:
- infrastruktur di bawah Apache 2.0 — repositori pipette-mgmt, pipette-clients, dan pipette-scores;
- dataset hasil publik;
- dasbor yang dihosting;
- aplikasi benchmarking native untuk iOS dan Android.
Satu-satunya bagian yang belum siap untuk akses umum adalah publikasi hasil yang dikirim komunitas: masih dalam beta. Sisanya dapat dijalankan sendiri, termasuk men-deploy pipeline di dalam perimeter sendiri.
Untuk siapa dan mengapa ini diperlukan
Cara termudah mendeskripsikan audiens target: ini adalah tim mana pun yang merilis model ke perangkat keras yang tidak mereka miliki sendiri. Selanjutnya, variasinya berbeda berdasarkan skala.
- Pengembang solo dan startup tahap seed cukup dengan dasbor dan aplikasi mobile — infrastruktur sendiri tidak diperlukan.
- Tim produk berukuran menengah dapat men-deploy klien pada perangkat internal mereka dan mendapatkan pengukuran pada konfigurasi mereka sendiri.
- OEM besar, produsen chip, dan perusahaan dapat menyimpan seluruh pipeline di balik firewall — yang menghilangkan pertanyaan tentang ke mana data pengukuran pergi.
Tugas-tugas umum juga jelas tanpa penjelasan berlebihan: memilih model dan format kuantisasi sebelum tugas sprint ditetapkan; membenarkan pembelian SoC atau perangkat keras; menangkap regresi saat memperbarui runtime, OS, atau driver; merencanakan kapasitas berdasarkan panjang konteks; memverifikasi klaim pemasaran vendor secara independen. Industrinya — elektronik konsumen dan OEM smartphone, otomotif, industri dan robotika, perangkat medis, layanan keuangan, pertahanan: di mana pun latensi, privasi, atau ketiadaan koneksi memaksa model dijalankan langsung di perangkat.
Apa yang perlu diperhatikan sebelum mempercayai angka
Tiga hal yang mudah terlupakan saat membaca tabel pengukuran apa pun.
Pertama, angka kualitas dan angka performa berasal dari tempat yang berbeda. Throughput diukur di perangkat, kualitas diukur pada sistem referensi dengan H100 lalu dibandingkan. Untuk membandingkan model, ini tepat; untuk memprediksi perilaku pada aplikasi tertentu, tidak.
Kedua, kuantisasi tidak bisa diabaikan. Format yang sama pada model berbeda dan runtime berbeda menghasilkan hasil yang berbeda, dan batasan memori sering menjadi penentu — seperti pada contoh aktivasi sparse, di mana kecepatan meningkat, tetapi 5,29 GiB tidak hilang.
Ketiga, performa yang sama tidak mengatakan apa pun tentang bagaimana model akan menangani tugas-tugas tertentu. Perbedaan Granite dan Ministral pada IFBench dan GPQA Diamond dengan profil sistem yang hampir identik — justru merupakan kasus di mana kita harus menentukan tugasnya terlebih dahulu, baru kemudian melihat tabel.


