
Model dunia untuk agen berbasis LLM tertutup: koreksi pada titik risiko
PAWM diusulkan sebagai prediktor eksternal yang tidak menduplikasi observasi langkah demi langkah, tetapi aktif saat kegagalan mungkin terjadi dan mengarahkan agen menjauhi tindakan yang keliru. Setelah SFT pada skenario sintetis dan pelatihan bersama GRPO, metode ini menghasilkan peningkatan 24,3% di ScienceWorld dan 7,7% di WebArena-Lite untuk Claude Sonnet 4.5.
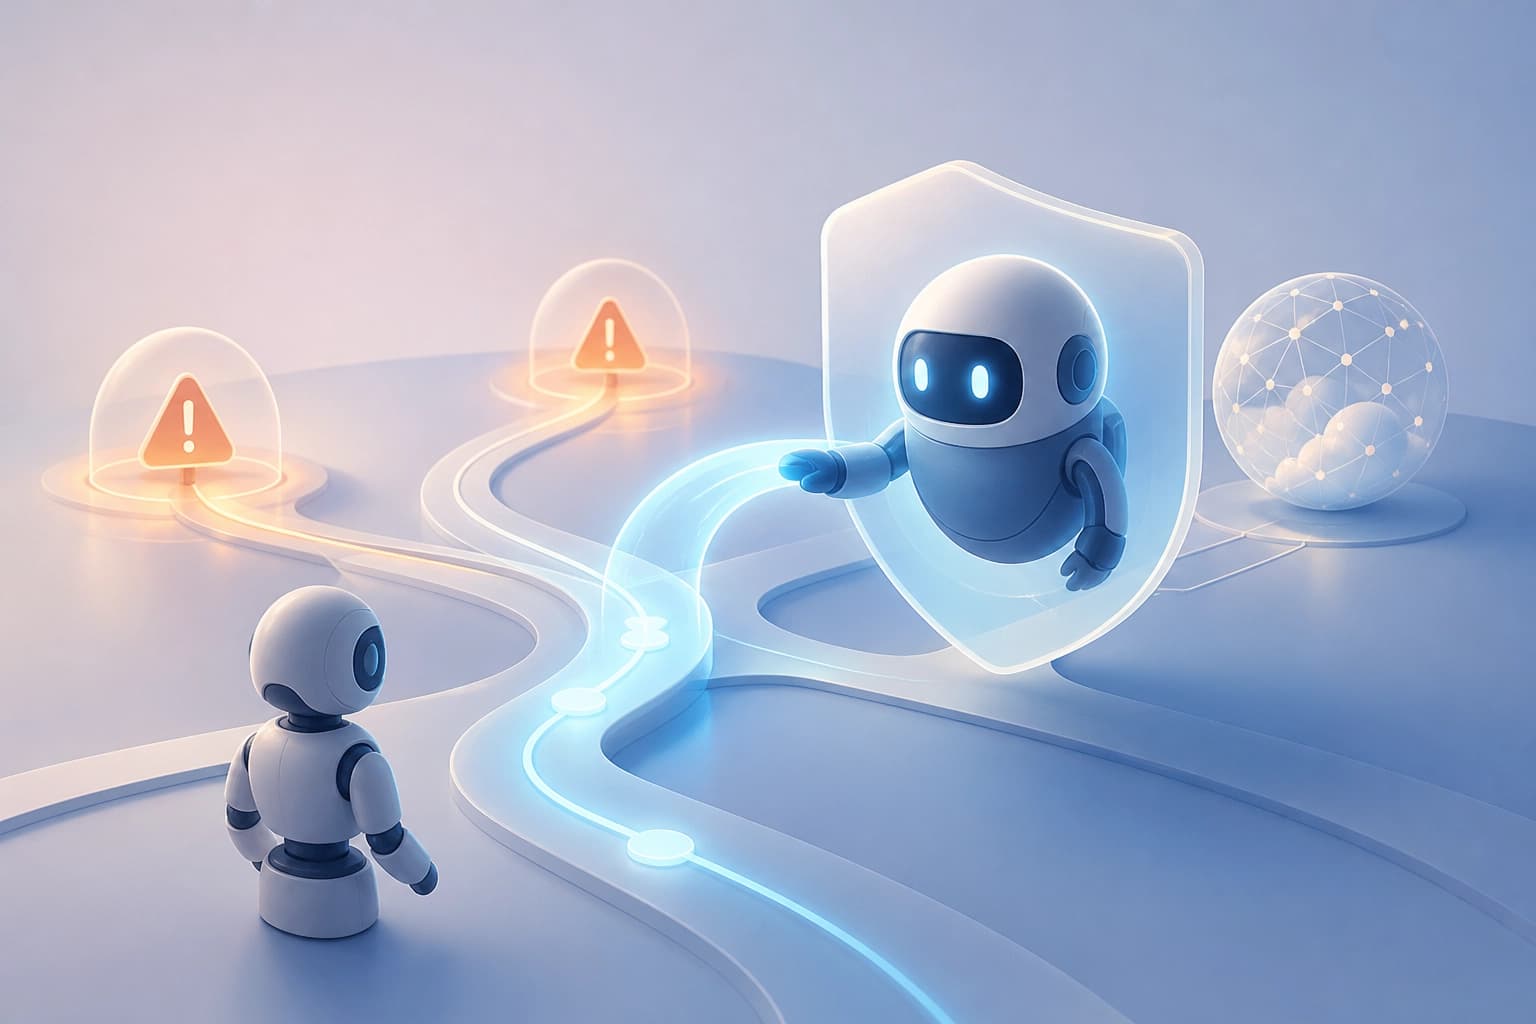
Masalah: agen kekurangan pengetahuan tentang lingkungan
Agen mutakhir berbasis LLM tipe «kotak hitam» mampu menangani penalaran jangka panjang dan menghasilkan tindakan secara akurat. Namun, mereka tidak memiliki pengetahuan yang telah dipelajari tentang bagaimana lingkungan berkembang untuk tugas agen tertentu. Artikel arXiv:2610.29139, yang diajukan pada 21 Oktober 2026, menguraikan kesenjangan ini.
Model dunia memberi agen pengetahuan tentang lingkungan tertentu. Model ini memprediksi respons lingkungan terhadap tindakan yang akan dilakukan agen. Dengan demikian, model ini menambahkan informasi yang spesifik untuk tugas.
Kriteria praktis: periksa keterkaitan model dunia dengan lingkungan target. Pengetahuan umum tentang penalaran tidak menutup kesenjangan dalam memahami tugas tertentu.
Mode koreksi: bukan di setiap langkah, melainkan di titik risiko
Model dunia sebelumnya untuk agen LLM terutama memprediksi observasi berikutnya pada setiap langkah. Mode ini mahal dan kurang informatif. Observasi individual hanya memberikan panduan terbatas yang relevan dengan tugas. Prediksi ke depan tidak diperlukan di setiap langkah.
Studi percontohan menunjukkan bahwa panduan dari model dunia paling berguna ketika model tersebut mengantisipasi jebakan dalam rentang beberapa langkah ke depan yang terbatas. Artinya, koreksi sebaiknya diaktifkan di titik risiko, bukan dijalankan terus-menerus.
| Opsi | Yang diketahui |
|---|---|
| Prediksi langkah demi langkah | Memprediksi observasi berikutnya pada setiap langkah; mahal dan kurang informatif. |
| Antisipasi jebakan | Mengantisipasi jebakan dalam rentang beberapa langkah ke depan yang terbatas; memberikan panduan paling berguna. |
Kriteria praktis: pilih mode yang aktif saat ada potensi jebakan dan tidak menghabiskan upaya prediksi untuk setiap langkah.
Cara kerja antisipasi jebakan
Para penulis memperkenalkan Pitfall Anticipation World Model (PAWM). Model ini bekerja melalui tiga elemen:
- melakukan intervensi secara selektif ketika muncul potensi jebakan;
- memprediksi kegagalan yang akan segera terjadi;
- mengarahkan agen menjauhi jebakan di titik risiko.
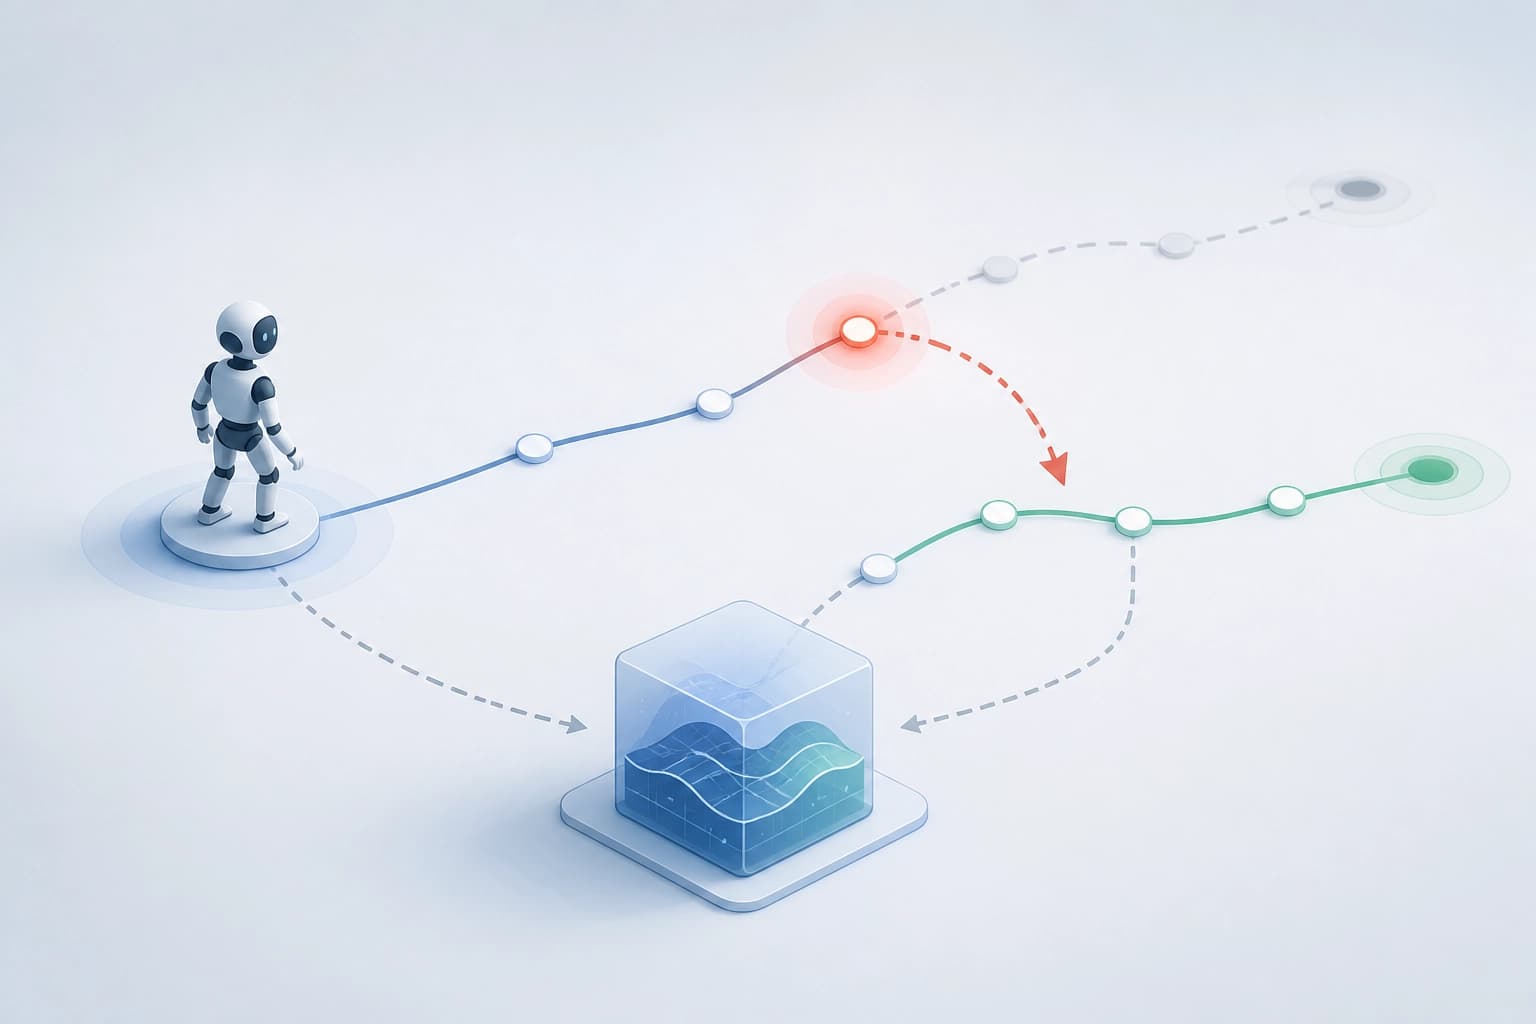
Kriteria praktis: pemicu koreksi harus didasarkan pada potensi jebakan dan prediksi kegagalan yang akan segera terjadi.
Pelatihan model dalam dua tahap
Para penulis melatih Pitfall Anticipation World Model (PAWM) dalam dua tahap.
- Supervised Fine-Tuning (SFT) pada data sintetis. Data sintetis tersebut berisi anotasi jebakan bagi agen.
- Co-training GRPO dengan LLM tipe «kotak hitam». Metode ini mengoptimalkan model di lingkungan target.
Kriteria praktis: periksa kedua tahap tersebut—anotasi jebakan dan co-training di lingkungan target.
Evaluasi: di mana melihat peningkatan
Metode ini meningkatkan hasil Claude Sonnet 4.5 sebesar 24.3% di ScienceWorld dan 7.7% di WebArena-Lite.
| Lingkungan | Peningkatan untuk Claude Sonnet 4.5 |
|---|---|
| ScienceWorld | 24.3% |
| WebArena-Lite | 7.7% |
Para penulis juga menyatakan bahwa model ini mengungguli sejumlah metode dasar. Kriteria praktis: lihat peningkatan di lingkungan target dan bandingkan dengan metode dasar. Transfer hasil antarlingkungan perlu diuji secara terpisah.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026
Lapisan klasifikasi di atas SpeechLLM: keunggulannya dibandingkan pembuatan label dalam pengenalan emosi
Dengan menggunakan dataset IEMOCAP dan MELD, keluaran generatif berupa label emosi dibandingkan dengan pengklasifikasi linear yang diterapkan pada representasi tersembunyi SpeechLLM yang ringkas. Peningkatan kualitas dari pengklasifikasi ini tidak berlaku universal: hasilnya bergantung pada korpus dan apakah yang digunakan adalah transkrip acuan atau hasil ASR.
4 November 2026
Dari penilaian individual ke himpunan yang memenuhi syarat: dekode global dengan kendala DDI
Artikel ini membandingkan pemilihan kombinasi obat kompatibel global yang optimal, yang diterapkan melalui mixed-integer linear programming, dengan beberapa skema penyelesaian konflik DDI secara lokal menggunakan skor FLAME tetap pada MIMIC-III. Pada set uji, pendekatan global memberikan peningkatan Jaccard yang kecil tetapi konsisten, yang makin besar saat batasan diperketat dan mencapai +0.0064 dibandingkan metode lokal terbaik.
4 November 2026