
Tugas yang dapat diverifikasi dan pelatihan lanjutan pada lintasan panjang: bagaimana Navalia memperkuat agen LLM kooperatif
Karya ini menjelaskan sebuah kerangka kerja yang, berdasarkan laporan keuangan perusahaan, membangun rantai komputasi dengan bukti yang dapat ditelusuri, memvalidasinya secara independen, lalu menerapkannya untuk SFT dan RL. Dengan Qwen3.6-35B-A3B, pipeline ini menghasilkan peningkatan pada lima benchmark dan, menurut penulis, meningkatkan pengaitan bukti, penggunaan alat, serta penyelesaian tugas jangka panjang, termasuk skenario perkantoran.
Tugas yang diselesaikan Navalia
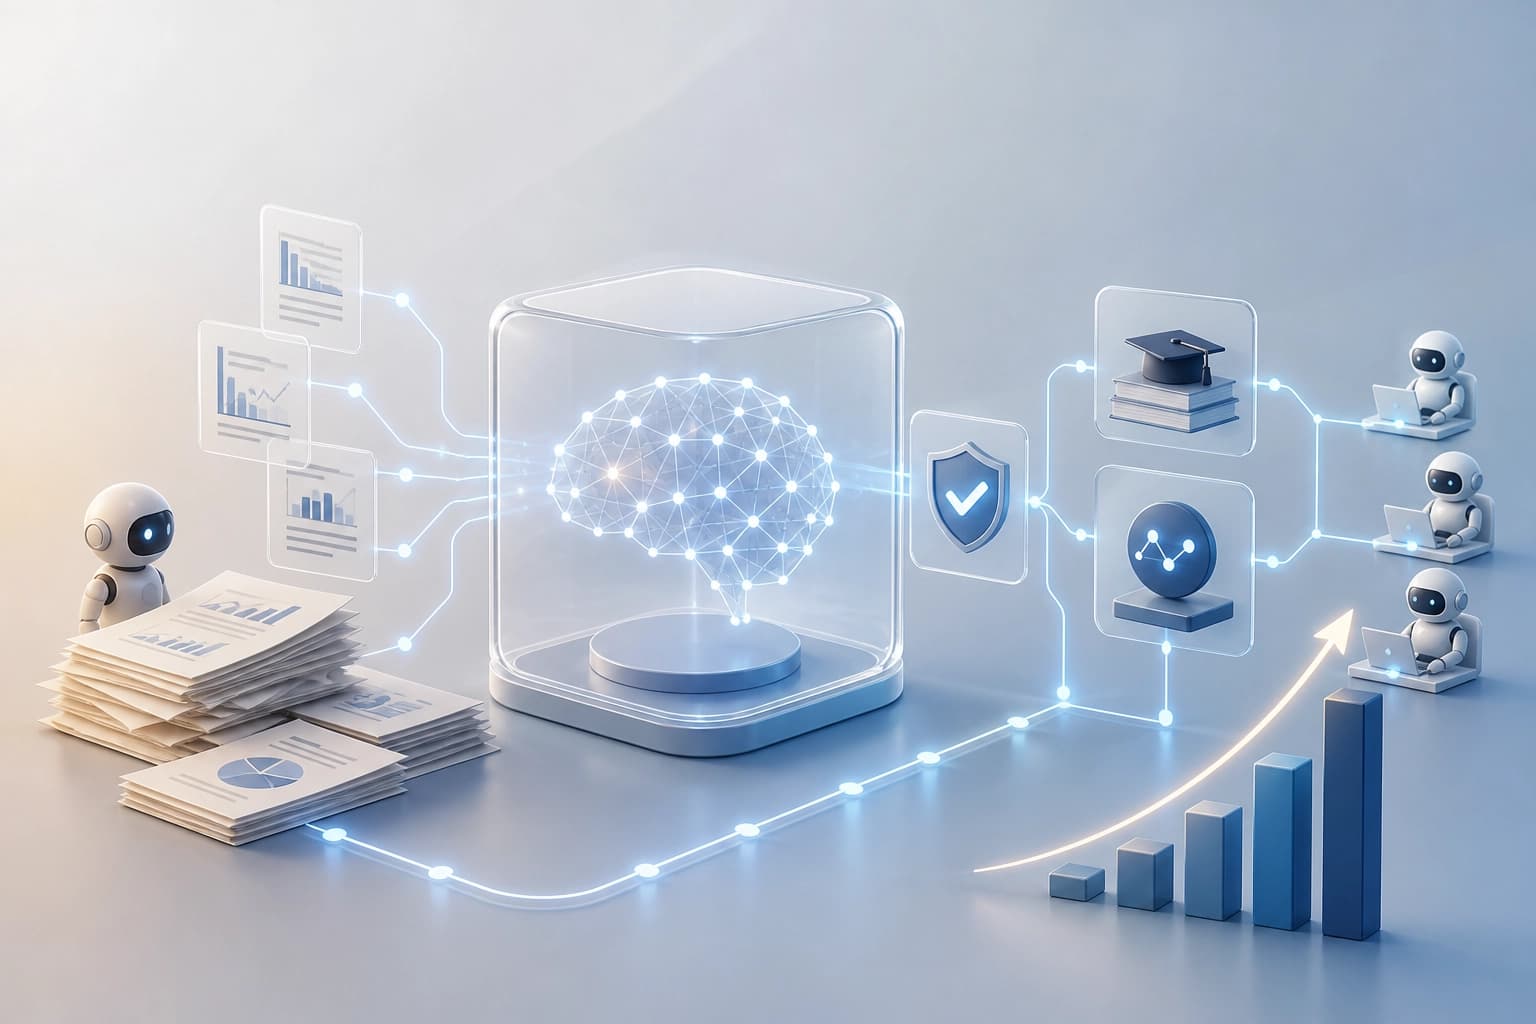
Navalia adalah framework untuk Cowork Agents. Framework ini menggabungkan sintesis tugas yang dapat diverifikasi dengan pascapelatihan pada horizon panjang. Untuk analisis keuangan, framework ini menggunakan laporan keuangan perusahaan.
Navalia memilih bukti pendukung secara semantik dari kumpulan fakta yang lengkap. Kemudian, framework ini menyusun rangkaian komputasi yang dapat dijalankan. Dengan demikian, framework ini membuat tugas analitis dengan bukti yang dapat ditelusuri dan dependensi data faktual antar langkah.
Kriteria praktis: tugas cocok untuk sintesis yang dapat diverifikasi jika memiliki bukti yang dapat ditelusuri dan dependensi antar langkah.
Pemeriksaan bukti dan jawaban
Konsistensi bukti dan kebenaran jawaban diperiksa melalui pemeriksaan LLM independen dan pemeriksaan programatis. Keduanya merupakan dua rangkaian kontrol yang berbeda. Yang pertama mengevaluasi aspek semantik, sedangkan yang kedua memeriksa kebenaran formal.
Kriteria praktis: tugas yang dapat diverifikasi membutuhkan pemeriksaan LLM dan pemeriksaan programatis.
Pascapelatihan pada trajektori panjang
Tugas yang telah diverifikasi menjadi bahan untuk mengumpulkan trajektori. Navalia menerapkan supervised fine-tuning dari titik awal yang dingin dan reinforcement learning. Kedua tahap ini meningkatkan kinerja dalam menyelesaikan tugas pada horizon panjang.
Framework yang diinisialisasi pada Qwen3.6-35B-A3B menunjukkan peningkatan yang konsisten dibandingkan model dasar. Peningkatan terlihat pada kelima benchmark. Para penulis melaporkan bahwa Navalia meningkatkan integrasi bukti, penggunaan alat, dan kinerja dalam menyelesaikan tugas pada horizon panjang.
Kriteria praktis: pascapelatihan bermanfaat jika tugas membutuhkan rangkaian tindakan yang panjang dan penggunaan alat.
Benchmark dan transfer hasil
Evaluasi Navalia dilakukan pada lima benchmark: OfficeQA Pro, FinSearchComp, Finance Agent Benchmark, APEX-Agents-AA, dan Workspace-Bench-Lite. Pada kelima benchmark, framework ini menunjukkan peningkatan yang konsisten dibandingkan model dasar.
Para penulis melaporkan adanya transfer hasil ke skenario Cowork yang lebih luas, termasuk tugas perkantoran umum. Kriteria praktis: perhatikan transfer keterampilan di luar analisis keuangan. Tugas perkantoran umum merupakan tanda penerapan yang lebih luas.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan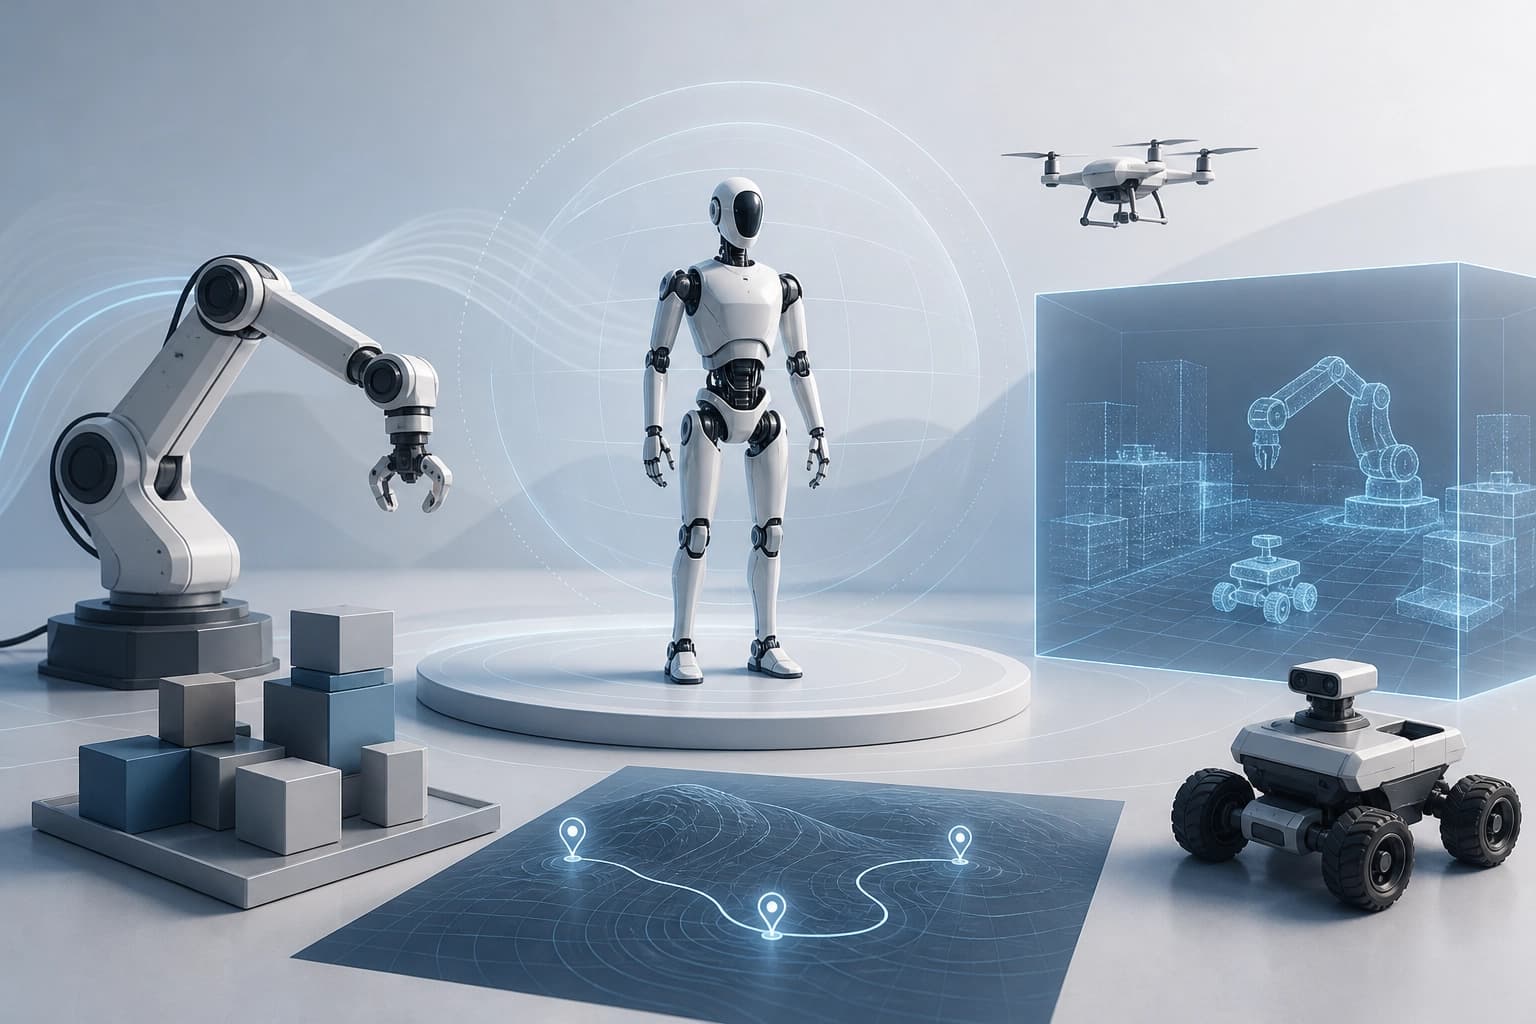
AI Fisik: Batasan Konsep, Perangkat, dan Tantangan
Monograf setebal 388 halaman ini merangkum definisi AI fisik, perbedaannya dari bidang-bidang terkait, serta metode utamanya—mulai dari persepsi dan simulasi hingga kendali dan sistem multiagen yang terkoordinasi—dalam satu kerangka. Buku ini memberikan peta tugas penelitian dan kendala yang menghambat peralihan dari solusi khusus ke sistem dengan kemampuan generalisasi yang luas.
17 November 2026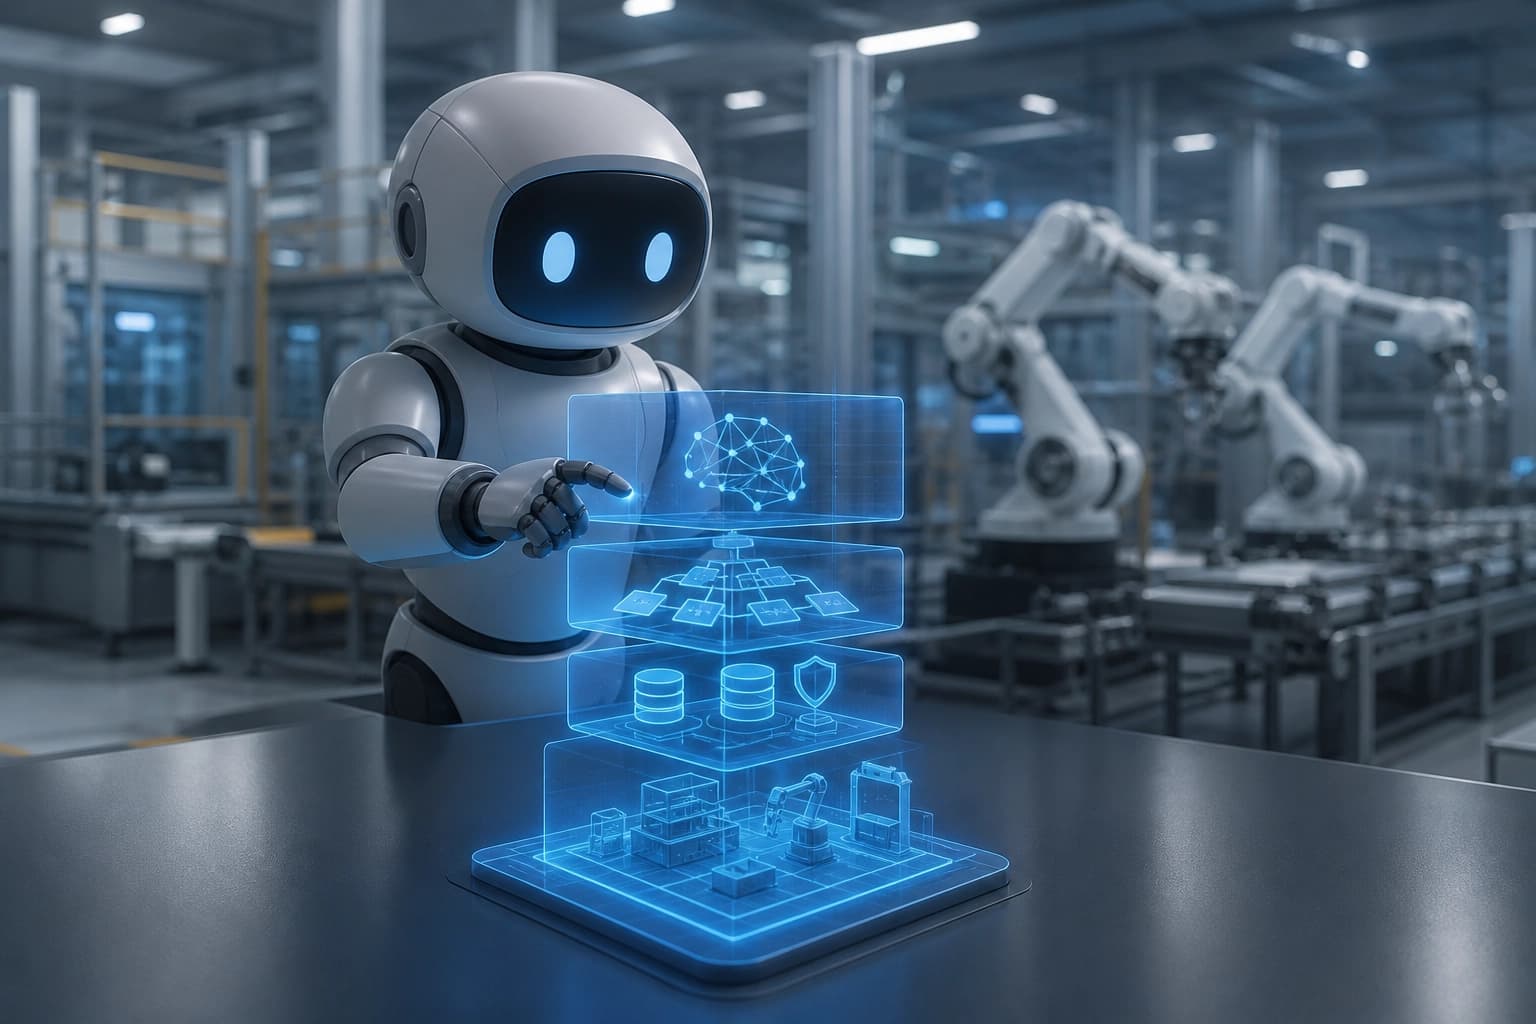
Agen LLM di Lingkungan Produksi: Taksonomi, Arsitektur, dan Batasan Penerapan
Artikel ini merangkum penelitian tentang penerapan model bahasa besar dalam agen manufaktur: mengidentifikasi hambatan, tingkat kemampuan, dan arsitektur empat lapis. Artikel ini membantu memahami skenario siklus hidup yang telah dikaji dan celah yang masih ada dalam perencanaan otonom yang andal.
17 November 2026
Pendekatan OWP: redistribusi bukti dan sinyal prior dalam Omni-LLM
Omni-Woodpecker adalah kerangka kerja yang tidak memerlukan pelatihan, yang mendeteksi konflik antar-modalitas dan menyeimbangkan kembali data konteks dengan prior yang telah dihafal dalam hidden state sebelum decoding. Pada Qwen2.5-Omni-7B dan VideoLLaMA2-AV, metode ini meningkatkan ketahanan terhadap kesalahan audiovisual pada CMM dan AVHBench, serta memberikan peningkatan moderat pada benchmark penalaran umum.
17 November 2026