
Pendekatan OWP: redistribusi bukti dan sinyal prior dalam Omni-LLM
Omni-Woodpecker adalah kerangka kerja yang tidak memerlukan pelatihan, yang mendeteksi konflik antar-modalitas dan menyeimbangkan kembali data konteks dengan prior yang telah dihafal dalam hidden state sebelum decoding. Pada Qwen2.5-Omni-7B dan VideoLLaMA2-AV, metode ini meningkatkan ketahanan terhadap kesalahan audiovisual pada CMM dan AVHBench, serta memberikan peningkatan moderat pada benchmark penalaran umum.
Apa itu OWP dan masalah apa yang diatasinya
Omni-Woodpecker (OWP) adalah framework tanpa pelatihan untuk mengoreksi halusinasi lintas modalitas pada Omni LLM. Metode ini memindahkan koreksi dari tingkat keluaran ke penyeimbangan ulang representasi yang disebabkan oleh konflik modalitas. Para penulis mengirimkan makalah pada 19 Oktober 2026: Zijian Liu, Chaoyou Fu, Yan Yang, Caifeng Shan, Ran He.
Koreksi tradisional bekerja pada jawaban yang sudah dihasilkan. OWP mengintervensi representasi internal sebelum decoding. Ini mengubah titik penerapan metode.
Kesimpulan: OWP mengubah titik koreksi, bukan memperbaiki jawaban yang sudah dihasilkan.
Tahapan penyeimbangan ulang bukti dan sinyal prior
OWP melakukan penyeimbangan ulang dalam beberapa tahap. Pertama, metode ini mengidentifikasi konflik lintas modalitas melalui representasi tambahan dari masing-masing modalitas.
- Mengidentifikasi konflik lintas modalitas melalui representasi tambahan dari masing-masing modalitas.
- Menguraikan keadaan tersembunyi secara ortogonal untuk memisahkan bukti grounding dari estimasi prior yang bersaing.
- Menyeimbangkan ulang representasi gabungan secara adaptif: menekan prior yang menyesatkan dan memulihkan bukti yang diabaikan.
- Meneruskan representasi yang telah dikoreksi ke proses decoding.
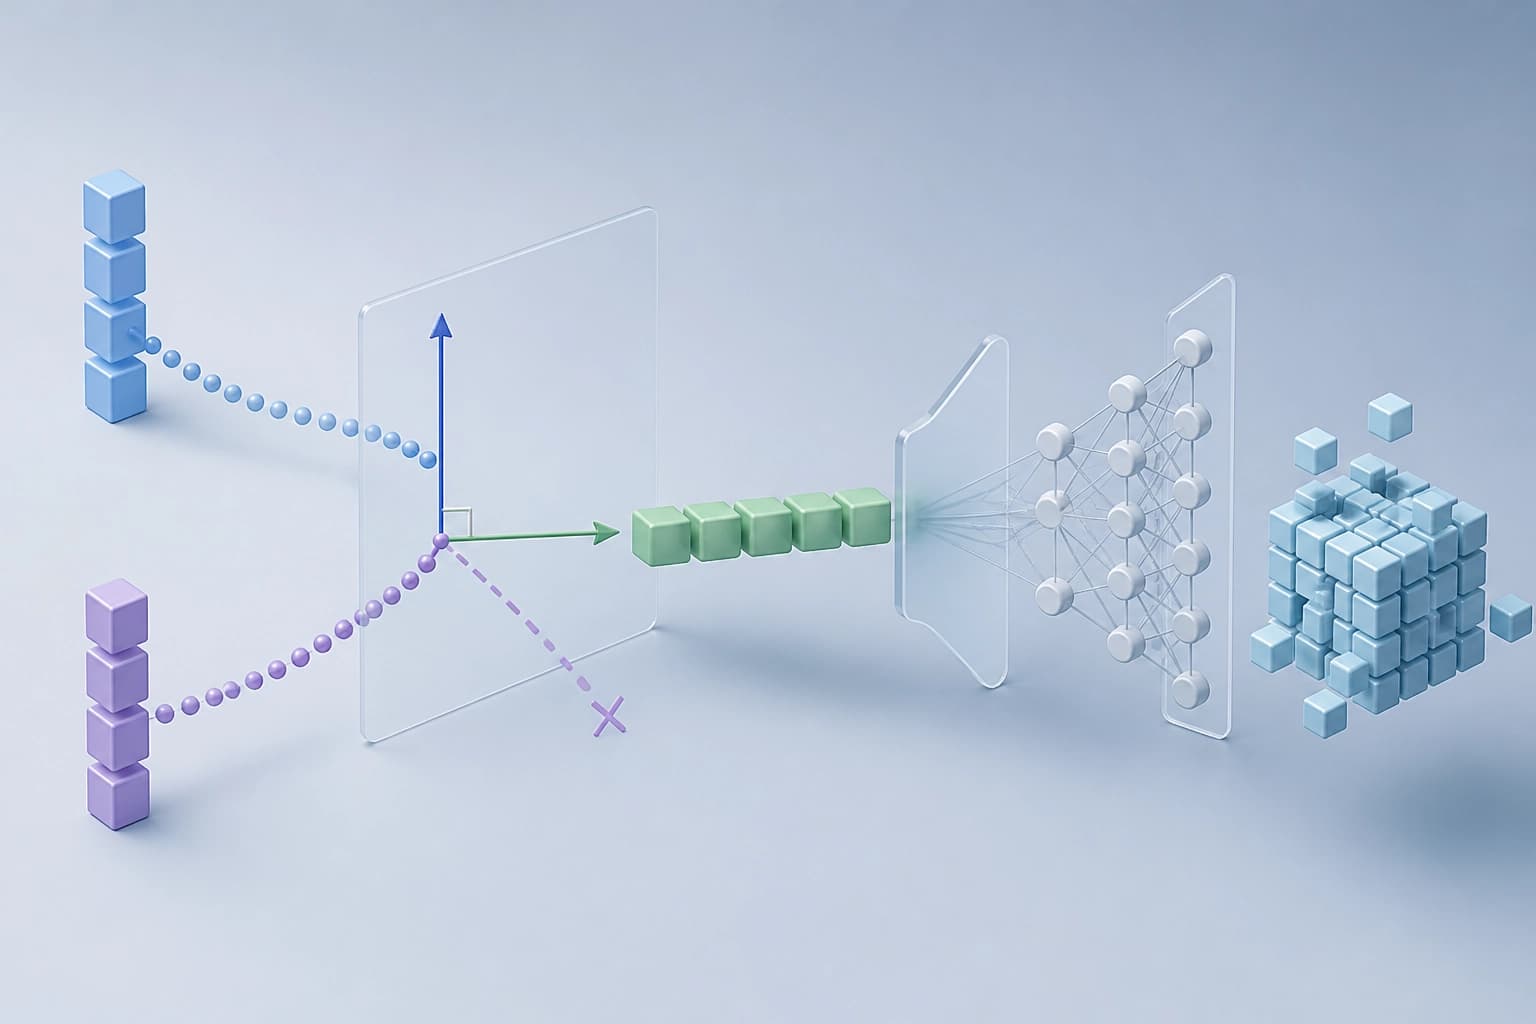
Metode ini tidak mengubah bobot model. Metode ini mengoreksi representasi sebelum generasi.
Kesimpulan: OWP tidak memerlukan pelatihan atau perubahan bobot. Metode ini bekerja pada keadaan tersembunyi sebelum decoding.
Hasil: peningkatan pada benchmark dan kemampuan transfer
Pada Qwen2.5-Omni-7B, OWP meningkatkan hasil sebesar 12,9 dan 8,6 poin pada CMM dan AVHBench. Pada empat benchmark penalaran umum OLLM, peningkatannya sebesar 0,67–2,25 poin.
| Model | CMM | AVHBench |
|---|---|---|
| Qwen2.5-Omni-7B | +12,9 poin | +8,6 poin |
| VideoLLaMA2-AV | +4,6 poin | +3,9 poin |
Metode ini menunjukkan kemampuan transfer ke VideoLLaMA2-AV: peningkatan sebesar 4,6 dan 3,9 poin pada CMM dan AVHBench. Para penulis melaporkan efektivitas dan kemampuan transfer lintas arsitektur. Kodenya tersedia untuk publik.
Kesimpulan: peningkatan bergantung pada model dan benchmark. Kriteria praktis: sebelum diterapkan, OWP sebaiknya diuji pada arsitektur dan kumpulan tugas target Anda.
Kriteria praktis untuk memilih OWP
OWP cocok digunakan jika beberapa kondisi terpenuhi. Metode ini bekerja tanpa pelatihan dan tanpa mengubah bobot model.
- Memerlukan koreksi halusinasi lintas modalitas tanpa pelatihan.
- Keadaan tersembunyi dan representasi masing-masing modalitas tersedia.
- Intervensi diperlukan sebelum decoding, bukan sebagai pascapemrosesan jawaban.
- Metode dapat direproduksi: kodenya tersedia untuk publik.
OWP adalah cara tanpa pelatihan untuk menyeimbangkan bukti dan sinyal prior. Para penulis menyatakan bahwa metode ini dapat ditransfer lintas arsitektur. Pengujian pada model tertentu tetap merupakan langkah yang wajib dilakukan.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan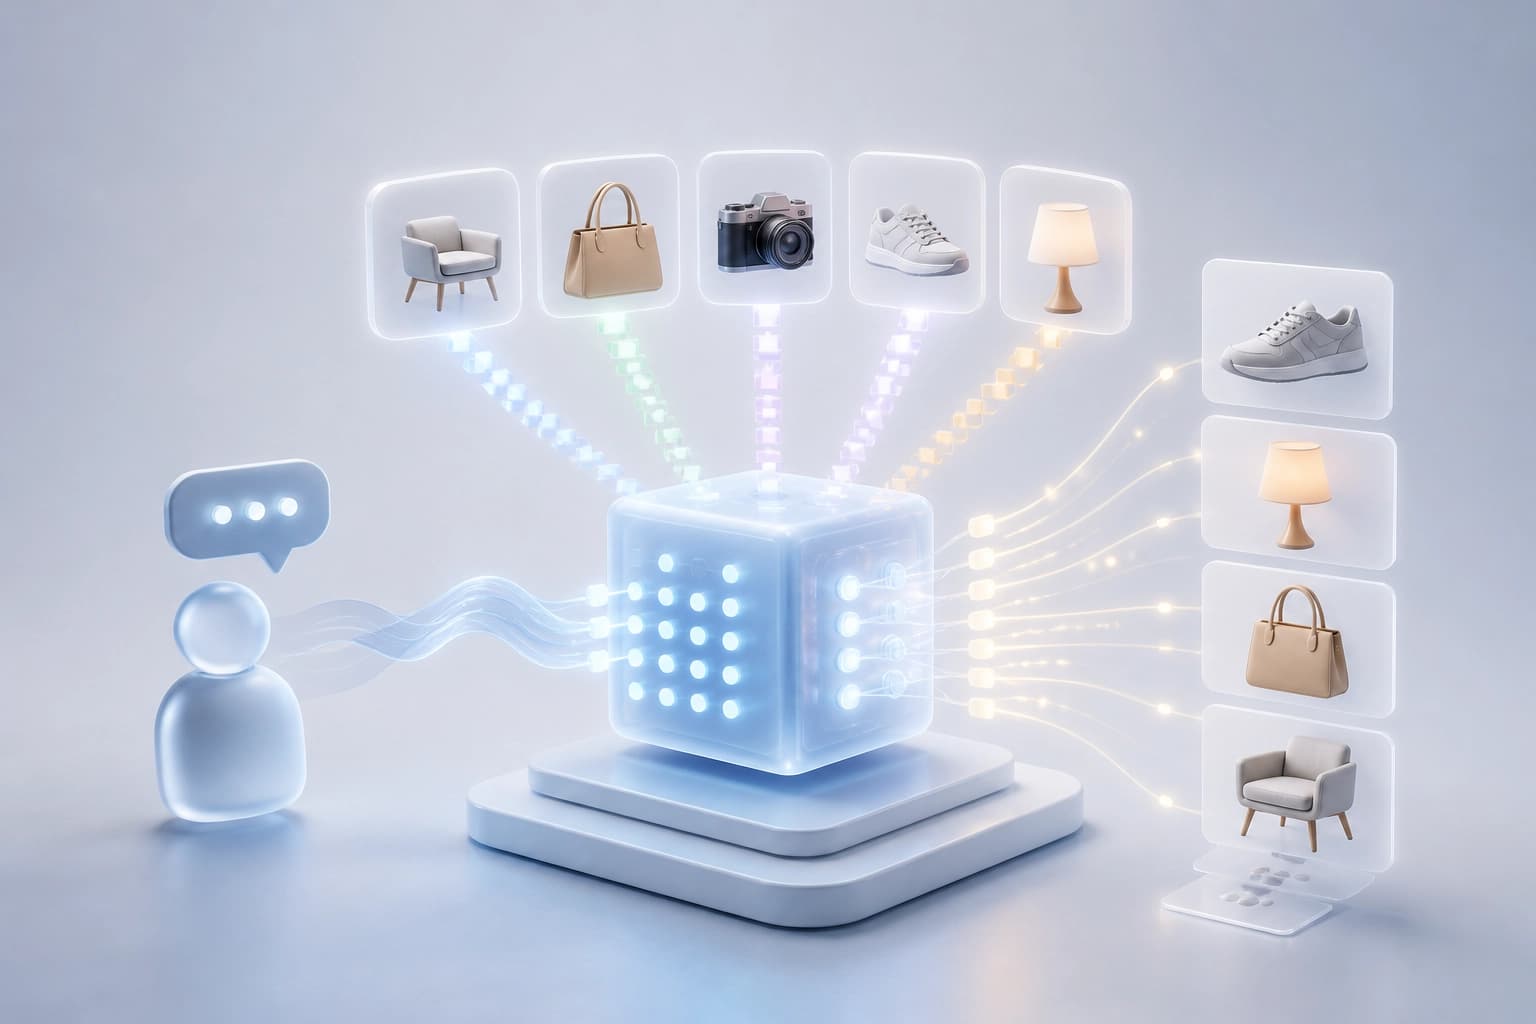
LightCRS: skema rekomendasi percakapan multidomain yang ringkas tanpa VLM terpisah untuk setiap kategori
Para penulis memperkenalkan sistem yang menggunakan encoder beku secara offline untuk menghitung fitur multimodal produk, lalu memprosesnya dalam dialog dengan modul lintas domain berukuran 5,3 juta parameter yang menggunakan cross-attention bergantung pada kueri. Pada benchmark yang mencakup 25 domain, pendekatan ini meningkatkan metrik peringkat rata-rata, secara signifikan mengurangi latensi, dan menunjukkan bahwa pelatihan bersama menghasilkan peningkatan dibandingkan model khusus untuk masing-masing domain.
16 November 2026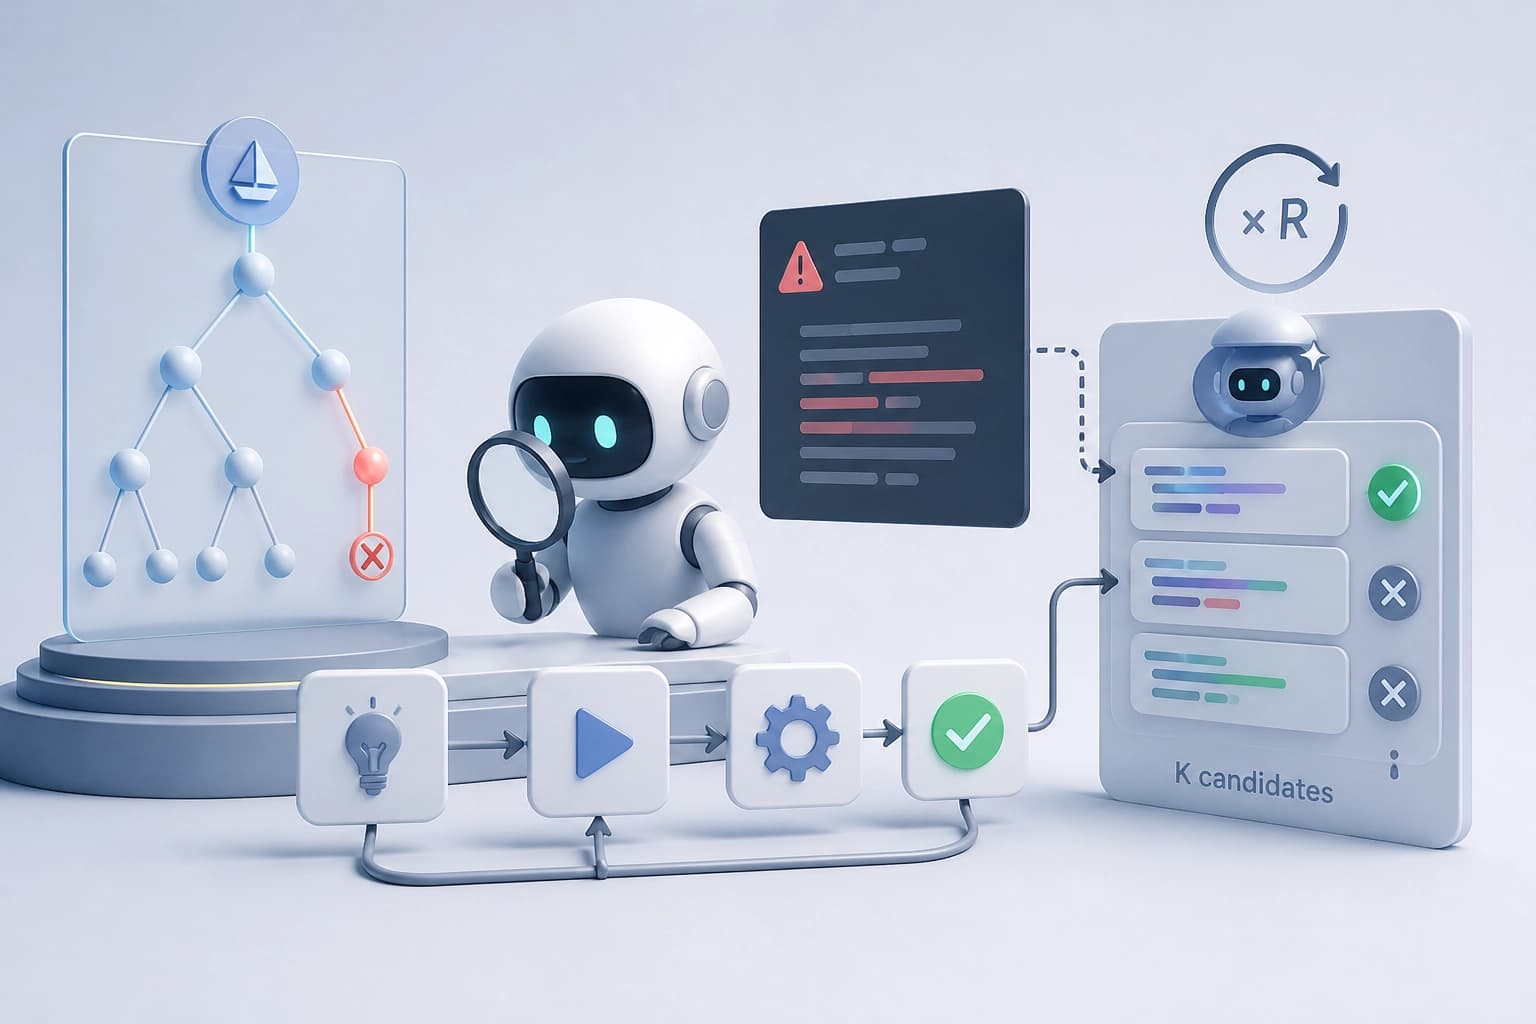
Perbaikan taktik terbatas di Lean 4 dengan bantuan diagnostik kompilator
Modul bertahap ini tidak membuang taktik yang ditolak, tetapi meminta model koreksi untuk memperbaikinya hingga R kali dengan mempertimbangkan kesalahan Lean; dengan K kandidat, modul ini meningkatkan proporsi tugas yang berhasil diselesaikan. Eksperimen pada LeanDojo dan Lean Workbook menunjukkan peningkatan yang terutama berasal dari kegagalan eksekusi dangkal, dengan konsekuensi waktu pencarian yang lebih lama.
16 November 2026
Metode Genesis Steering: pengarahan aktivasi pada data yang digunakan saat fine-tuning
Metode ini menghasilkan vektor pengarah dari contoh kontras yang terdapat dalam data penyempurnaan, dan jika contoh tersebut tidak tersedia, metode ini memilih sampel pelatihan yang mungkin melalui membership inference lalu membentuk kumpulan data proksi. Bagian teoretis menguraikan pergeseran optimal menuju batas keputusan dan estimasi berdasarkan data proksi; secara empiris, data internal Tülu-3-8B memberikan efek yang lebih kuat daripada kumpulan data eksternal, sedangkan kegunaan proksi MIA pada Llama-3.1-8B-Instruct terbatas oleh rasio pergeseran arah.
16 November 2026