
NAQD-Env: penangguhan selektif operasi pada agen bahasa
Sebuah benchmark sintetis telah dirilis, dengan acuan deterministik yang menetapkan dependensi antara data, izin, dan batasan, sementara model harus menghentikan hanya langkah yang terdampak tanpa kehilangan pekerjaan lainnya. Pengujian terhadap tiga model terbuka menunjukkan tingkat penghentian yang rendah dan tidak adanya pelanjutan yang benar; penyesuaian lanjutan meningkatkan akurasi keputusan, tetapi menimbulkan efek samping.
Inti Penangguhan Selektif
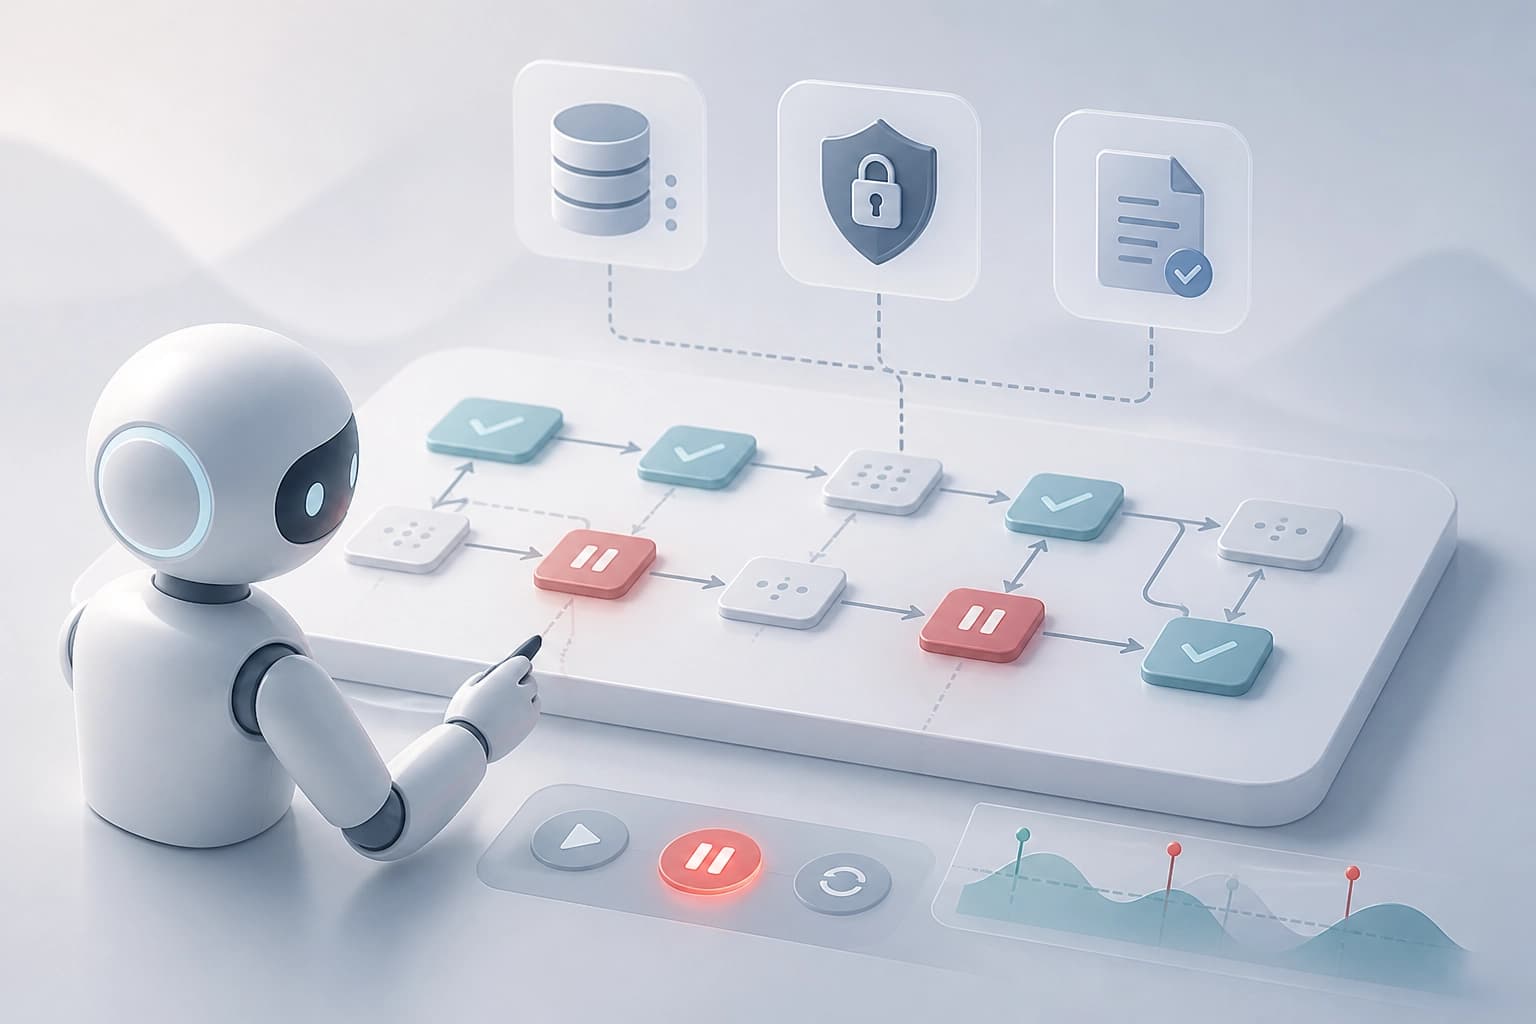
NAQD Env adalah lingkungan sintetis untuk mengevaluasi keputusan agen bahasa tentang penghentian tindakan secara selektif. Kebijakan acuannya bersifat deterministik. Kebijakan ini mengandalkan dependensi bukti, izin, dan batasan yang ditetapkan secara eksplisit. Ketika bukti berubah, izin dicabut, atau instruksi untuk berhenti diterima, agen harus menangguhkan tindakan yang terdampak. Agen tetap melanjutkan pekerjaan yang tidak terdampak. Tindakan hanya dilanjutkan kembali setelah ada koreksi yang memadai. Kriterianya: lingkungan ini menguji selektivitas penangguhan, bukan penghentian total.
Cara Kerja Evaluasi
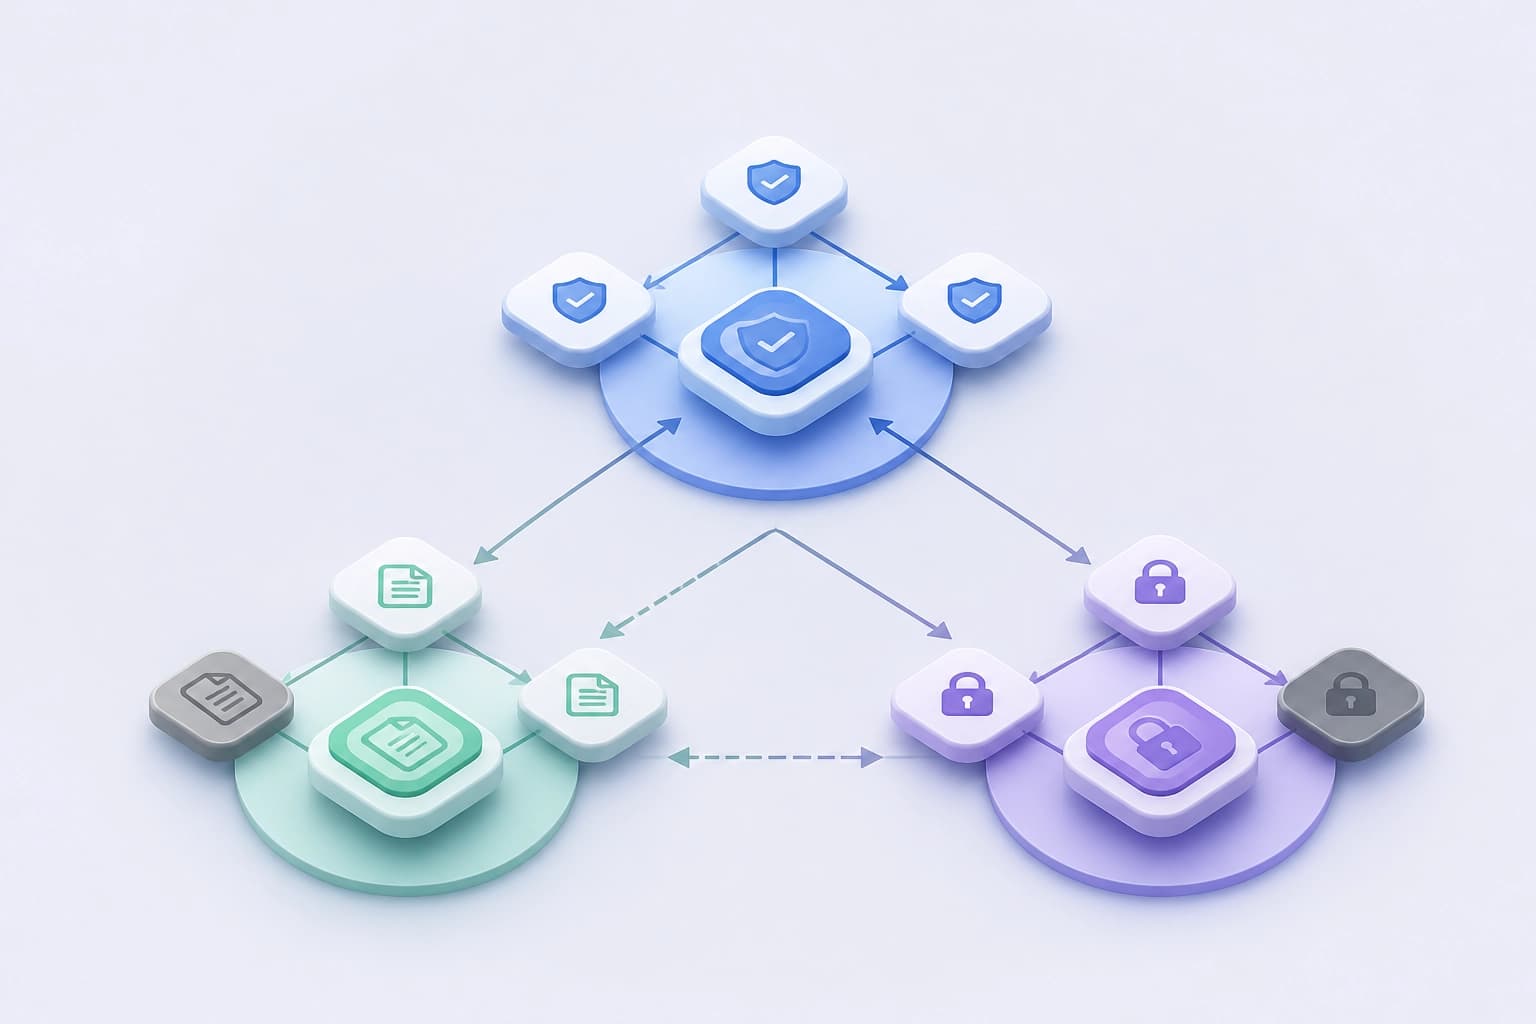
Evaluasi menggunakan 11 keluarga dependensi. Kumpulan ini mencakup struktur untuk pengembangan, keluarga yang ditahan, dan kombinasi struktur yang ditahan. Metrik secara terpisah memperhitungkan percobaan pelanggaran dan pelanggaran yang dilakukan oleh mekanisme eksekusi simulasi. Metrik gabungan mencerminkan kepatuhan terhadap kebijakan, nilai tugas, penghentian tindakan, pelanjutan kembali, dan pelaporan kejadian. Kumpulan ini memisahkan niat dari pelanggaran yang benar-benar terjadi. Kumpulan ini juga menghubungkan keselamatan dengan kegunaan dan komunikasi. Kriteria praktis: tinjau semua metrik secara bersamaan, bukan hanya apakah tindakan dihentikan.
Hasil pada Tiga Model
Penelitian ini mengevaluasi tiga model berbobot terbuka. Model-model tersebut disetel untuk mengikuti instruksi dan berasal dari dua keluarga. Evaluasi menggunakan tiga kondisi prompt dan 350 skenario tetap. Secara keseluruhan, diperoleh 3 150 episode “model—prompt” sebelum diputar ulang melalui mekanisme eksekusi. Dalam kondisi yang ditinjau, tingkat penghentian tindakan tidak lebih dari 0,06. Ketika ada peluang yang sesuai, tidak ada pelanjutan kembali yang benar yang teramati. Hanya satu episode yang sepenuhnya sesuai dengan kebijakan acuan.
Perbandingan model dengan prompt NAQD:
| Model | Pengamatan |
|---|---|
| Qwen2.5-7B | Lebih sedikit episode dengan percobaan tidak aman dibandingkan Qwen2.5-3B dan Llama-3.1-8B. Namun, pekerjaan yang berguna lebih sedikit dan pemeliharaan tindakan yang tidak terdampak kurang akurat. |
| Qwen2.5-3B | Dalam pengujian fine-tuning terkontrol, akurasi keputusan meningkat dari 0.45–0.54 menjadi 0.83–0.92. |
| Llama-3.1-8B | Kinerjanya lebih buruk daripada Qwen2.5-7B dalam perbandingan percobaan tidak aman. |
Kesimpulan: bahkan dengan prompt khusus, model jarang mengikuti kebijakan acuan sepenuhnya. Peningkatan keselamatan dapat mengurangi pekerjaan yang berguna. Kriteria praktis: periksa bukan hanya percobaan pelanggaran, tetapi juga pemeliharaan tindakan yang tidak terdampak.
Batasan Lingkungan dan Fine-Tuning
Lingkungan ini mengevaluasi penerapan kebijakan dengan masukan terstruktur tepercaya. Lingkungan ini tidak membuktikan kemampuan untuk benar-benar melakukan penahanan atau memverifikasi sumber. Dalam pengujian fine-tuning terkontrol, akurasi keputusan Qwen2.5-3B meningkat. Diagnostik terpisah menemukan penghentian tindakan yang tidak semestinya setelah ada penghilangan dalam kurikulum pelatihan. Diagnostik tersebut juga menunjukkan penurunan frekuensi pelaporan kejadian. Karya Mohamed Abouzahra diajukan pada 29 Sep 2026. Kriteria praktis: fine-tuning perlu diuji untuk mendeteksi penghentian yang tidak semestinya dan menilai kualitas pelaporan kejadian.
Kesimpulan Praktis untuk Pemilihan
NAQD Env mengukur penangguhan selektif dalam kondisi terkontrol. Lingkungan ini menggunakan masukan terstruktur tepercaya. Lingkungan ini tidak memberikan jaminan untuk penahanan nyata atau verifikasi sumber. Saat memilih agen, pertimbangkan tingkat penghentian, ketepatan pelanjutan kembali, pemeliharaan pekerjaan yang tidak terdampak, dan pelaporan kejadian. Fine-tuning dapat meningkatkan akurasi keputusan, tetapi berisiko menyebabkan penghentian yang tidak semestinya dan mengurangi komunikasi. Kriterianya: gunakan lingkungan ini sebagai diagnostik kebijakan, bukan sebagai bukti keandalan dalam kondisi nyata.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026