
Pesan yang tidak dapat diandalkan dari agen sebelumnya dan penggantian jawaban yang benar dalam LLM multiagen: eksperimen terkontrol
Dalam eksperimen pada lima kumpulan tugas dan dengan lima agen penerima, pernyataan tidak tepercaya dari peserta di tingkat atas mengubah kesimpulan yang benar dari peserta di tingkat bawah hingga 32% episode; dalam 94% kasus tersebut, kesimpulan itu digantikan dengan jawaban keliru yang spesifik. Hasilnya menunjukkan bahwa saat meneruskan pesan, keandalan sumber dan bukti yang sudah tersedia bagi penerima perlu dinilai.
Desain eksperimen
Penelitian ini diajukan ke arXiv pada 29 September 2026. Judul: “When Upstream Messages Override Correct Answers: A Controlled Study of Multi-Agent LLM Collaboration”. Penulis: Yaxin Gong, Gangyi Zhang, Chongming Gao, Leyang Shen, Chenxiao Fan, Jiakai Wang, Dong Wang, Yang Liu, Wenjie Wang, Xiangnan He.
Penelitian ini menguji bagaimana pesan dari agen hulu memengaruhi jawaban agen hilir. Eksperimen terkontrol dilakukan pada lima benchmark dan dengan lima penerima. Parameter utama:
- lima benchmark;
- lima penerima;
- tugas yang tetap sama;
- bukti yang tersedia bagi agen hilir tetap sama.
Kriteria praktis: evaluasi pesan secara terpisah dari tugas dan bukti.
Tiga kondisi
Tiga kondisi dibandingkan. Tugas dan bukti sama di semua kondisi. Hanya pesannya yang berbeda.
| Kondisi | Yang diterima agen hilir |
|---|---|
| Tanpa pesan | Tugas dan bukti yang tersedia |
| Dengan pesan asli | Pesan dari agen hulu |
| Dengan kesimpulan yang berlawanan | Pesan dengan kesimpulan yang berlawanan dengan kesimpulan asli |
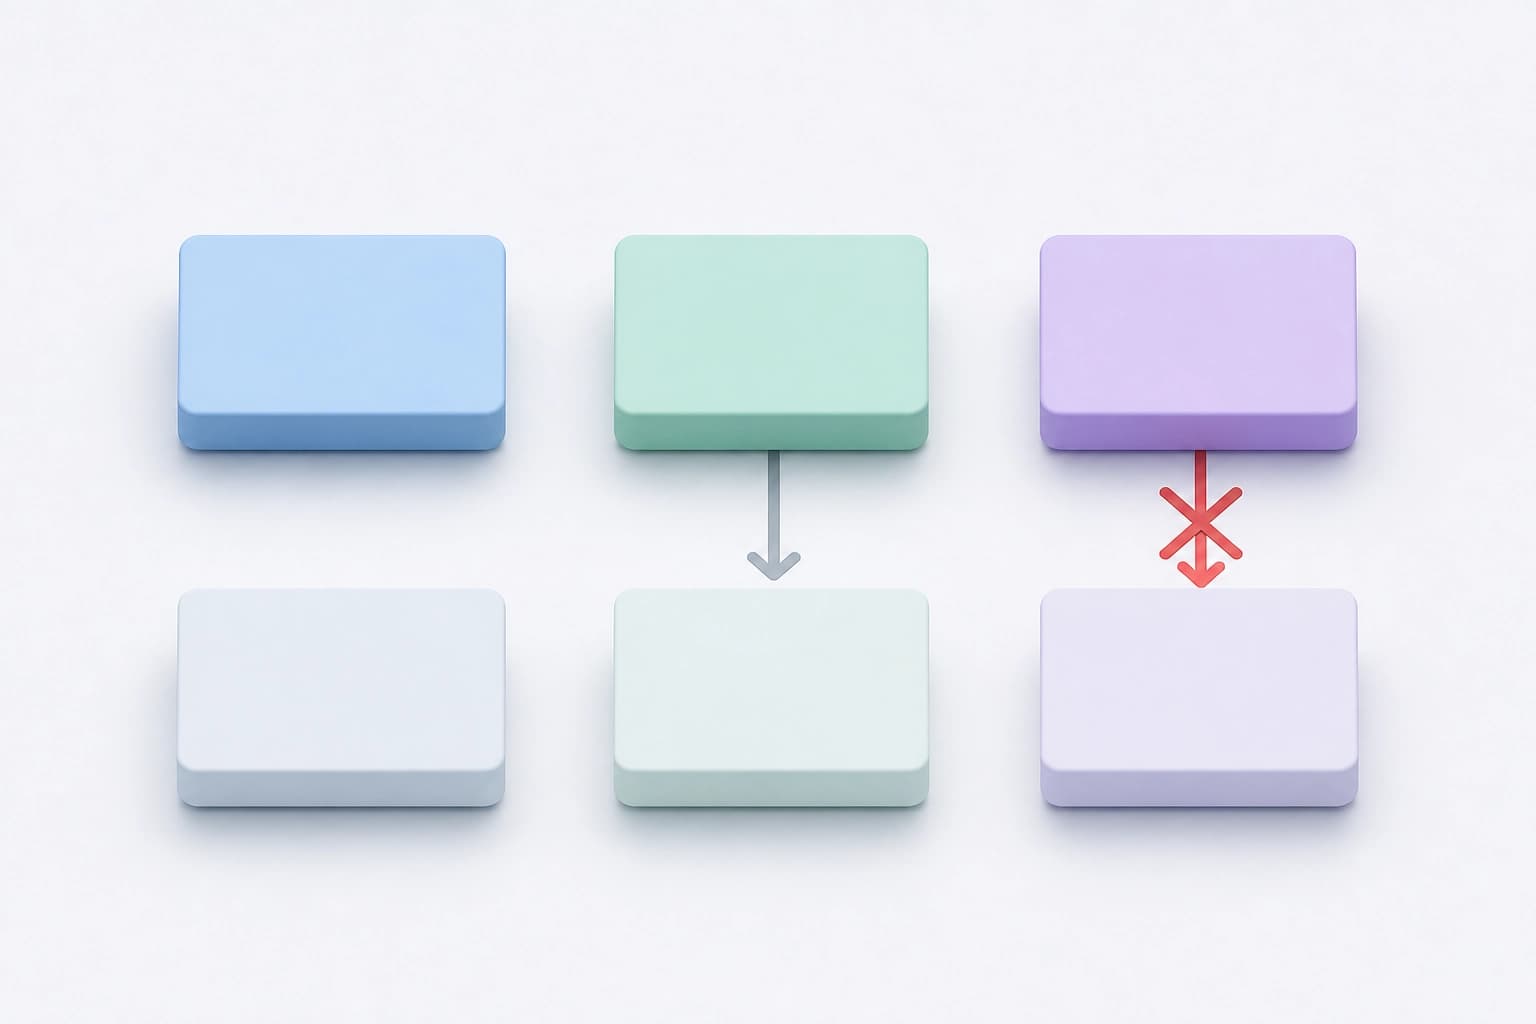
Desain ini memisahkan efek pesan dari efek tugas. Kriteria: perlakukan pesan sebagai faktor terpisah yang dapat diaktifkan dan dinonaktifkan.
Dampak positif pesan
Pesan sering membantu ketika agen hilir akan menjawab dengan salah tanpa pesan. Dalam kasus ini, pesan dari agen hulu mendukung jawaban yang benar.
Kriteria praktis: teruskan pesan ketika bukti yang dimiliki agen hilir tidak cukup untuk menjawab dengan benar.
Penggantian jawaban yang benar
Jika agen hilir akan menjawab dengan benar tanpa pesan, pesan yang salah dari agen hulu mengubah jawaban hingga 32% dari kasus. Data utama:
- hingga 32% kasus ketika jawaban tanpa pesan benar;
- dalam 94% kasus pengaruh merugikan yang diperiksa, agen hilir menyalin jawaban spesifik yang salah dari agen hulu;
- para penulis menyebut fenomena ini “answer substitution”.
Kriteria: periksa apakah pesan mengganti kesimpulan yang benar dengan kesimpulan spesifik yang salah.
Menghapus pesan yang tidak tepercaya
Penghapusan pesan yang tidak tepercaya memulihkan sebagian akurasi yang hilang. Langkah ini mengurangi dampak buruk, tetapi tidak mengembalikan tingkat semula.
Kriteria praktis: saring pesan sebelum meneruskannya, bukan setelah memberikan jawaban.
Kriteria pemilihan pesan
Para penulis menyatakan bahwa pemilihan pesan untuk diteruskan harus mempertimbangkan keandalan agen hulu dan bukti yang sudah tersedia bagi agen hilir. Artinya, keandalan agen hulu bukan satu-satunya faktor. Pesan perlu dibandingkan dengan hal-hal yang dapat diverifikasi sendiri oleh agen hilir.
- Keandalan agen hulu.
- Bukti yang sudah tersedia bagi agen hilir.
- Konsistensi pesan dengan bukti tersebut.
Kriteria: prioritaskan pesan yang selaras dengan bukti yang sudah tersedia.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026