
Ilmu molekuler telah lama dianggap sebagai salah satu bidang paling menjanjikan — sekaligus paling rumit — bagi AI. Justru itulah yang menjadi topik preprint arXiv:2608.23104 "Molecular LLM Agents: From Architectural Design to Scientific Autonomy": 25 halaman, kategori cs.CL dan cs.AI, versi v1 tanggal 24 Agustus 2026 dan versi v2 yang disempurnakan tanggal 25 Agustus. Tim penulisnya adalah Jiatong Li, Wengyu Zhang, Weida Wang, Yuxuan Ren, Wei Liu, Chenyang Mao, Yuqiang Li, Yatao Bian, Changmeng Zheng, Xiaoyong Wei, dan Qing Li. Karya ini menarik bukan karena memecahkan rekor benchmark lagi, melainkan karena upayanya merapikan istilah: apa sebenarnya yang dianggap sebagai agen molekuler, dari node apa ia disusun, dan seberapa mandiri ia dapat bertindak.
Apa yang membedakan agen molekuler dari agen "biasa"
Asisten percakapan dan agen kode hidup di dunia teks, repositori, dan halaman web. Alat yang mereka operasikan hampir selalu menerima dan mengembalikan sesuatu yang bisa dibaca mata. Dengan kimia, trik ini tidak berhasil: molekul bukan paragraf.
Agen domain harus berhadapan dengan beberapa jenis data yang tidak kompatibel sekaligus:
- notasi simbolik seperti SMILES — string ringkas di mana satu karakter yang salah mengubah kandidat obat menjadi zat lain;
- graf molekuler, di mana yang penting bukan hanya atom, tetapi juga orde ikatan, muatan, stereokimia;
- konformasi tiga dimensi — karena sifat molekul ditentukan oleh bentuknya, bukan hanya rumusnya;
- spektrum dan hasil simulasi — deret numerik panjang yang harus digali maknanya;
- pengukuran dari laboratorium "basah", yaitu data eksperimen nyata dengan zat, bukan dengan file.
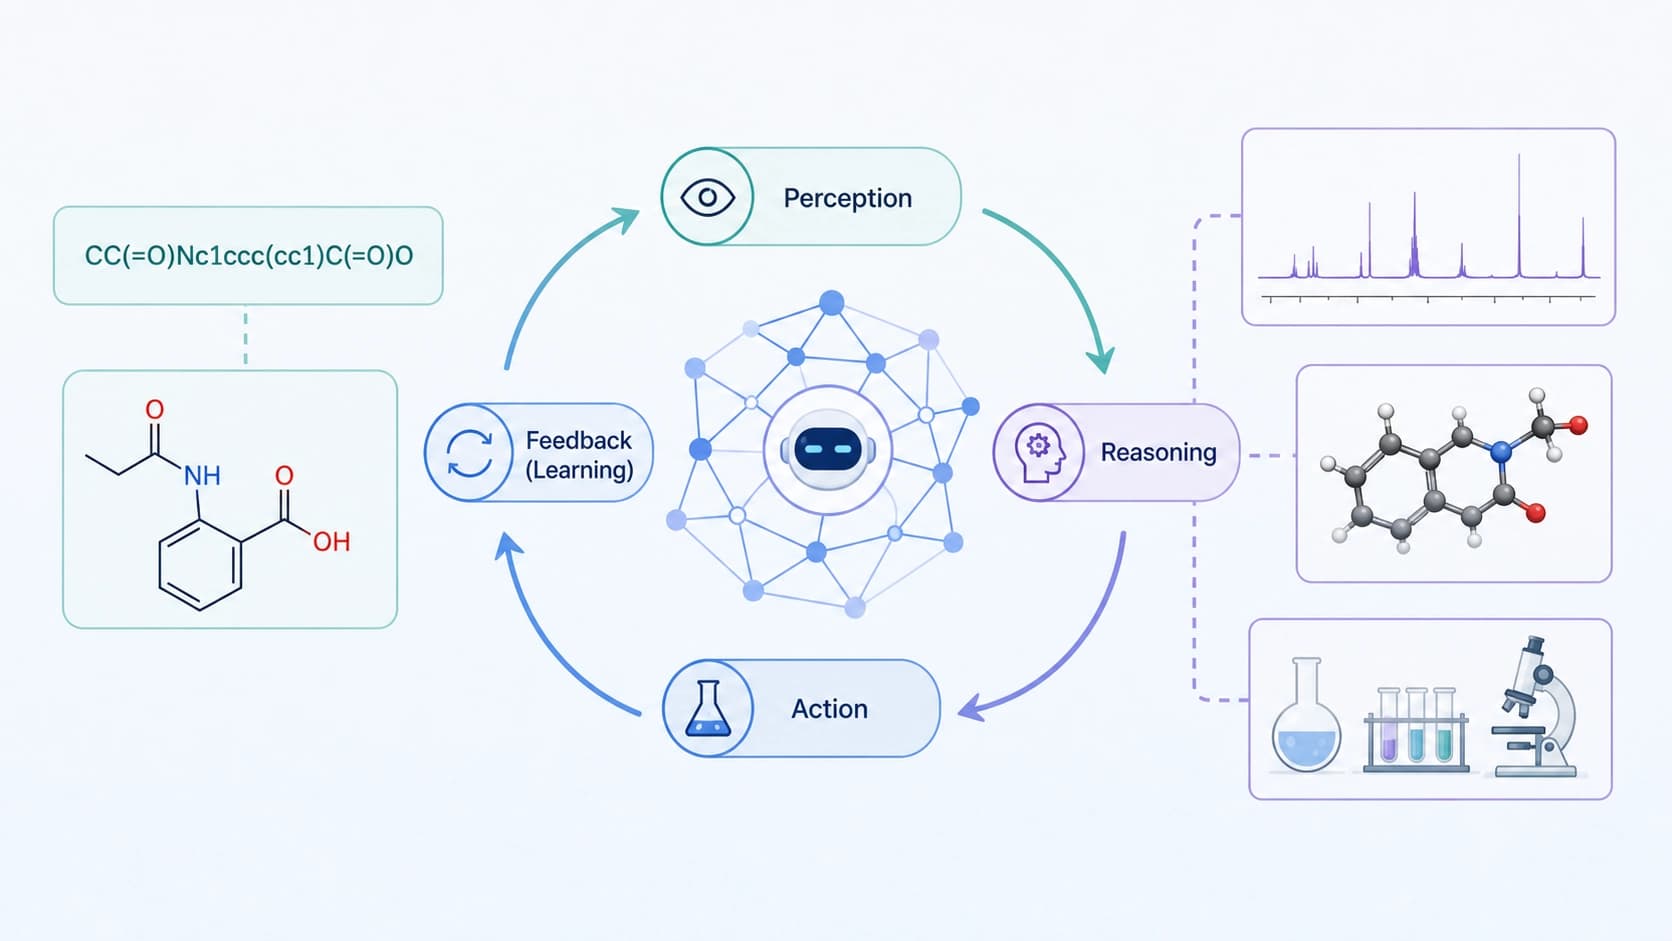
Dari sini muncul gagasan utama para penulis: kemampuan agen semacam ini tidak tersusun dari satu model yang berhasil, melainkan dari beberapa pilar sekaligus. Diperlukan persepsi objek molekuler yang benar secara kimia, kerangka agen dengan model bahasa di pusatnya, alat yang terikat pada domain tertentu, serta saluran umpan balik — komputasional atau eksperimental. Di atas semua itu, ada kemampuan merencanakan dan memanggil alat yang tepat pada waktu yang tepat.
Pandangan arsitektural: dari apa agen molekuler disusun
Perspektif pertama dari dua perspektif dalam artikel ini adalah perspektif rekayasa. Para penulis menguraikan konstruksinya menjadi empat lapisan dan menyarankan agar proyek apa pun yang sudah ada dilihat dengan cara ini.
Persepsi: molekul sebagai objek, bukan sebagai paragraf
Model bahasa dilatih pada teks, sehingga string SMILES awalnya mereka lihat sebagai kumpulan token dan mudah "berhalusinasi" valensi yang tidak ada. Di sini, keterkaitan dengan model domain membantu: misalnya, AlphaFold menunjukkan bagaimana arsitektur khusus menyelesaikan tugas molekuler yang sempit dengan lebih akurat daripada arsitektur universal. Bagi agen, ini berarti satu hal sederhana: sebelum bernalar, ia harus mampu memvalidasi — memeriksa apakah molekul itu benar-benar ada, apakah grafnya sesuai dengan rumusnya, apakah stereokimianya tidak hilang saat berpindah antarformat.
Kerangka, toolbok, dan pelatihan
Lapisan kedua dan ketiga adalah "otak" dan "tangan". Model bahasa merencanakan dan memutuskan perhitungan mana yang akan dijalankan; toolbok domain memberinya docking, perhitungan kimia kuantum, pencarian basis data, prediksi sifat. Contoh baik dari pendekatan ini adalah agen ChemCrow: nilai di sana diciptakan bukan oleh modelnya sendiri, melainkan oleh alat yang dijelaskan dengan cermat yang dipanggilnya.
Lapisan keempat adalah pelatihan dan optimasi. Agen dapat dilatih ulang pada lintasan solusi yang berhasil, atau deskripsi alat dan strategi pemilihannya cukup diperbaiki. Jalur kedua lebih murah, dan para penulis jelas memberi isyarat: separuh kegagalan di bidang ini bukan karena model yang lemah, melainkan karena loop umpan balik yang dirancang dengan buruk.
Tangga otonomi ilmiah: L1–L4
Perspektif kedua dari artikel ini adalah "tangga otonomi" yang dipinjam dari logika tingkat dalam sistem rekayasa. Tangga ini diperlukan agar tidak berdebat secara abstrak soal "apakah agennya pintar", melainkan untuk memahami berapa banyak keputusan yang benar-benar diambilnya sendiri.
L1 — asisten dengan skenario tetap
Di sini manusia menetapkan urutan langkah, dan model menjalankan operasi individual: menerjemahkan struktur, menghitung deskriptor, mengusulkan opsi. Otonominya hampir tidak ada, tetapi prediktabilitasnya maksimal.
L2 — agen komputasional adaptif
Agen memutuskan sendiri alat mana yang dipanggil dan dalam urutan apa, merencanakan ulang saat terjadi kesalahan, bekerja dalam lingkaran yang sepenuhnya digital. Inilah arus utama saat ini: risikonya terbatas pada perhitungan yang rusak, bukan sampel yang rusak.
L3 — agen yang memperhitungkan hasil eksperimen nyata
Tingkat yang paling menarik dan paling berisiko. Agen tidak hanya merencanakan, tetapi juga menerima umpan balik dari laboratorium fisik — spektrum, kromatogram, data sintesis — dan menyesuaikan rencananya berdasarkan itu. Contoh sistem kelas ini sudah ada: Coscientist mendemonstrasikan perencanaan sintesis dengan melibatkan otomasi laboratorium. Tetapi justru di sini harga sebuah kesalahan berhenti menjadi abstrak: langkah yang salah menghabiskan reagen, waktu instrumen, dan dalam kasus terburuk, keselamatan orang.
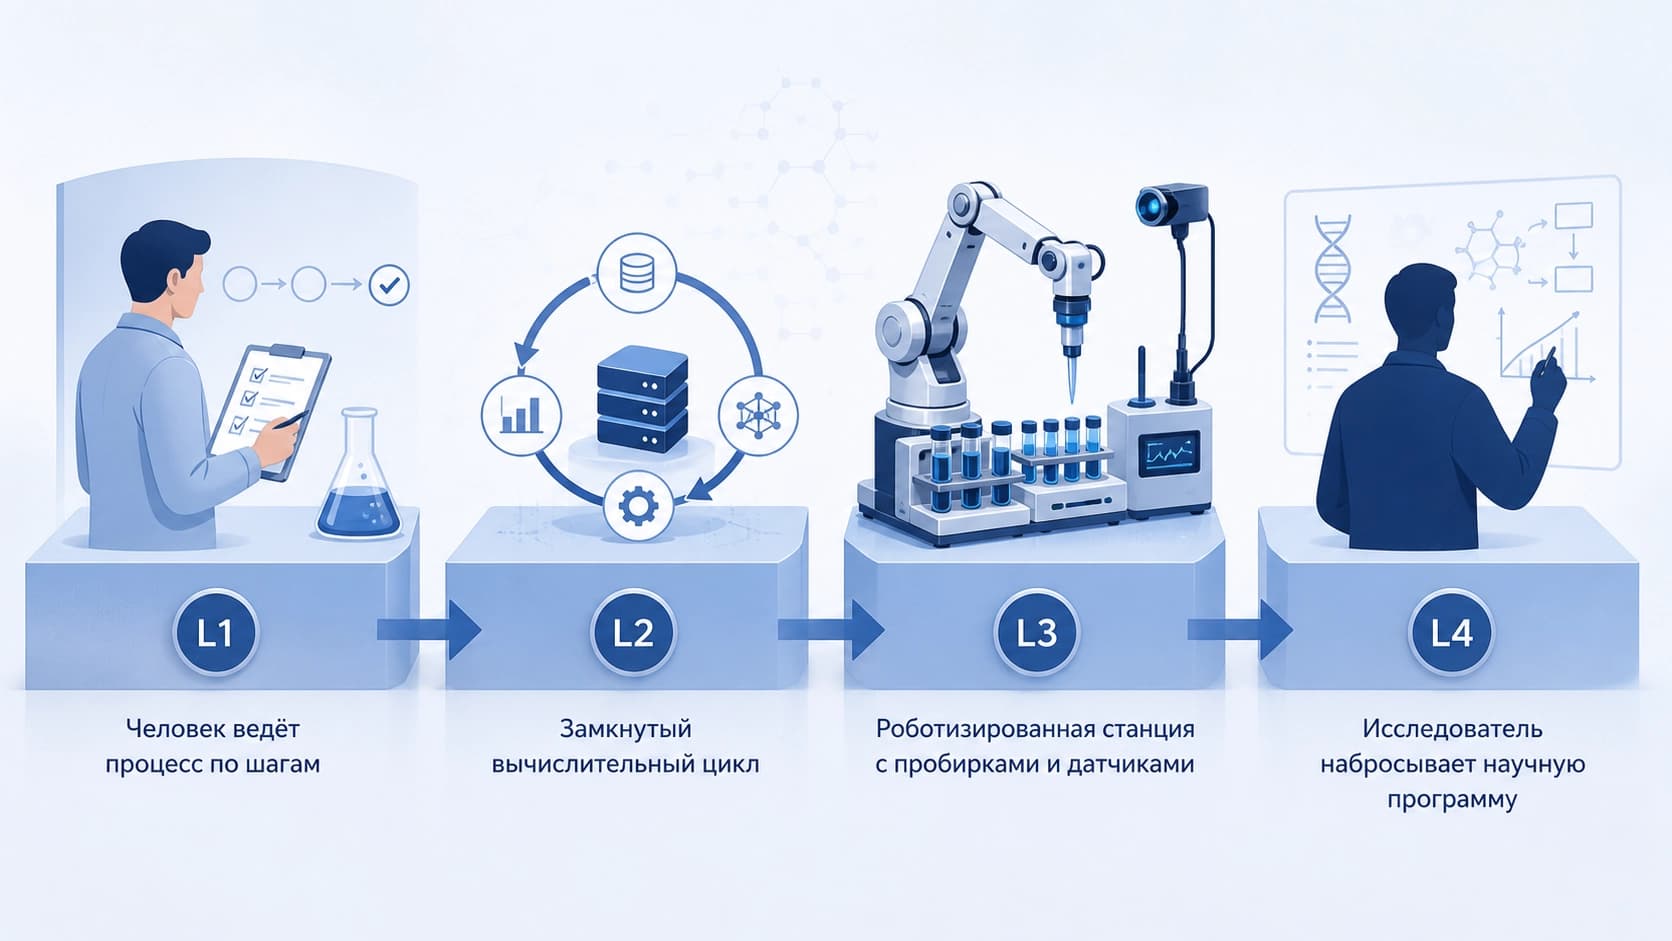
L4 — agen yang membentuk agenda ilmiah
Tingkat teratas adalah ketika sistem sendiri memilih hipotesis mana yang harus diuji, arah mana yang dianggap prioritas, dan di mana mencari celah dalam literatur. Untuk saat ini, ini lebih merupakan pedoman daripada deskripsi solusi yang berfungsi. Tetapi justru inilah yang memberi arah: perbedaan antara "pelaksana cepat" dan "rekan penulis yang merumuskan masalah" bersifat mendasar, dan sebaiknya ditegaskan dengan kata-kata, bukan intuisi.
Mengapa kerangka ini diperlukan
Manfaat praktis dari dua perspektif ini terletak pada kemungkinan membandingkan hal yang tak sebanding. Jika dua agen sama-sama menyebut diri "otonom", tetapi yang satu berputar di simulator dan yang kedua mengendalikan robot sintesis, itu adalah sistem dengan kelas tanggung jawab yang berbeda.
Para penulis menyarankan menggunakan kerangka ini untuk tiga tugas:
- Diagnostik. Setelah menguraikan agen per lapisan, terlihat di mana kelemahannya: dalam persepsi molekul, dalam alat, atau dalam perencanaan.
- Penilaian risiko. Semakin tinggi tingkatnya, semakin serius konsekuensi kegagalan — dan semakin penting pemeriksaan sebelum bertindak, bukan sesudahnya.
- Perancangan. Memahami tingkat otonomi mana yang benar-benar diperlukan untuk suatu tugas menyelamatkan dari godaan membangun L4 di tempat yang cukup dengan L2 yang cermat.
Keterbatasan dan apa yang masih belum terpecahkan
Catatan jujur: tangga ini adalah model konseptual, bukan skala yang terukur. Ia membantu berpikir, tetapi tidak menggantikan validasi, sertifikasi, dan reproduktibilitas hasil. Selain itu, kimia tidak toleran terhadap "hampir benar": di teks, salah ketik itu menjengkelkan; di rumus struktur, itu sudah zat yang berbeda.
Pertanyaan terpisah yang belum terpecahkan adalah data. Umpan balik dari laboratorium nyata mahal dan jarang, dan tanpanya agen L3 tetap menjadi teori. Pertanyaan kedua adalah interpretabilitas: seorang kimiawan perlu memahami mengapa sistem mengusulkan rute sintesis tertentu, jika tidak, tidak akan ada kepercayaan.
Singkatnya tentang hal utama
Agen LLM molekuler bukan sekadar "kimia plus chatbot". Ini adalah kelas sistem tersendiri di mana model bahasa berperan sebagai dispatcher antara graf, spektrum, paket komputasi, dan peralatan laboratorium. Karya arXiv:2608.23104 bermanfaat terutama karena kosakatanya: empat lapisan arsitektur dan empat tingkat otonomi memberikan bahasa bersama untuk membicarakan apa yang sudah bisa dilakukan agen semacam ini, apa yang masih kurang, dan di mana batas antara percepatan rutinitas yang bermanfaat dan keputusan yang sebaiknya diserahkan kepada manusia.


