
LLM multimodal multiagen dalam matematika: cara memeriksa langkah penyelesaian dan ketahanan terhadap gangguan
MAMath-Bench diperkenalkan sebagai kumpulan 1003 soal dari 11 bidang matematika dengan materi teks, gambar, dan audio; selain jawaban akhir, benchmark ini mencatat langkah-langkah pemeriksaan dan respons sistem terhadap perubahan adversarial dalam alur penalaran. Hasilnya menunjukkan bahwa kolaborasi beberapa LLM tidak selalu meningkatkan akurasi, dapat memperkuat penalaran yang berlebihan, dan gangguan struktural yang halus tetap menjadi sumber kerentanan yang serius.
Apa yang dinilai oleh benchmark
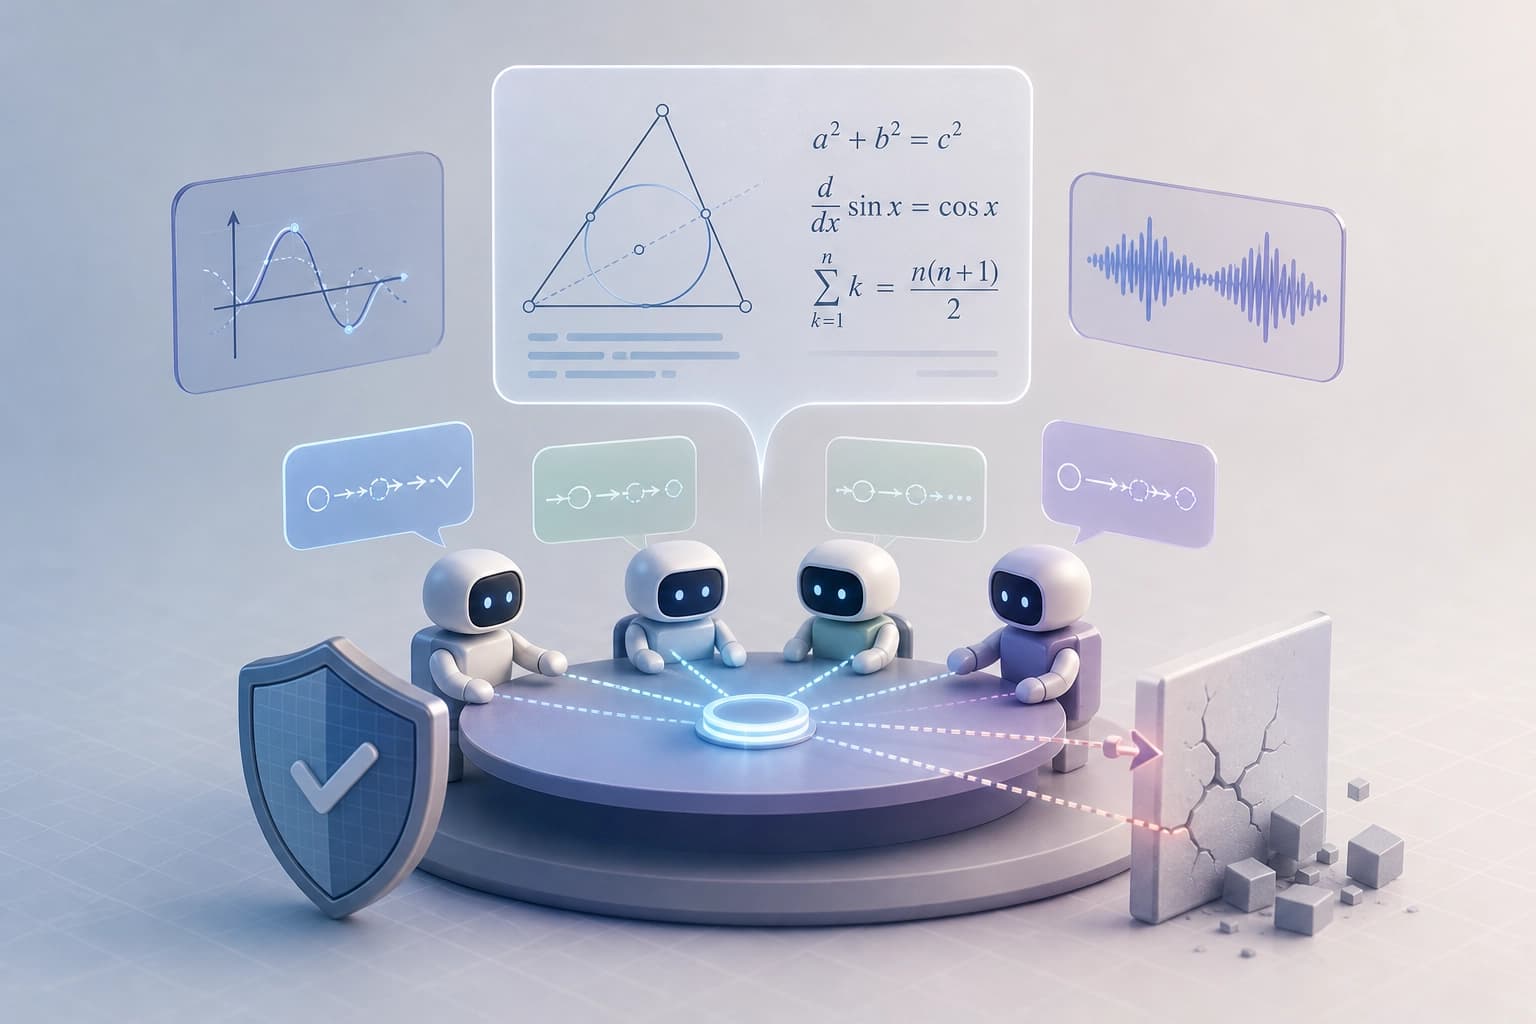
MAMath-Bench adalah benchmark untuk mengevaluasi penalaran matematika multimodal pada sistem multiagen. Benchmark ini mencakup 1 003 soal dari 11 kategori matematika. Soal-soalnya mencakup beberapa tingkat kesulitan dan tiga modalitas: teks, gambar, dan audio.
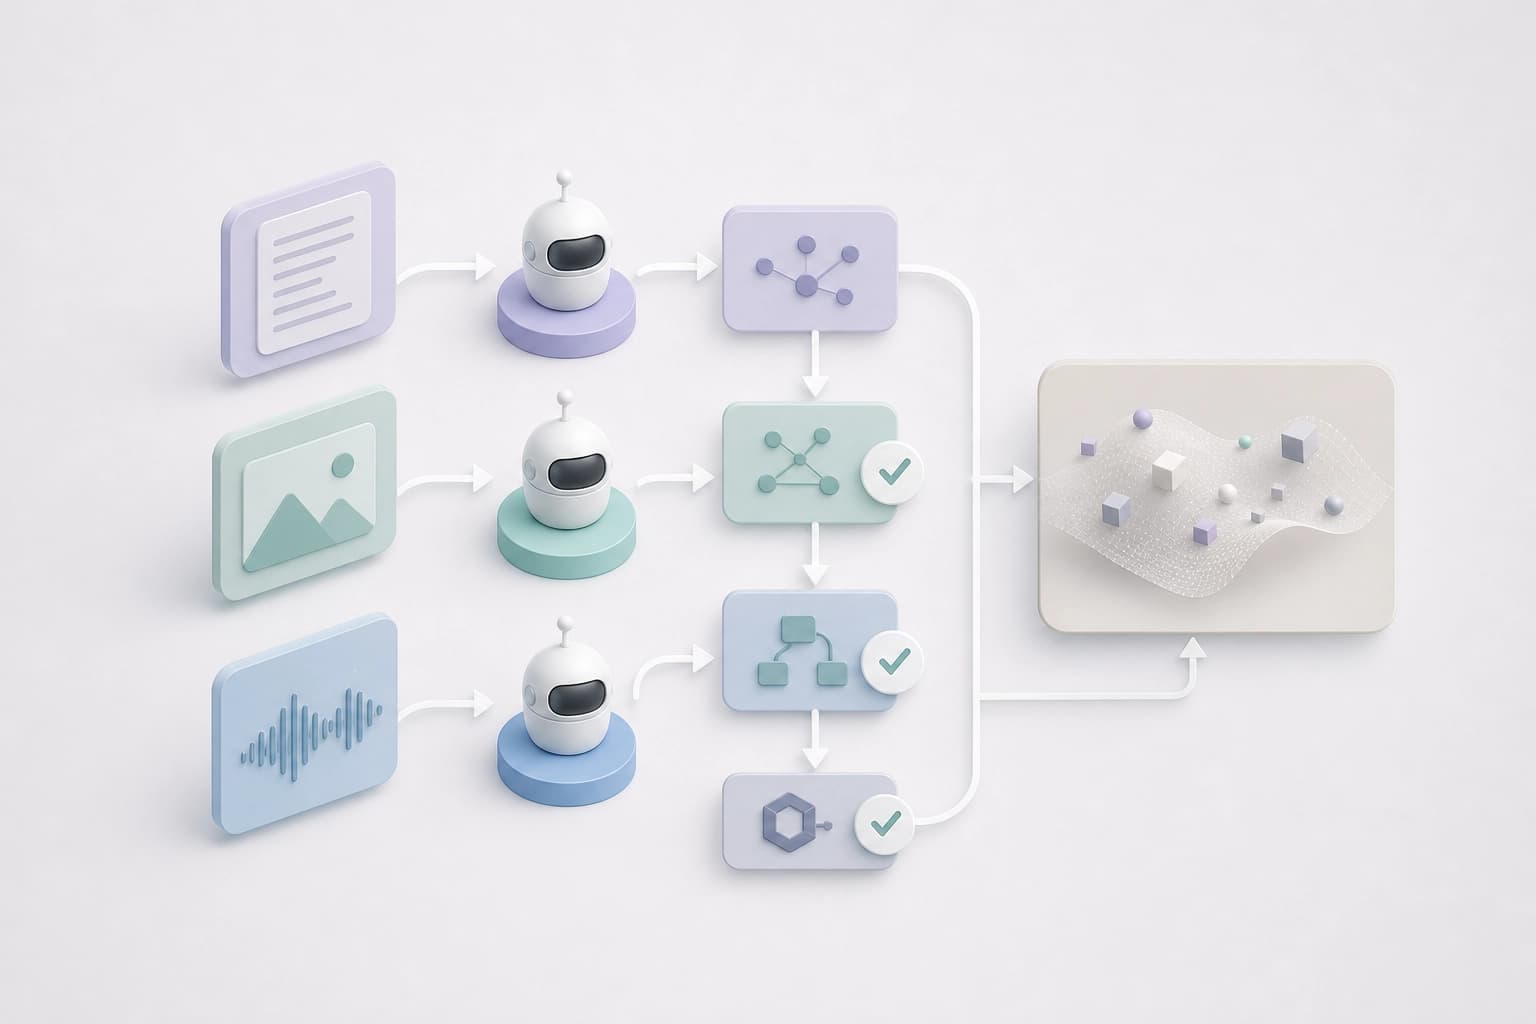
Benchmark ini berisi anotasi terperinci tentang titik pemeriksaan. Penilaian dilakukan dalam tiga dimensi:
- ketepatan penyelesaian soal;
- keandalan proses penalaran;
- ketahanan terhadap gangguan adversarial pada rantai penalaran.
Kriteria praktis: pilih penilaian yang membedakan ketepatan jawaban, keandalan proses, dan ketahanan terhadap gangguan. Jawaban akhir saja tidak cukup untuk pemeriksaan semacam ini.
Pemeriksaan alur penyelesaian
Anotasi titik pemeriksaan menjadi acuan untuk memeriksa langkah-langkah perantara. Penilaian keandalan proses penalaran dipisahkan dari ketepatan jawaban akhir. Dengan demikian, sistem dapat dibandingkan berdasarkan hal lain, tidak hanya hasilnya.
Hal yang perlu diperiksa dalam alur penyelesaian:
- keberadaan titik pemeriksaan yang ditandai dalam anotasi;
- kesesuaian langkah-langkah perantara dengan titik pemeriksaan tersebut;
- keandalan proses penalaran sebagai dimensi tersendiri.
Kriteria pemeriksaan: catat bagian spesifik saat penyelesaian menyimpang dari titik pemeriksaan. Jawaban akhir saja tidak menunjukkan kualitas alur penyelesaian.
Multiagen: ketepatan, cakupan, dan redundansi
Penilaian ini menunjukkan tiga dampak berbeda dari kolaborasi beberapa agen. Ketepatan jawaban akhir tidak selalu meningkat dibandingkan LLM tunggal yang kuat. Cakupan penalaran perantara dapat meningkat secara signifikan. Peningkatan cakupan dapat disertai peningkatan redundansi penalaran.
| Hal yang dibandingkan | Hal yang ditunjukkan penilaian | Kesimpulan praktis |
|---|---|---|
| Ketepatan jawaban akhir | Kolaborasi beberapa agen tidak selalu meningkatkan ketepatan dibandingkan LLM tunggal yang kuat | Jangan menganggap skema multiagen menjamin jawaban yang benar |
| Cakupan penalaran perantara | Kolaborasi dapat meningkatkan cakupan secara signifikan | Bandingkan peningkatan cakupan dengan dimensi lainnya |
| Redundansi penalaran | Peningkatan cakupan dapat disertai peningkatan redundansi | Pertimbangkan peningkatan redundansi saat mengevaluasi cakupan |
Kriteria pemilihan: jangan menganggap skema multiagen menjamin ketepatan. Bandingkan skema tersebut dengan LLM tunggal yang kuat dalam hal jawaban akhir, cakupan, dan redundansi.
Ketahanan terhadap distorsi adversarial
Penilaian ini mencakup ketahanan terhadap gangguan adversarial pada rantai penalaran. Sistem modern masih rentan terhadap kesalahan penalaran adversarial, terutama yang terkait dengan gangguan struktural yang halus.
Hal yang perlu diperiksa:
- respons sistem terhadap gangguan adversarial pada rantai penalaran;
- kesalahan penalaran akibat gangguan struktural yang halus;
- terjaganya keandalan proses, bukan hanya jawaban akhir.
Kriteria ketahanan: uji sistem dengan gangguan adversarial pada rantai penalaran. Ketahanan terhadap gangguan tersebut termasuk dalam penilaian, bersama dengan ketepatan jawaban.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Tugas yang dapat diverifikasi dan pelatihan lanjutan pada lintasan panjang: bagaimana Navalia memperkuat agen LLM kooperatif
Karya ini menjelaskan sebuah kerangka kerja yang, berdasarkan laporan keuangan perusahaan, membangun rantai komputasi dengan bukti yang dapat ditelusuri, memvalidasinya secara independen, lalu menerapkannya untuk SFT dan RL. Dengan Qwen3.6-35B-A3B, pipeline ini menghasilkan peningkatan pada lima benchmark dan, menurut penulis, meningkatkan pengaitan bukti, penggunaan alat, serta penyelesaian tugas jangka panjang, termasuk skenario perkantoran.
18 November 2026
AI Fisik: Batasan Konsep, Perangkat, dan Tantangan
Monograf setebal 388 halaman ini merangkum definisi AI fisik, perbedaannya dari bidang-bidang terkait, serta metode utamanya—mulai dari persepsi dan simulasi hingga kendali dan sistem multiagen yang terkoordinasi—dalam satu kerangka. Buku ini memberikan peta tugas penelitian dan kendala yang menghambat peralihan dari solusi khusus ke sistem dengan kemampuan generalisasi yang luas.
17 November 2026
Agen LLM di Lingkungan Produksi: Taksonomi, Arsitektur, dan Batasan Penerapan
Artikel ini merangkum penelitian tentang penerapan model bahasa besar dalam agen manufaktur: mengidentifikasi hambatan, tingkat kemampuan, dan arsitektur empat lapis. Artikel ini membantu memahami skenario siklus hidup yang telah dikaji dan celah yang masih ada dalam perencanaan otonom yang andal.
17 November 2026