
Singkatnya: tentang apa sebenarnya ini
Pada Agustus 2026, sebuah karya muncul di arXiv dengan judul yang hampir biasa saja — «Software Defined Dataflow System for Large-scale AI Acceleration». Di baliknya ada deskripsi tentang akselerator Maia 200, dan ini bukan iterasi lain dari «lebih banyak flops per watt». Ide utamanya di sini bersifat arsitektural: penulis mengusulkan untuk menggeser penekanan pada bagaimana sebuah chip AI sebenarnya dirancang.
Materi diajukan pada 25 Agustus 2026 ke bagian cs.AR, pengirimnya adalah Torsten Hoefler, total ada 17 orang dalam daftar penulis (Sherry Xu dan enam belas peneliti lainnya). Karya ini ditandai dalam beberapa rubrik sekaligus: arsitektur perangkat keras, kecerdasan buatan, komputasi terdistribusi dan paralel, teknologi baru, serta pembelajaran mesin. Artinya, ini bukan sekadar catatan tentang «perangkat keras», melainkan sebuah konsep yang menyentuh seluruh tumpukan teknologi.
Data alih-alih perintah: inti dari pembalikan ini
Akselerator klasik dibangun di sekitar aliran perintah. Ada inti, ada penjadwal, ada hierarki cache — dan seluruh konstruksi ini melayani eksekusi instruksi. Memori dalam model seperti ini berperan sebagai pelayan: sajikan data tepat waktu, selebihnya kami urus sendiri.
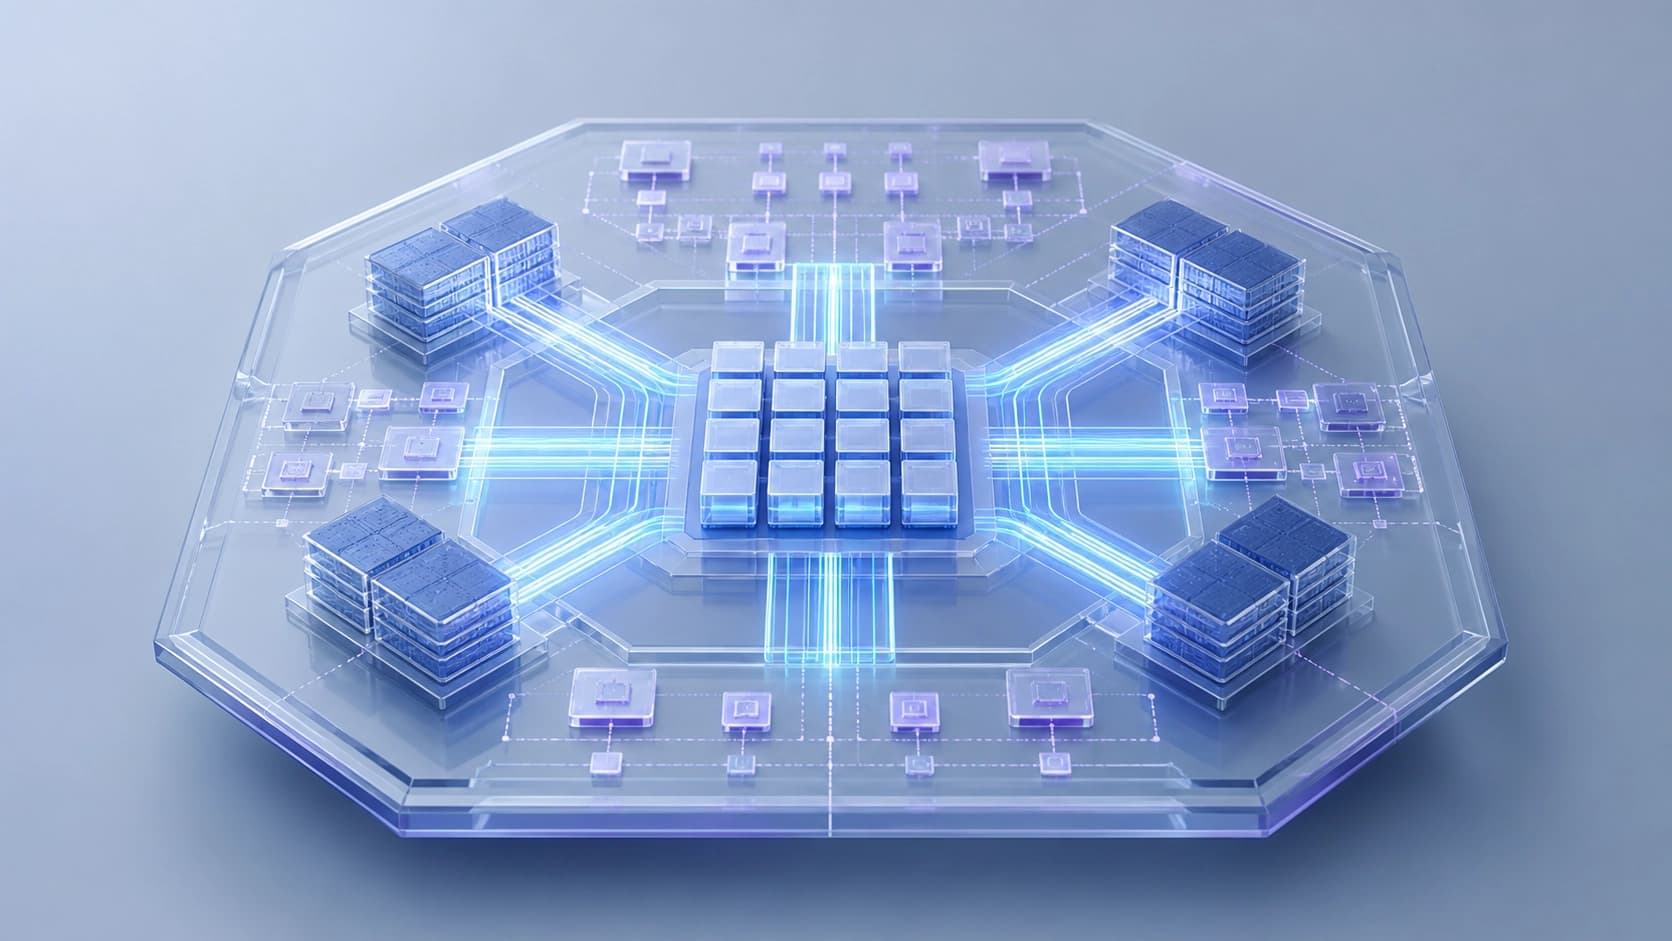
Dalam Maia 200, logikanya dibalik. Penulis menggolongkan chip ini ke dalam kelas baru — Software Defined Locally Accessed Dataflow Architectures, disingkat SDLA. Kata kuncinya di sini adalah «software defined»: mesin dataflow tidak sekadar ada di dalam silikon, melainkan diprogram secara eksplisit. Programmer mendeskripsikan bagaimana blok memori khusus dan mesin pemindah data harus diorkestrasi. Kendali menjadi eksplisit, bukan efek samping dari pipeline.
Dari sini pula pergeseran fokusnya: bukan thread-centric, melainkan data-movement-centric. Pertanyaan «berapa instruksi per siklus» digantikan oleh pertanyaan «seberapa cepat dan tanpa kehilangan data tiba di tempat data itu akan dihitung». Untuk beban kerja modern, ini adalah dua rumusan masalah yang secara fundamental berbeda.
Angka-angka
Spesifikasi kering dari abstrak terlihat seperti ini:
- 10 145 Tflop/s dalam format FP4;
- 5072 Tflop/s dalam FP8;
- bandwidth memori HBM — 7 TB/s;
- daya termal — 750 W.
Apa arti angka-angka ini — dan apa yang tidak
Godaan untuk langsung membandingkan 10 145 Tflop/s dalam FP4 dengan sesuatu yang familiar sangat besar, tetapi tidak ada yang bisa dibandingkan secara tepat: penulis tidak mempublikasikan pengukuran pada model tertentu, dan format presisi yang berbeda serta metodologi pengukuran yang berbeda menghasilkan angka yang tidak sebanding. Perlu juga diingat bahwa presisi yang sangat rendah (FP4) selalu merupakan kompromi pada kualitas, dan keunggulan dalam angka tidak sama dengan keunggulan dalam kerja yang berguna.
Yang jauh lebih menarik di sini adalah 7 TB/s. Karakteristik inilah yang bersesuaian dengan ide utama artikel: jika arsitektur dibangun di sekitar perpindahan data, maka bandwidth memori bukanlah parameter sekunder, melainkan struktur penopang. Dan 750 W adalah pengingat bahwa yang dibicarakan adalah rak server, bukan kartu desktop.
SDLA dan taksonomi baru
Untuk menjelaskan bagaimana chip seperti ini berbeda dari yang biasa, penulis membangun taksonomi pengelolaan data. Acuannya adalah klasifikasi lama dari Flynn, yang membagi mesin berdasarkan jumlah aliran perintah dan data. Itu adalah bahasa yang nyaman untuk era ketika hambatan utama terletak pada eksekusi.
Kini, menurut pemikiran penulis, dibutuhkan bahasa lain — tentang bagaimana sistem mengelola data. Klasifikasinya bukan tentang «berapa banyak», melainkan tentang «bagaimana diorganisasi». Dan dalam kerangka ini, SDLA menempati sel tersendiri: arsitektur di mana memori dan perpindahan data adalah warga kelas satu, bukan sekadar latar belakang.
Makna praktis dari taksonomi semacam ini bukanlah kecintaan pada diagram. Ia memberi para insinyur sebuah kosakata: kita dapat berdebat secara bermakna tentang kelas mana yang dimiliki perangkat keras tertentu dan tugas apa yang cocok untuknya, alih-alih mengukur semuanya dengan satu angka.
Mengapa ini penting untuk inferensi
Inferensi sebagian besar adalah tentang mengalirkan volume bobot dan aktivasi yang sangat besar melalui chip dengan latensi minimal. Semakin besar model, semakin kuat semuanya terhambat oleh memori dan koneksi antar blok, bukan oleh aritmetika. Efisiensi di sini ditentukan oleh seberapa baik sistem mampu memindahkan data.
Penulis mengklaim bahwa Maia 200 memberikan penghematan biaya dan energi yang signifikan, mendukung paralelisme masif tepatnya pada beban kerja inferensi. Jika ini terbukti pada tugas nyata, bukan hanya pada data sintetis, maka yang dibicarakan adalah keseimbangan yang berbeda: bukan «chip tercepat», melainkan «chip yang lebih murah untuk dijalankan pada volume permintaan yang sama». Untuk pusat data, di mana hitungannya dalam megawatt, inilah argumen yang menentukan.
Apa yang masih tersembunyi
Ketelitian menuntut catatan. Karya ini adalah pracetak: arXiv:2608.24664, DOI 10.48550/arXiv.2608.24664, tersedia PDF, versi HTML eksperimental, dan sumber TeX. Tinjauan sejawat, pengukuran independen, dan reproduksi hasil masih di depan. Janji tentang penghematan energi dan biaya sebaiknya dibaca sebagai pernyataan penulis, bukan sebagai fakta terukur dari pihak ketiga.
Pertanyaan kedua adalah biaya transisi. Dataflow yang dapat diprogram menuntut cara berpikir yang berbeda: pengembang perlu mendeskripsikan rute data secara eksplisit, sementara kompilator dan framework perlu belajar memanfaatkannya. Selama ekosistem belum menyusul, keunggulan perangkat keras tidak akan terlihat oleh semua orang dan tidak langsung. Begitulah yang terjadi pada setiap pergantian tonggak arsitektural: pertama konsep, lalu alat, lalu adopsi massal.
Namun yang terpenting dalam kisah ini bukanlah teraflops spesifiknya. Yang lebih penting adalah rumusannya sendiri: hambatan komputasi AI telah bergeser ke tempat data melakukan perjalanan, bukan ke tempat perintah dieksekusi. Jika gagasan ini benar, chip generasi berikutnya akan dirancang secara berbeda — dan mungkin, justru dari karya inilah penghitungan dimulai.


