
Variasi pada input, bukan pada penalaran: perbandingan metode augmentasi pengujian untuk LLM
Studi ini membandingkan sumber variasi saat inferensi LLM—parafrase prompt, perubahan ejaan, dan transformasi gambar—dengan jumlah panggilan yang sama. Pada enam benchmark, mempertahankan makna menghasilkan peningkatan akurasi terbesar, sementara gangguan pada tingkat karakter dan perturbasi simultan pada dua modalitas kurang bermanfaat.
Dua sumber keberagaman: input dan penalaran
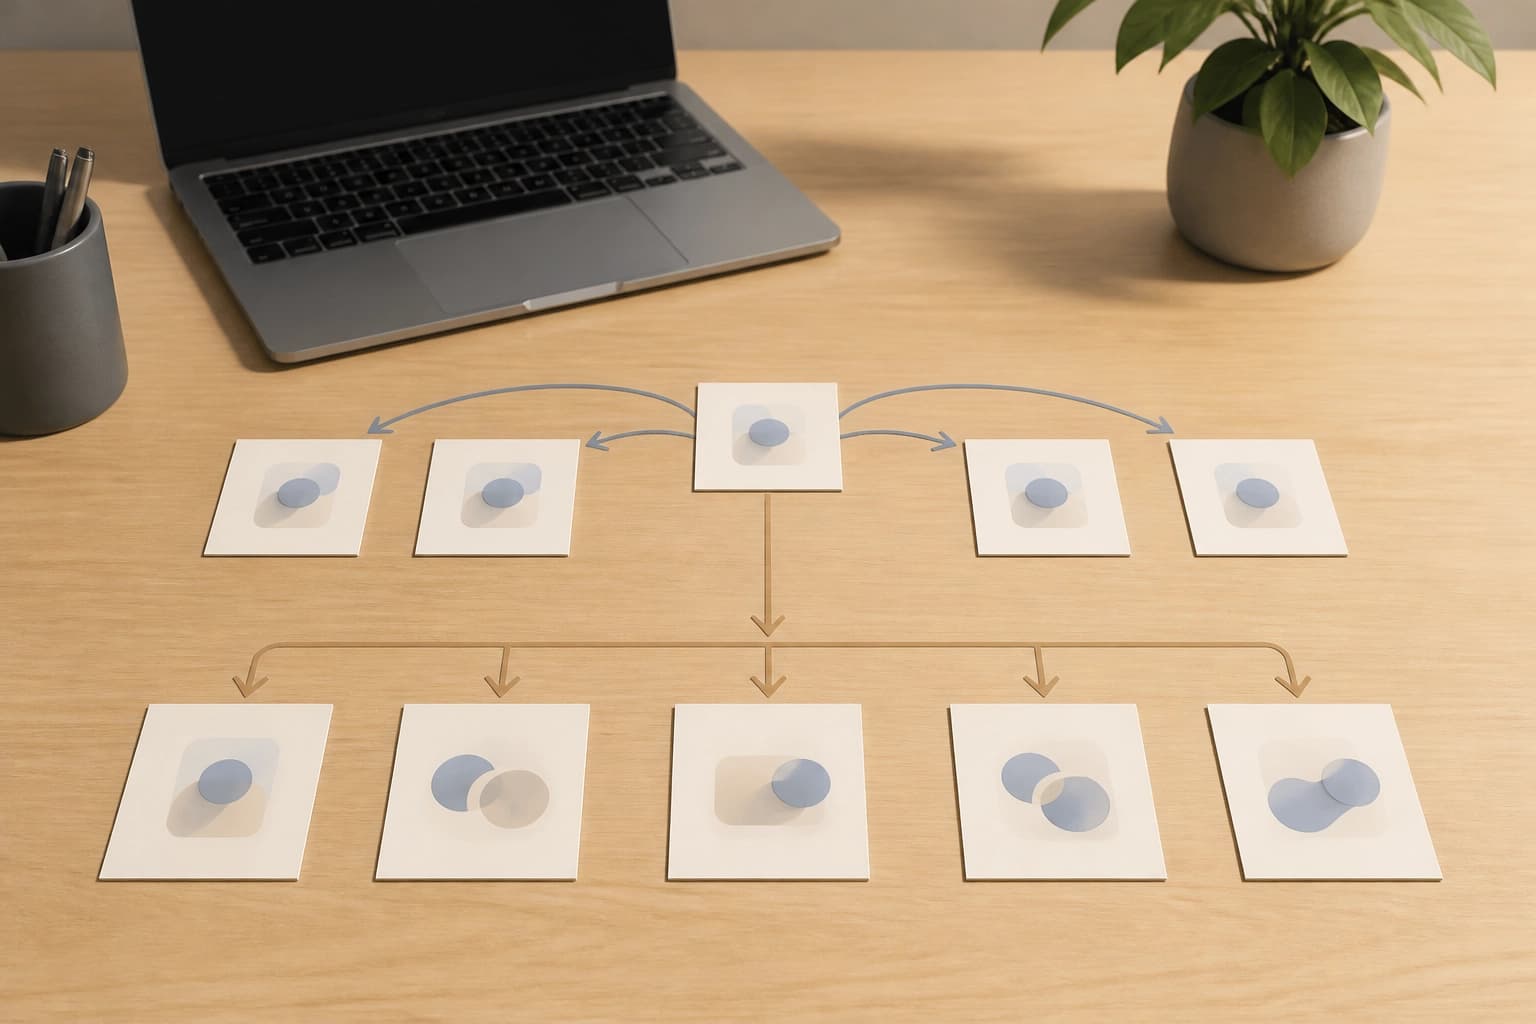
Test-Time Augmentation (TTA) menggabungkan prediksi dari versi input yang telah ditransformasi. Keberagaman dihasilkan dengan memparafrasekan pertanyaan, mengubah ejaan, atau mentransformasi gambar pendamping. Self-consistency bekerja dengan cara berbeda: hanya mengubah jalur penalaran dan menggunakan kembali input yang tetap.
| Metode | Sumber keberagaman |
|---|---|
| TTA | versi input yang telah ditransformasi |
| Self-consistency | jalur penalaran dengan input tetap |
TTA menguji ketahanan terhadap perubahan input. Self-consistency menguji ketahanan penalaran dengan satu input. Pilihan bergantung pada sumber keberagaman yang dibutuhkan untuk tugas tersebut.
Mengapa jumlah panggilan inferensi yang setara mengubah kesimpulan
Penulis membandingkan berbagai varian pada enam benchmark. Jumlah panggilan inferensi dibuat sama. Kondisi ini memisahkan efek sumber keberagaman dari efek komputasi tambahan.
- enam benchmark;
- jumlah panggilan yang setara;
- perbandingan sumber, bukan jumlah.
Penulis melaporkan: sumber keberagaman lebih penting daripada jumlahnya. Kesimpulan untuk memilih metode: metode sebaiknya dibandingkan dengan jumlah panggilan yang setara. Jika tidak, peningkatan akurasi bisa dikaitkan dengan sumbernya, bukan dengan panggilan tambahan.
Parafrase: peningkatan dan puncak yang lebih awal
Parafrase input dengan tetap mempertahankan maknanya menghasilkan peningkatan akurasi terbesar. Peningkatannya sebesar +1.80 poin persentase dibandingkan satu panggilan. Akurasi puncak tercapai dengan jumlah sampel paling sedikit.
Untuk model kelas menengah, seperti Claude Haiku, mengubah formulasi pertanyaan terbukti lebih efektif dalam memanfaatkan panggilan inferensi daripada mengubah jalur penalaran.
Kesimpulan praktis: jika transformasi mempertahankan makna, parafrase menjadi kandidat pertama untuk TTA. Cara ini menghasilkan peningkatan sekaligus mencapai puncak lebih awal.
Noise per karakter: banyak perbedaan, sedikit manfaat
Noise per karakter menyebabkan lebih banyak perbedaan di antara jawaban: 37.8% dibandingkan 27.4%. Peningkatan akurasinya lebih rendah. Variasi jawaban yang tinggi tidak berarti bermanfaat untuk agregasi.
Perbedaan yang muncul setelah makna dirusak adalah keliru. Perbedaan seperti itu tidak memberikan sinyal yang berguna untuk agregasi.
Kesimpulan praktis: nilai akurasi, bukan hanya proporsi perbedaan. Noise per karakter tidak dapat menggantikan transformasi yang mempertahankan makna.
Gangguan ganda: ketika kombinasi memberikan hasil lebih buruk
Gangguan pada dua modalitas secara bersamaan menghasilkan kinerja di bawah tingkat dasar satu panggilan. Menggabungkan transformasi tidak menjamin hasil yang lebih baik.
- mengganggu dua modalitas secara bersamaan;
- hasil di bawah tingkat dasar satu panggilan;
- menguji kombinasi secara terpisah.
Kesimpulan praktis: gabungkan modalitas hanya setelah melakukan perbandingan terpisah. Jika tidak, TTA bisa menghasilkan kinerja di bawah satu panggilan.
Memilih metode secara praktis
Kriteria pemilihan didasarkan pada sumber keberagaman, pelestarian makna, dan jumlah panggilan yang setara.
| Tugas | Metode |
|---|---|
| Menguji ketahanan terhadap formulasi | TTA dengan parafrase |
| Menguji ketahanan penalaran dengan input yang sama | self-consistency |
| Menilai sensitivitas terhadap ejaan | TTA dengan noise per karakter |
| Menggabungkan modalitas | hanya setelah perbandingan terpisah |
Kriteria praktis: pilih sumber keberagaman yang sesuai dengan tugas. Untuk meningkatkan akurasi melalui TTA, parafrase memberikan efek terukur terbesar. Untuk menguji penalaran dengan input yang sama, gunakan self-consistency.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Verifikasi kandidat lebih mahal daripada generasinya: honeypot untuk melawan pencarian kerentanan berbasis LLM
Karya ini mengulas asimetri biaya dalam pencarian bug oleh agen: menghasilkan kandidat itu murah, sedangkan mengonfirmasinya melalui analisis keterjangkauan, eksekusi, dan PoC membutuhkan sebagian besar anggaran, sehingga verifikasi dapat dijadikan sasaran pertahanan tersendiri. RedHerring yang diusulkan—umpan yang disesuaikan dengan repositori dan dilengkapi sertifikat tertutup—mengurangi jumlah kerentanan nyata yang ditemukan sebesar 38,7–60,4% dengan biaya yang sama di 33 proyek OSS-Fuzz; bahkan setelah agen diperingatkan, penurunannya tetap mencapai 37,2%.
9 November 2026
Pemeriksaan halusinasi LLM melalui tampilan sumber SQL tanpa fine-tuning
Penelitian ini menguji apakah LLM dapat memanfaatkan keterampilan simbolik dasar—menyusun basis data SQL dari dokumen sumber—untuk melakukan grounding ke sumber tanpa supervisi dalam deteksi halusinasi. Pada RAGTruth dan DiaHalu, pipeline neuro-simbolik ini lebih akurat daripada prediksi langsung dan sebanding dengan metode mutakhir, tanpa memerlukan fine-tuning khusus domain.
9 November 2026
MathAdv: Apa yang Tersembunyi di Balik Akurasi Akhir Pembuktian Mesin
Kumpulan tugas diagnostik dari 13 bidang matematika tingkat universitas dan pascasarjana ini mengevaluasi sistem pembuktian otomatis di Lean 4 tidak hanya berdasarkan hasil akhir, tetapi juga penguasaan materi, kualitas penalaran informal, dan ketahanan terhadap perumusan ulang soal. Analisis per komponen menunjukkan bahwa menerjemahkan soal ke dalam bentuk formal masih menjadi kendala utama, sementara tingkat keberhasilan sangat bergantung pada bidang matematika dan cara soal dirumuskan.
9 November 2026