
Pemeriksaan halusinasi LLM melalui tampilan sumber SQL tanpa fine-tuning
Penelitian ini menguji apakah LLM dapat memanfaatkan keterampilan simbolik dasar—menyusun basis data SQL dari dokumen sumber—untuk melakukan grounding ke sumber tanpa supervisi dalam deteksi halusinasi. Pada RAGTruth dan DiaHalu, pipeline neuro-simbolik ini lebih akurat daripada prediksi langsung dan sebanding dengan metode mutakhir, tanpa memerlukan fine-tuning khusus domain.
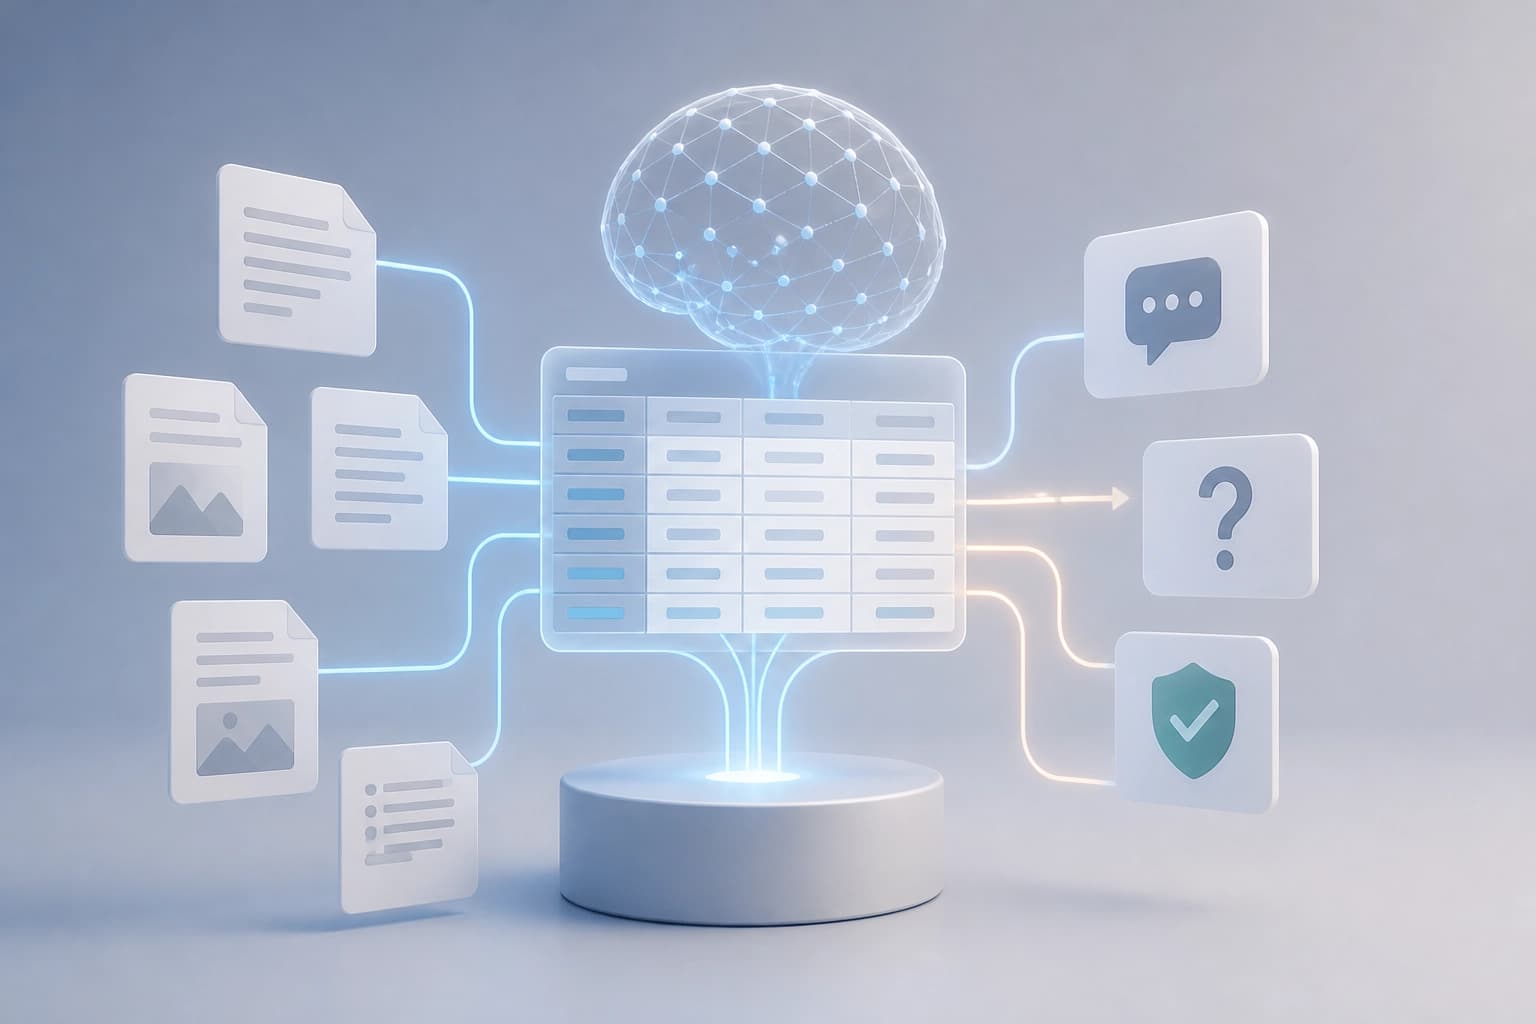
Tugas Deteksi Halusinasi
Halusinasi adalah keluaran model bahasa yang secara faktual keliru atau tidak didukung oleh sumber. Deteksi keluaran seperti ini dipersulit oleh ketidaktransparanan penalaran LLM. Tidak banyak yang diketahui tentang mengapa keluaran model bisa tidak akurat.
Artikel ini mengkaji deteksi halusinasi tanpa supervisi. Pendekatan ini memeriksa keluaran berdasarkan sumber, bukan berdasarkan keyakinan internal model. Kesimpulannya: pemeriksaan memerlukan jangkar eksternal — dokumen sumber.
Database SQL sebagai Representasi Sumber
Para penulis mengusulkan agar model bahasa membangun database SQL dari dokumen sumber. Database menjadi representasi terstruktur dari fakta dalam sumber. Selanjutnya, database digunakan untuk melakukan penalaran berdasarkan sumber dan jawaban yang dihasilkan.
Kesimpulannya: representasi SQL mengubah pemeriksaan menjadi kueri data.
Pipeline Pemeriksaan Neuro-simbolik
Pipeline deteksi halusinasi didasarkan pada database yang telah dibangun. Pipeline ini memungkinkan pemeriksaan neuro-simbolik. Pipeline memadukan model bahasa dan operasi simbolik dengan database SQL. Pemeriksaan dilakukan berdasarkan sumber dan jawaban yang dihasilkan.
Kesimpulannya: langkah pemeriksaan menjadi eksplisit dan dapat direproduksi melalui kueri.
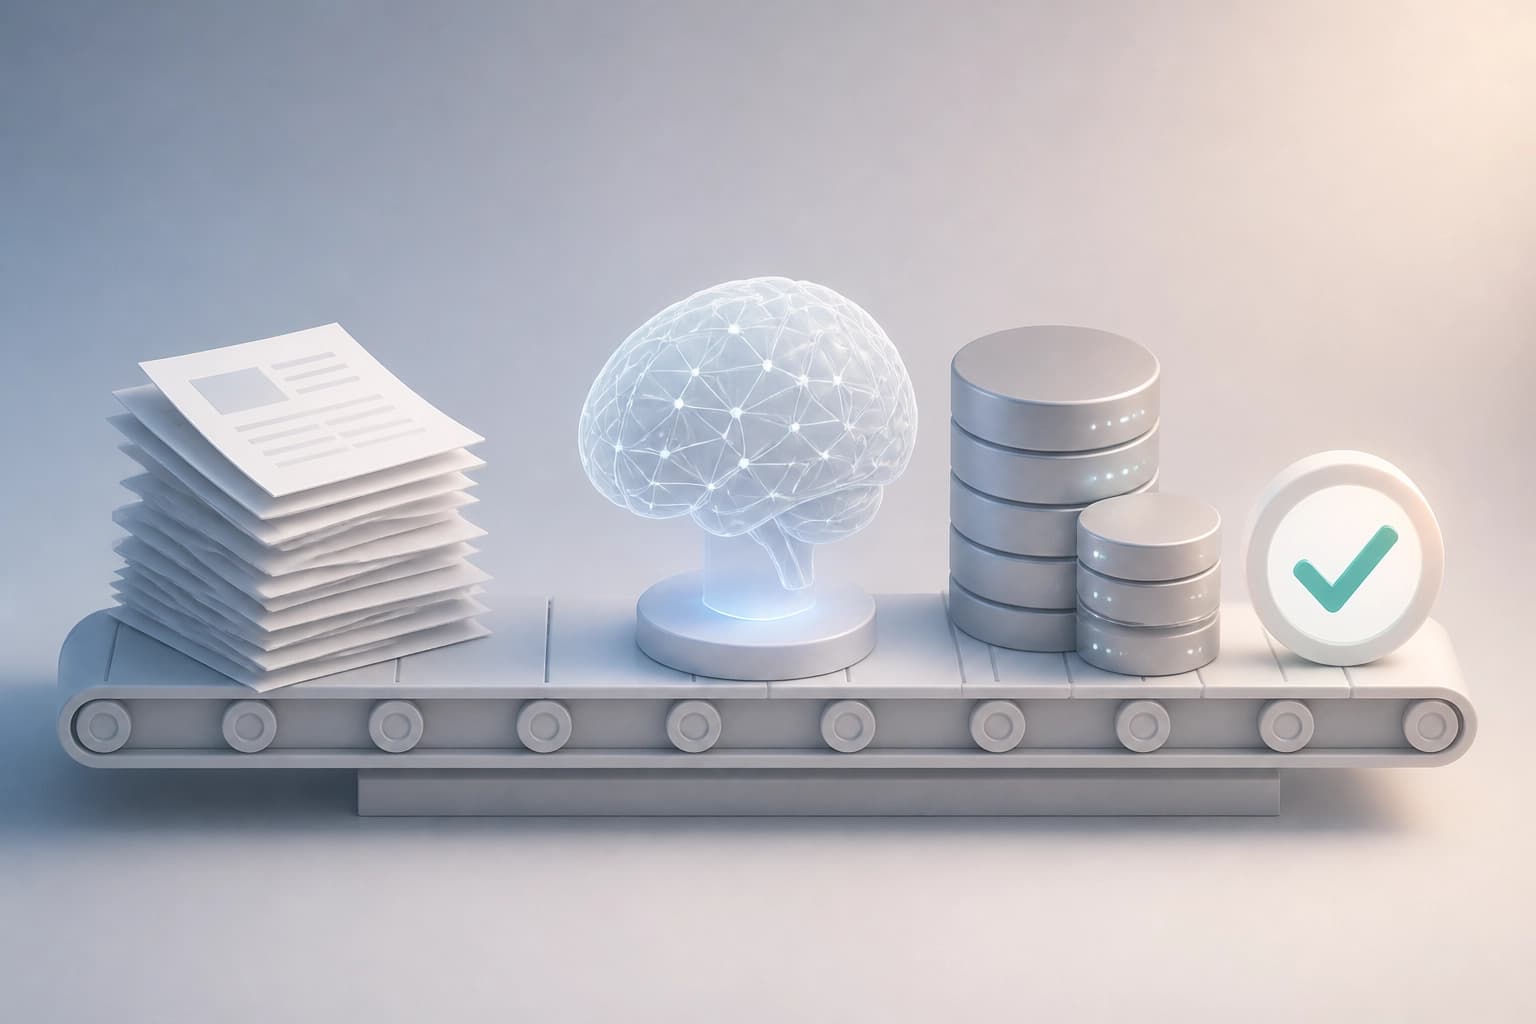
Perbandingan dengan Prediksi Langsung
Pada dataset RAGTruth dan DiaHalu, pendekatan ini mengungguli prediksi langsung. Pendekatan ini bersaing dengan metode deteksi halusinasi mutakhir. Pendekatan ini tidak memerlukan fine-tuning khusus domain. Pendekatan ini mengandalkan kompetensi umum tingkat rendah yang sudah dimiliki LLM.
| Kriteria | Prediksi langsung | Pendekatan melalui database SQL | | Yang digunakan | LLM langsung memberikan penilaian | Database SQL berdasarkan sumber dan pemeriksaan neuro-simbolik | | Fine-tuning khusus domain | Tidak disebutkan | Tidak diperlukan | | Hasil pada RAGTruth dan DiaHalu | Kalah dari pendekatan SQL | Mengungguli prediksi langsung dan bersaing dengan metode mutakhir |
Kesimpulannya: pendekatan SQL memberikan pijakan yang dapat diverifikasi pada sumber. Artikel ini diterima di GroundLM EMNLP 2026 Workshop.
Kriteria Pemilihan Praktis
Kriteria pemilihan mencakup beberapa kondisi:
- tersedia dokumen sumber;
- sumber memungkinkan pembangunan database SQL;
- fine-tuning khusus domain tidak diperlukan;
- pemeriksaan dilakukan berdasarkan sumber dan jawaban yang dihasilkan.
Pendekatan ini mengandalkan kompetensi simbolik tingkat rendah LLM, misalnya SQL. Kesimpulannya: pendekatan ini sesuai ketika pemeriksaan berpijak pada sumber dan fine-tuning khusus domain tidak diperlukan.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
MathAdv: Apa yang Tersembunyi di Balik Akurasi Akhir Pembuktian Mesin
Kumpulan tugas diagnostik dari 13 bidang matematika tingkat universitas dan pascasarjana ini mengevaluasi sistem pembuktian otomatis di Lean 4 tidak hanya berdasarkan hasil akhir, tetapi juga penguasaan materi, kualitas penalaran informal, dan ketahanan terhadap perumusan ulang soal. Analisis per komponen menunjukkan bahwa menerjemahkan soal ke dalam bentuk formal masih menjadi kendala utama, sementara tingkat keberhasilan sangat bergantung pada bidang matematika dan cara soal dirumuskan.
9 November 2026
AffordanceWAM: affordance sebagai perantara antara prediksi adegan dan kendali manipulator
Karya ini menjelaskan model generatif yang secara bersamaan memprediksi observasi RGB masa depan, medan skalar dan peta panas affordance, serta perintah robot kontinu, dengan memanfaatkan video manusia untuk memperluas keragaman interaksi tanpa anotasi tindakan dan retargeting. Pada RoboCasa, CALVIN ABC→D, dan tugas dunia nyata, pendekatan ini memberikan peningkatan yang konsisten dibandingkan baseline yang hanya menggunakan RGB dan yang hanya menggunakan data robot.
9 November 2026
Penyuntingan presentasi sebagai operasi terkontrol: kerangka kerja EditPPT dan benchmark DeckEdit-Bench
Para penulis membahas pengeditan slide berdasarkan objek tertentu, tindakan yang diizinkan, dan pemeriksaan bahwa konten yang tidak terkait tetap tidak tersentuh, alih-alih menghasilkan kode secara bebas. Untuk mengukur kualitas, mereka membuat DeckEdit-Bench (183 tugas pada 28 presentasi buatan manusia), dan skema multiagen EditPPT pada lima model dasar menunjukkan tingkat keberhasilan 66,7–74,9% tugas dengan tingkat keutuhan di atas 97%.
8 November 2026