
Kontrol eksekutif agen LLM: memindahkan evaluasi progres dan wewenang untuk menghentikan ke luar generator menghemat sepertiga token
Pracetak ini menguraikan kondisi ketika agen bahasa terus melakukan penyempurnaan dan pemeriksaan yang kurang bermanfaat setelah mencapai tujuan, dengan penjelasan bahwa hal ini disebabkan oleh lingkaran penguatan diri ketika proses generasi, evaluasi kemajuan, dan keputusan untuk berhenti tidak dipisahkan. Lapisan kendali global yang diusulkan, dengan mempertimbangkan ketidakpastian, mempertahankan tingkat keberhasilan sekitar 96,6% sekaligus mengurangi rata-rata penggunaan token sebesar 36,4%, meskipun kesimpulan ini sejauh ini baru diperoleh dari simulasi mekanistik.
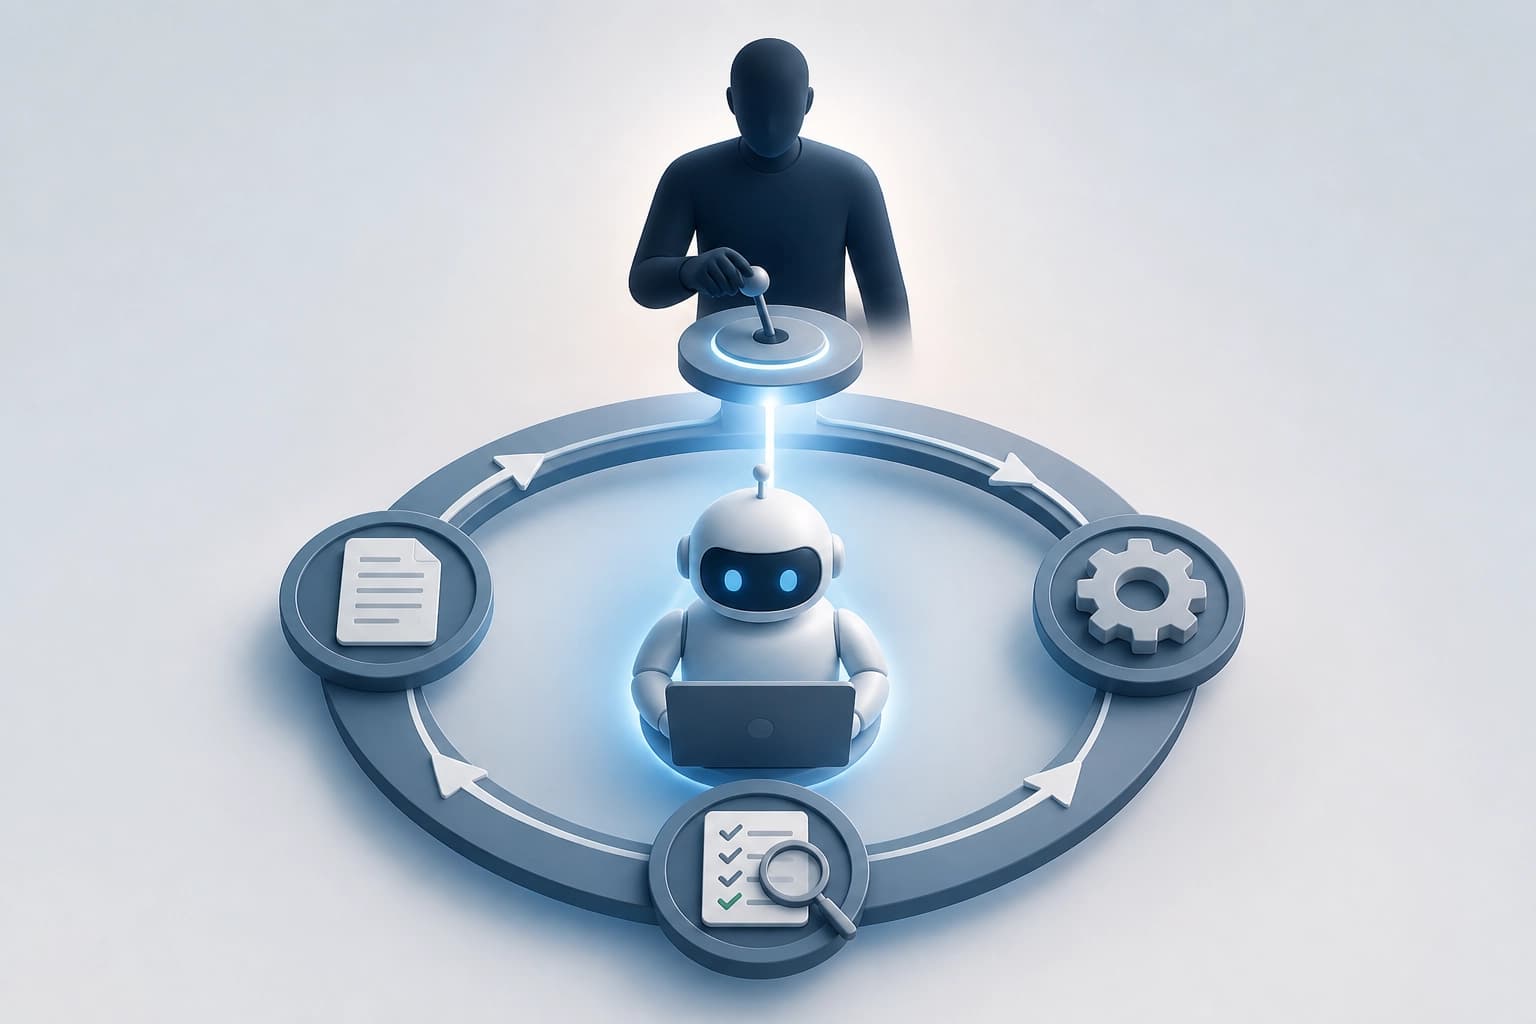
Apa itu LLM Parkinsonism
Istilah LLM Parkinsonism diperkenalkan sebagai metafora nonklinis yang sempit. Istilah ini menggambarkan tindakan yang terus berlanjut meskipun nilainya bagi tugas menurun.
Ciri-ciri perilaku ini:
- agen terus bertindak setelah tujuan awal tercapai;
- melakukan penyempurnaan bernilai rendah;
- menjalankan pemeriksaan berulang;
- memperbaiki kerumitan yang dibuatnya sendiri.
Kesimpulan: metafora ini menunjukkan kegagalan kontrol, bukan analogi klinis.
Mengapa kontrol diri dalam satu loop memperburuk masalah
Para penulis mengaitkan masalah ini bukan hanya dengan prediksi token berikutnya secara autoregresif. Penyebab lainnya adalah terkonsentrasinya empat fungsi dalam satu loop.
- pembangkitan usulan;
- interpretasi ruang lingkup tugas;
- penilaian kemajuan;
- wewenang untuk menghentikan.
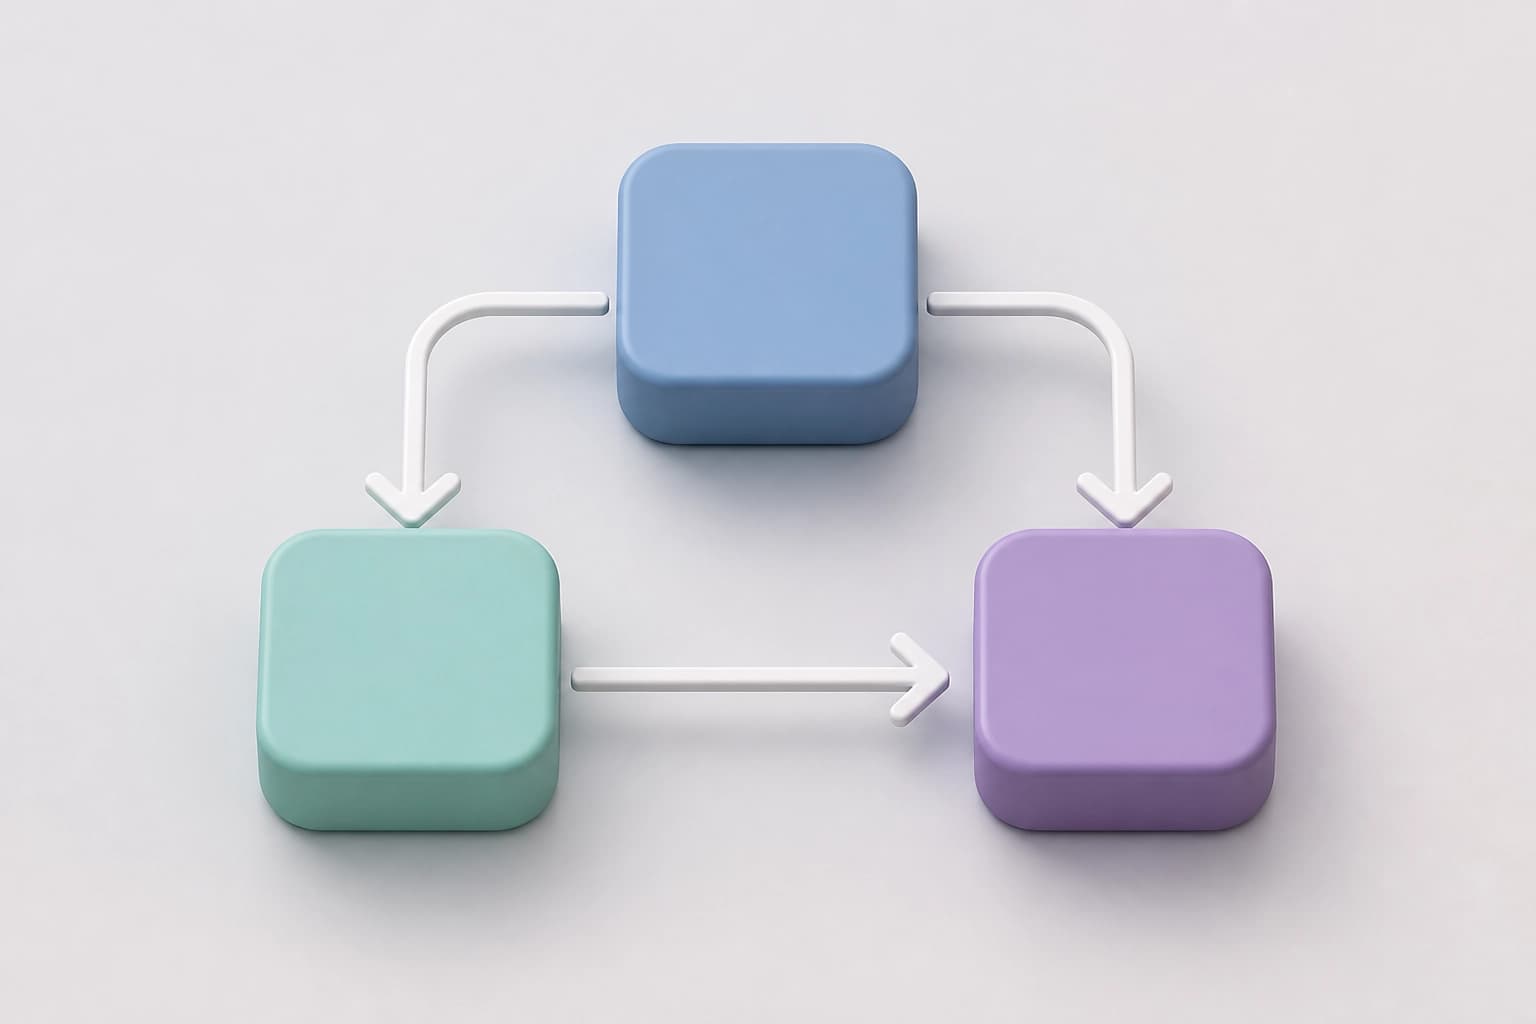
Loop semacam ini bekerja dengan penguatan diri. Penilaian, pembangkitan, dan penghentian saling memengaruhi.
Kesimpulan: untuk memutus penguatan diri, sebagian fungsi perlu ditempatkan di luar generator.
Global Executive Control: apa yang ditempatkan di luar generator
Global Executive Control (GEC) v0.2 adalah arsitektur kontrol yang mempertimbangkan ketidakpastian. Arsitektur ini memisahkan pembangkitan tindakan dari kontrol di tingkat proyek.
Yang ditempatkan di luar generator:
- ruang lingkup tugas;
- bukti;
- penggunaan sumber daya;
- penghentian.
Kontrol di tingkat proyek memiliki wewenang untuk menghentikan dan menilai kemajuan. Generator bertanggung jawab atas tindakan.
Kesimpulan: kriteria praktisnya adalah penilaian kemajuan dan penghentian harus berada di luar loop pembangkitan.
Apa yang ditunjukkan oleh pengukuran
Benchmark mencakup 24,000 episode dengan kandidat yang sebanding dan batas total 40,000 token. Tiga varian dibandingkan.
| Varian kontrol | Keberhasilan berdasarkan tujuan ketat |
|---|---|
| Baseline dengan kandidat pertama | 67.42% |
| Kontrol lokal dengan kumpulan kandidat | 96.53% |
| GEC | 96.57% |
Akses ke beberapa opsi tindakan menjelaskan sebagian besar peningkatan keberhasilan. GEC mempertahankan tingkat keberhasilan sekaligus menurunkan rata-rata penggunaan token.
- rata-rata penggunaan token: dari 19,782 menjadi 12,574 (36.4%);
- rata-rata jumlah token yang dibatasi hingga penyelesaian dengan batas 40,000 token: dari 16,136 menjadi 13,114 (18.7%).
GEC menghilangkan pergeseran yang terukur sebelum tugas selesai dan secara drastis mengurangi kerumitan yang berlebihan. Sensitivitas terhadap overhead kontrol tetap menguntungkan saat ditambahkan hingga 500 token kontrol sintetis per siklus.
Kesimpulan: kumpulan kandidat memberikan sebagian besar peningkatan keberhasilan; GEC menambahkan penghematan token dan kontrol kerumitan.
Kriteria praktis untuk memilih kontrol
Ada lima kondisi yang perlu diperiksa:
- penilaian kemajuan eksternal dipisahkan dari generator;
- wewenang untuk menghentikan berada di luar loop pembangkitan;
- tersedia beberapa kandidat tindakan;
- penggunaan sumber daya diperhitungkan;
- ketidakpastian diperhitungkan.
Kesimpulan: jika fungsi-fungsi ini tetap berada di dalam generator, risiko penyempurnaan bernilai rendah dan penggunaan token yang berlebihan tetap ada.
Batasan dan hal-hal yang perlu diperiksa selanjutnya
Hasil diperoleh dari simulasi mekanistik. Para penulis berpendapat bahwa hasil tersebut mendukung kontrol eksplisit atas ruang lingkup tugas, bukti, penggunaan sumber daya, dan penghentian.
Batasan:
- pengujian pada model nyata tetap diperlukan;
- simulasi mekanistik tidak menggantikan pengujian tersebut.
Kesimpulan: prinsip arsitekturnya tampak beralasan, tetapi angka-angkanya tidak boleh diterapkan pada LLM nyata tanpa pengujian.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026