Produk tidak bisa direduksi menjadi satu titik di ruang
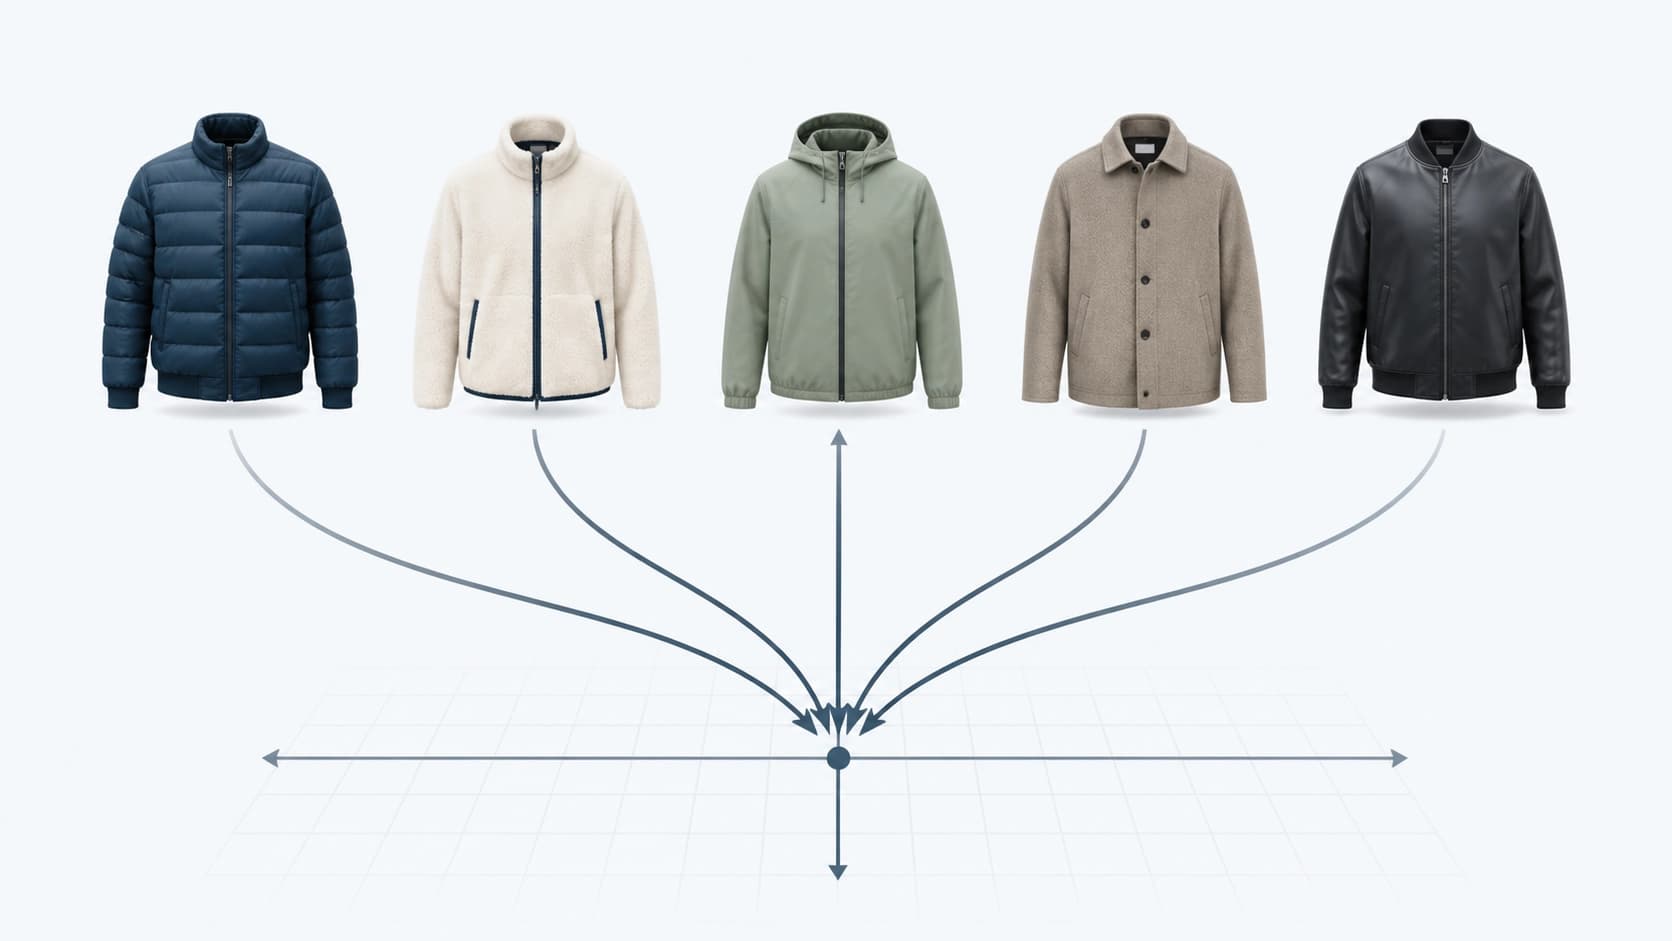
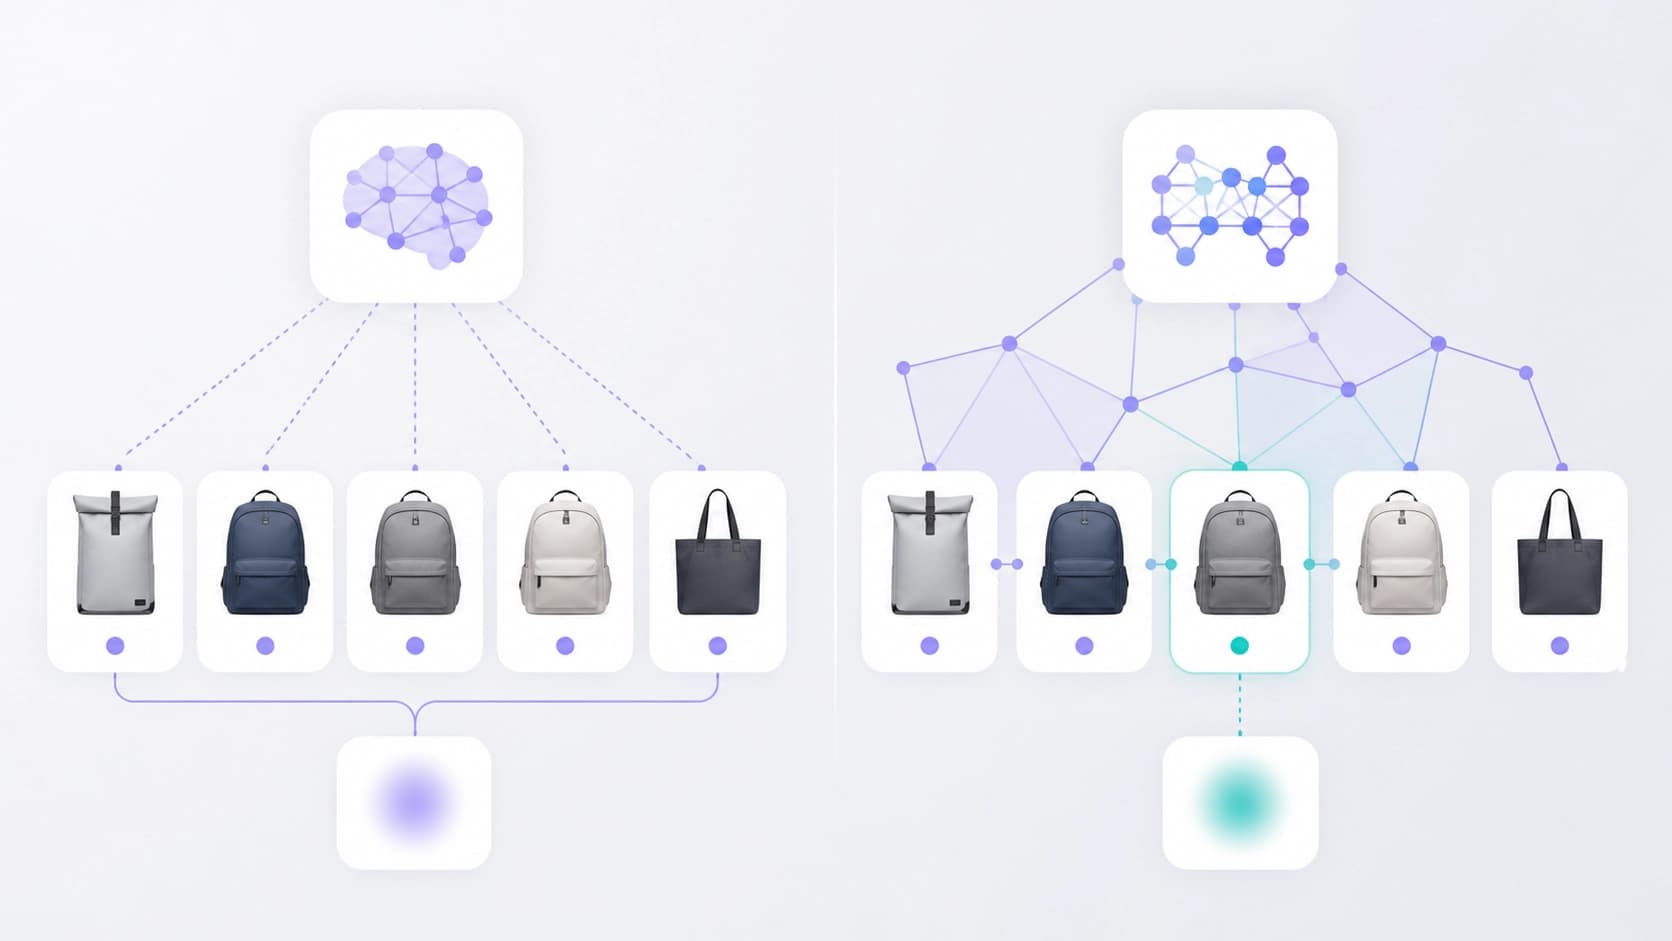
Model bahasa besar multimodal telah belajar cukup baik untuk "memahami" kartu produk: mereka menghubungkan foto, nama, dan deskripsi ke dalam satu medan makna yang utuh. Namun skema ini memiliki biaya tersembunyi. Informasi produk dikompresi menjadi satu embedding global — vektor rata-rata tempat detail-detail larut. Semakin model berusaha mencakup semuanya sekaligus, semakin sedikit kekhususan yang tersisa dalam vektor akhir.
Harga dari kekompakan semacam ini terlihat pada tugas-tugas yang justru mementingkan hal-hal kecil. Dua jaket dari bahan berbeda, dua cangkir dengan glasir yang hampir sama, dua kabel dengan konektor berbeda — secara visual keduanya hampir kembar, dan di ruang embedding berada hampir di satu titik. Padahal pengguna mencari bukan "sesuatu yang mirip", melainkan bahan tertentu, kompatibilitas, atau karakteristik tertentu. Justru pada kueri seperti inilah perataan mulai mengganggu: model tidak membedakan atribut, yang berarti peringkat yang dihasilkan pun menjadi perkiraan kasar.
Artikel arXiv:2608.24467 (Qiuyu Zhu, Yi Gao, Zhichao Wan, Mingyang Ma, Agustus 2026) menegakkan diagnosis secara langsung: embedding global secara implisit mengodekan produk secara keseluruhan, dan ini membatasi penangkapan atribut berbutir halus. Apakah ini bisa disembuhkan dengan sekadar "membuat vektor lebih besar"? Dilihat dari logika penelitiannya — tidak, masalahnya bukan pada dimensi, melainkan pada cara representasi.
Hypergraph alih-alih daftar embedding yang datar
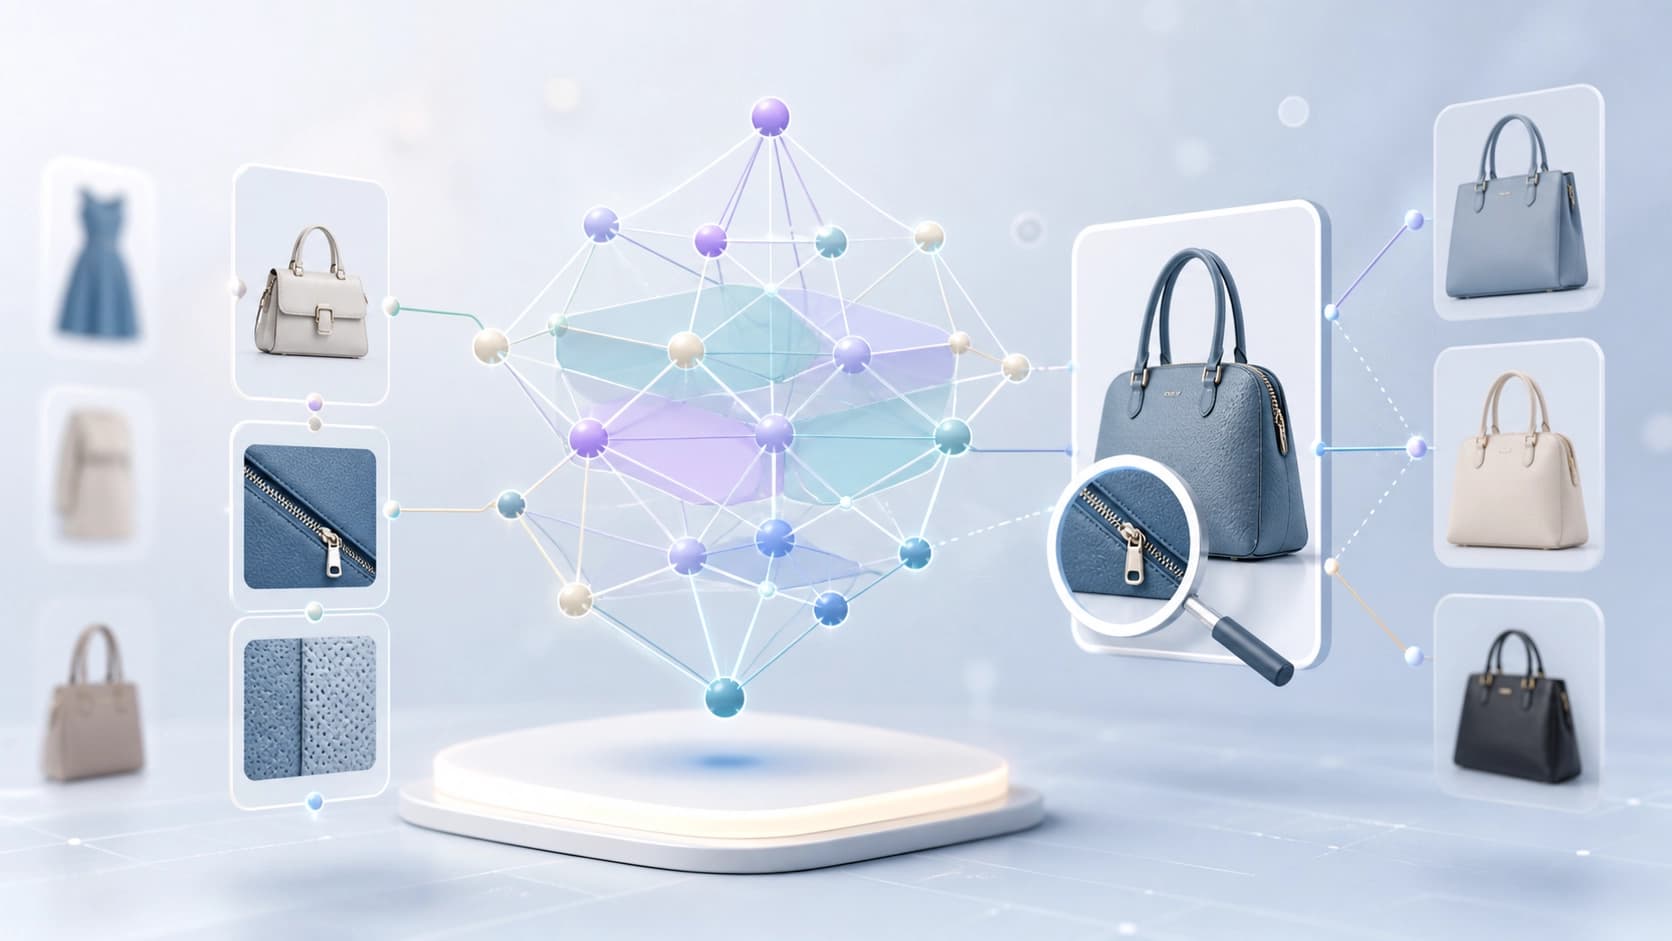
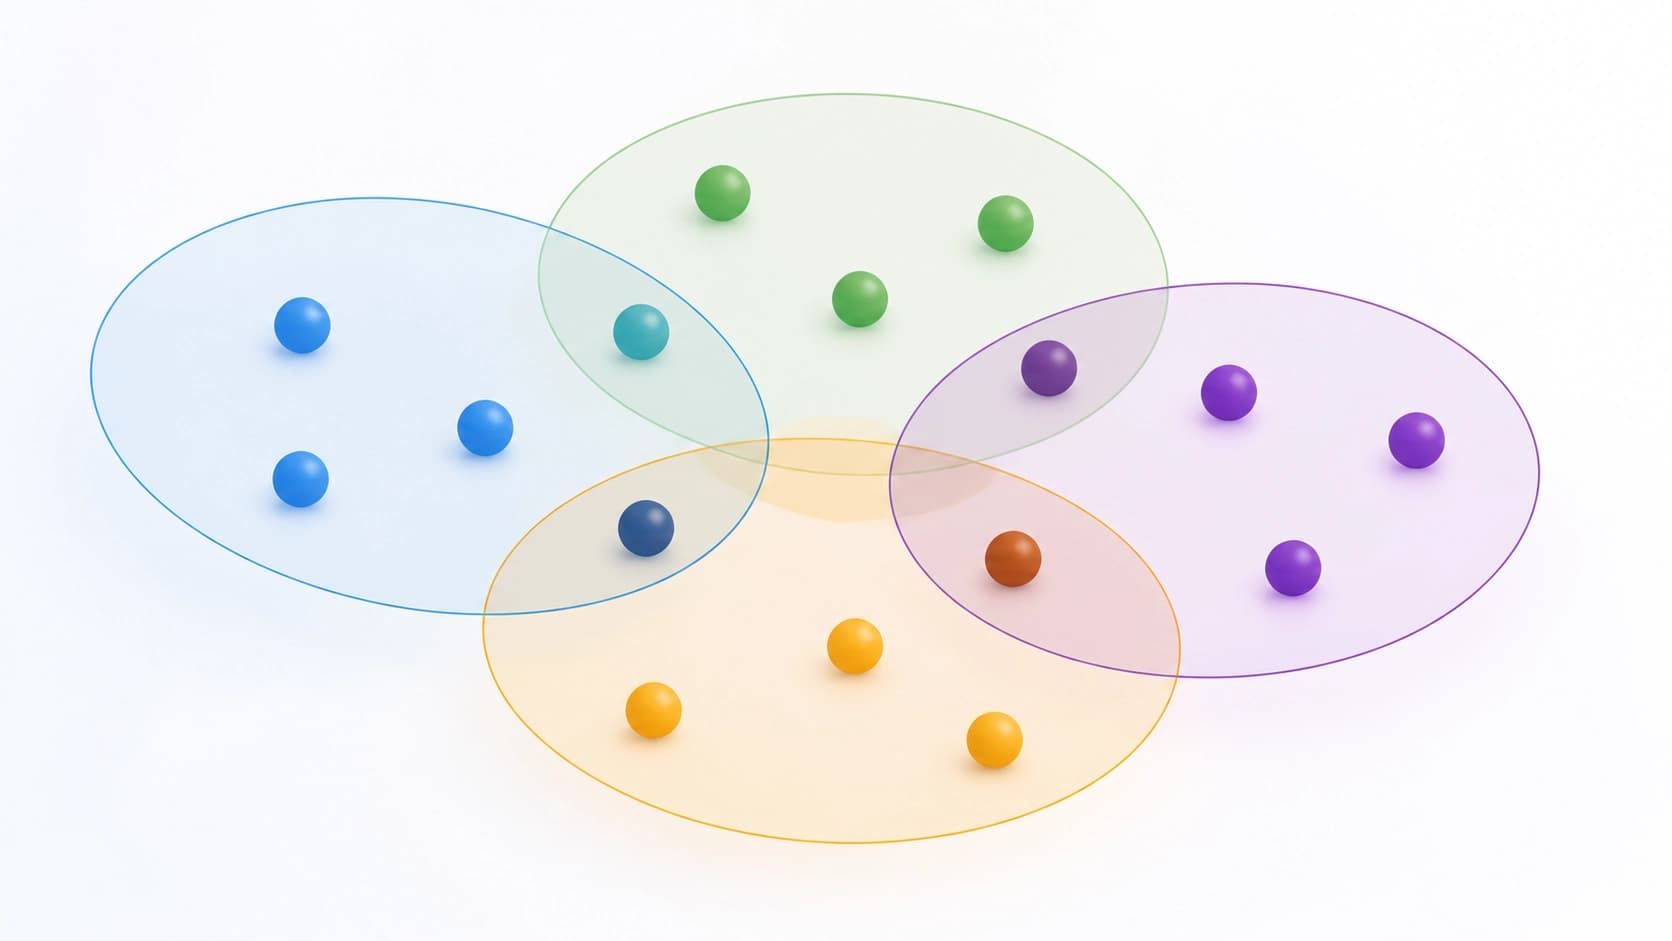
Para penulis mengusulkan HMGCLIP — kerangka kerja embedding multimodal yang berlandaskan hypergraph heterogen. Perbedaannya dengan graf biasa sangat mendasar. Sisi biasa menghubungkan dua objek; hyperedge menghubungkan sekelompok objek sekaligus — misalnya, semua produk dalam satu kategori yang disatukan oleh atribut bersama. Konstruksi semacam ini memungkinkan pendeskripsian relasi yang tidak bisa diuraikan menjadi pasangan: "tujuh item ini adalah satu lini bahan", "empat ini adalah analog yang saling menggantikan".
Selanjutnya, topologi hypergraph bekerja dalam dua arah. Pertama, darinya diekstraksi negatif sulit yang sadar struktur — contoh-contoh yang mirip tetapi salah, yang menjadi bahan pembelajaran model untuk membedakan. Ini poin penting: negatif sulit tidak dipilih secara acak dari korpus, melainkan disarankan oleh struktur keterkaitan itu sendiri. Kedua, melalui hypergraph diselaraskan semantik multi-butir — baik pada tingkat relasi maupun pada tingkat hyperedge. Sederhananya, model menyelaraskan bukan hanya antar produk individual, tetapi juga antar seluruh kelompok makna.
Mengapa diperlukan mekanisme inferensi dua-butir
Detail tersendiri — dual-granularity inference. Pada keluarannya, sistem secara dinamis menggabungkan bukti atributif sehingga mampu bekerja dengan sama percaya diri baik pada tugas berbutir halus maupun berbutir kasar. Makna praktisnya adalah satu kueri membutuhkan tingkat umum ("tunjukkan sepatu sneakers"), sementara kueri lain membutuhkan tingkat yang sangat sempit ("sneakers dengan membran dan jenis sol tertentu"). Model yang hanya terpaku pada detail kehilangan keluasan; yang hanya terpaku pada hal umum kehilangan ketepatan. Di sini diasumsikan sistem sendiri yang memutuskan pada tingkat mana harus melihat.
Dataset dan pengujian
Para penulis tidak berhenti pada arsitektur saja: mereka merilis dataset e-commerce berbutir halus yang komprehensif, agar tugas ini memiliki tolok ukur yang dapat direproduksi untuk perbandingan di masa depan. Ini mungkin bagian karya yang tak kalah berharganya — tanpa kumpulan data publik, memperdebatkan pembedaan berbutir halus menjadi tidak bermakna, setiap orang mengukur pada datanya sendiri.
Eksperimen dilakukan pada dataset baru dan pada tolok ukur publik MAVE. Hasilnya diklaim secara tegas: pendekatan ini mengungguli encoder multimodal yang kuat, LLM multimodal, dan solusi dasar untuk e-commerce. Angka dan tabel spesifiknya ada di dalam karya itu sendiri; di sini yang penting adalah kesimpulannya, bahwa pendekatan struktural terhadap representasi memberikan keunggulan yang tidak dapat dicapai hanya dengan memperumit model.
Di mana ini berguna dalam praktik
Pertama dan paling jelas — pencarian dan pemilihan analog. Ketika pembeli mencari pengganti barang yang rusak, ia membutuhkan kompatibilitas berdasarkan atribut, bukan kemiripan gambar secara umum. Kedua — rekomendasi: rekomendasi menjadi lebih baik jika mampu membedakan varian dengan bahan berbeda dari produk yang sama dalam konfigurasi lain. Ketiga — kebersihan katalog: duplikat dan hampir-duplikat, yang saat ini digabungkan oleh otomatisasi secara asal-asalan, dengan representasi berbutir halus dapat dipisahkan secara lebih bermakna.
Ada pula lapisan yang kurang jelas — keterjelasan. Hyperedge membentuk struktur yang memperlihatkan mengapa produk-produk berada berdekatan. Bagi tim yang menangani kesalahan peringkat, ini lebih berguna daripada vektor yang sifatnya tidak jelas.
Apa yang masih terbuka
Pekerjaan apa pun dengan struktur graf berbenturan dengan biaya: hypergraph harus dibangun, dan ketika katalog diperbarui — harus dipelihara agar tetap mutakhir. Seberapa murah ini pada jutaan kartu dan seberapa sering harus dibangun ulang, para penulis tidak mengungkapkannya dalam abstrak.
Pertanyaan kedua — portabilitas. Dataset dikumpulkan dalam satu domain, dan tidak diketahui seberapa baik pola perilaku hyperedge akan bertahan ketika berpindah, misalnya, dari pakaian ke elektronik, di mana atribut tersusun sangat berbeda. Ketiga — bagaimana pendekatan semacam ini berdampingan dengan pipeline produksi yang sudah berjalan: mengganti cara representasi biasanya berarti mengindeks ulang seluruh indeks pencarian.
Bagaimanapun juga, arahnya sudah ditunjukkan dengan jelas. Perdebatannya bukan tentang model siapa yang lebih besar, melainkan tentang bagaimana menyimpan makna produk dengan benar: dalam satu titik rata-rata atau dalam jaringan keterkaitan, tempat detail-detail tidak larut.