Tiga model, satu lisensi, tanpa syarat tersembunyi
Granite 4.2 bukan lagi asisten yang dirancang khusus untuk mengikuti instruksi seperti rilis-rilis sebelumnya di lini ini. IBM merombak keluarganya dengan mengedepankan penalaran eksplisit: setiap model terlebih dahulu menguraikan rantai langkah, lalu merumuskan jawaban. Rilis ini hadir dalam tiga ukuran — 3B, 8B, dan 30B parameter.
Berita utama bagi dunia bisnis bukanlah soal benchmark, melainkan lisensinya. Ketiga model didistribusikan di bawah Apache 2.0: mengunduh, melatih ulang, dan menjalankannya di produksi tidak memerlukan persetujuan tambahan maupun pembatasan penggunaan komersial. Bagi perusahaan di sektor teregulasi, kemampuan menyimpan bobot model secara on-prem sering kali lebih bernilai daripada angka apa pun di tabel metrik.
Secara paralel, dirilis pula dua model suara Granite Speech 5.0 Turbo CTC masing-masing berukuran 470 juta parameter — akan dibahas tersendiri di bawah.
Mode operasi dapat dialihkan langsung di chat-template. Ada thinking, ada non-thinking, dan di antaranya ada low-effort: anggaran penalaran singkat untuk pertanyaan sederhana, agar tidak membuang token pada tugas yang tidak membutuhkannya. Pada dasarnya, model yang sama mampu menjawab baik untuk "berpikirlah dengan matang" maupun "jawab dengan cepat".
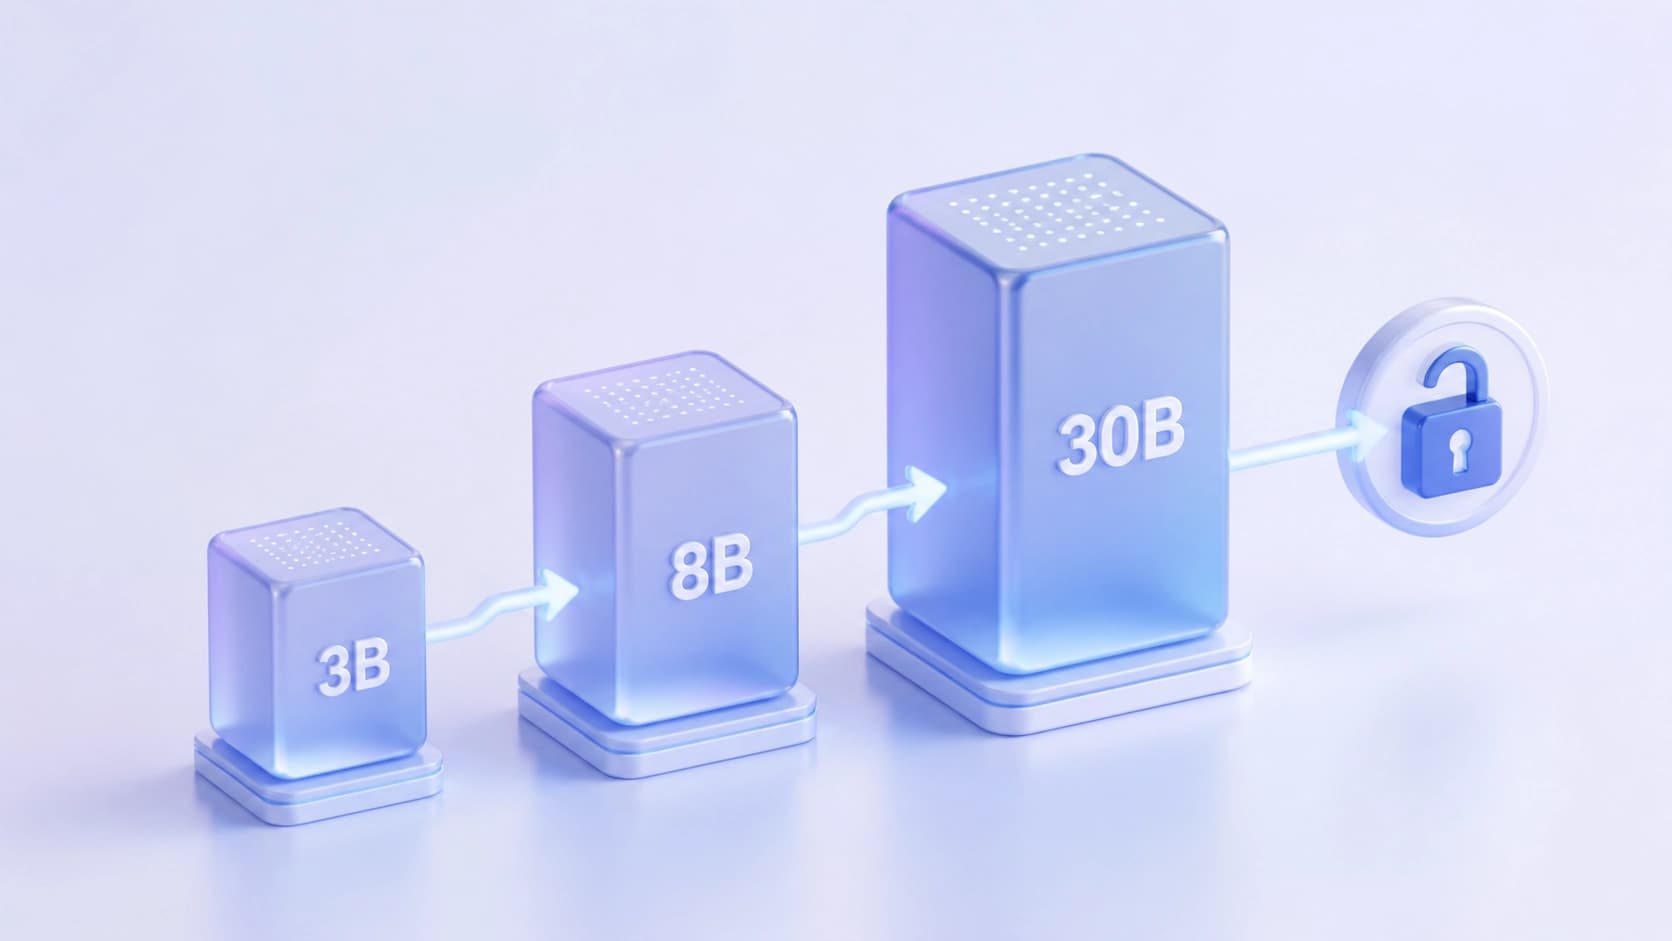
Ukuran mana untuk siapa
3B — laptop pengembang individu
Model terkecil ditujukan untuk pengembang individu dan startup kecil. Model ini dapat dijalankan secara lokal melalui Ollama atau LM Studio, termasuk pada kuantisasi GGUF yang telah dipublikasikan hingga Q4_K_M. Ini skenario "pasang di laptop dan bereksperimen tanpa memikirkan tagihan API".
8B — satu GPU modern untuk satu tim
Ukuran menengah ditujukan untuk tim di segmen menengah: satu kartu grafis terkini sudah cukup untuk menjalankan model dalam lingkup operasional.
30B — lingkup korporat
Varian tertinggi membutuhkan daya selevel A100 atau H100, serta pemeliharaan dalam FP8 atau NVFP4 pada vLLM. Namun inilah kasus di mana model dapat ditempatkan di dalam perimeter dan data tidak perlu dikirim ke luar.
Industri yang secara eksplisit disasar IBM: pengembangan perangkat lunak dan alat untuk pengembang, layanan keuangan, kesehatan, telekomunikasi, sektor publik, dan pusat kontak — yang terakhir justru cocok untuk model suara baru. Skenario tipikalnya meliputi agen untuk menulis kode, otomatisasi terminal dan DevOps, riset dan pencarian mendalam, RAG atas dokumen panjang, pemanggilan alat terstruktur, dan transkripsi massal.
Arsitektur: transformer padat tanpa kejutan
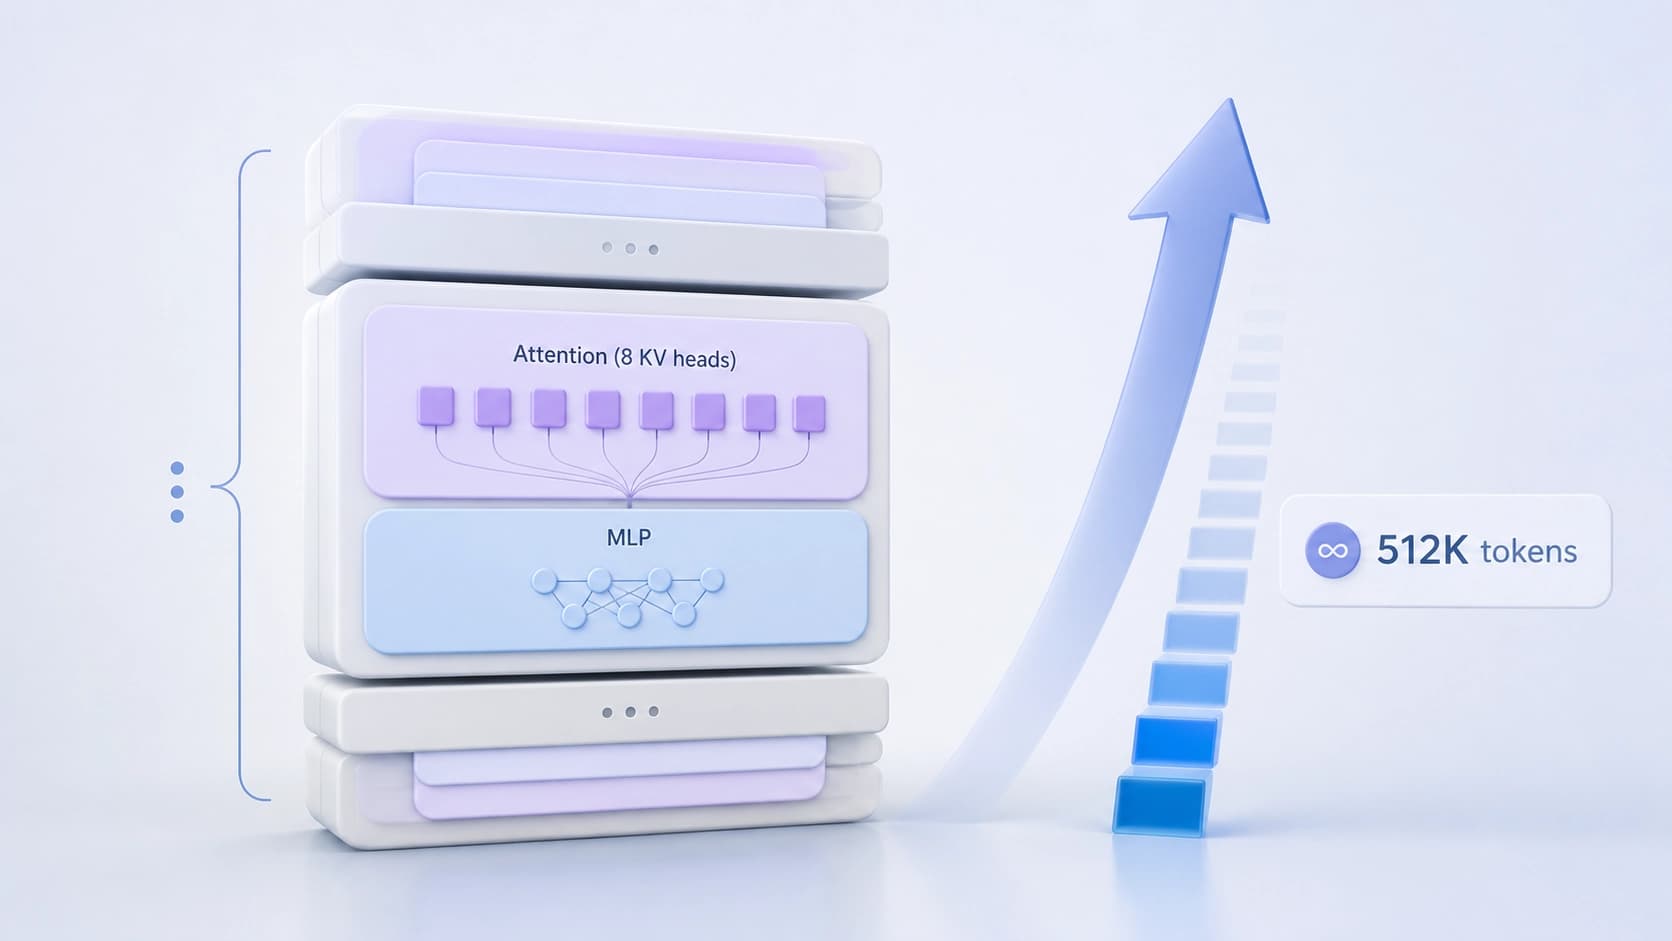
Granite 4.2 adalah transformer padat decoder-only. Tidak ada hibrida, tidak ada mixture-of-experts: taruhannya adalah pada prediktabilitas perilaku dan kesederhanaan penerapan, yang masuk akal untuk lingkup korporat.
Detail teknisnya:
- Grouped Query Attention dengan 8 KV-head;
- RoPE dengan θ = 10.000.000;
- SwiGLU pada MLP;
- RMSNorm dengan ε = 1e-5;
- embedding input dan output yang tidak terikat;
- presisi bfloat16.
Ukurannya berbeda sebagai berikut: pada 3B — 40 layer dan embedding 2560, pada 8B — 40 layer yang sama tetapi embedding 4096, pada 30B — 64 layer dan ukuran tersembunyi MLP 32.768.
Pada tabel arsitektur yang dipublikasikan tercantum panjang sekuens 131.072 token, yaitu 128K. Sementara itu, proses pra-pelatihan terdiri dari lima fase dan mencakup tahap konteks panjang hingga 512K token. Pelatihan dari awal berjalan pada sekitar 15 triliun token.
Pelatihan: SFT, lalu RL bertahap
Tahap supervised fine-tuning bersandar pada sekitar 7,2 juta sampel — sekitar 100 miliar token, dengan sekitar 65 miliar di antaranya dapat dilatih. Campuran datanya terdistribusi sebagai berikut: 31,6% contoh agentik berbanding 68,4% non-agentik, dengan rekayasa perangkat lunak menyumbang 69% dari bagian agentik.
Trajektori dikumpulkan dalam harness — di antaranya OpenHands, SWE-agent, Terminus-2, MiniSWE, Codex, dan Goose. Kualitasnya disaring dengan dua cara: GPT-OSS-120B dan Gemma 4 berperan sebagai juri, ditambah deduplikasi berbasis SHA-256 pada field tools dan messages.
Pasca-pelatihan bukan satu lintasan, melainkan rangkaian RL di beberapa lingkungan. Setiap tahap merupakan proses GRPO asinkron tersendiri yang di-warm-start dari checkpoint sebelumnya; alih-alih value-network digunakan baseline leave-one-out, dan importance sampling terpotong membatasi pergeseran dalam off-policy. Urutannya: pertama RLVR, lalu skill boosters, kemudian SWE, Terminal, dan Search, dan di akhir RLHF.
Di sinilah letak keterbatasan terpenting dari rilis ini: blok RL agentik hanya diterapkan pada 8B dan 30B. Model terkecil 3B hanya menjalani RL dasar dan penyelarasan — dan inilah yang sebagian besar menjelaskan kesenjangan kemampuan antar ukuran. Pelatihan dilakukan pada NeMo-RL dan NeMo-Gym di klaster NVIDIA GB200 NVL72 yang berlokasi di CoreWeave. Sebagai tambahan, ke dalam pipeline dimasukkan 1 triliun token kode sintetis dari CodeAlchemy dan lapisan speculative decoding untuk mempercepat penyajian.
Apa yang ditunjukkan metrik IBM
Angka-angka ini diklaim oleh IBM sendiri, jadi sebaiknya dibaca sebagai acuan, bukan sebagai verifikasi independen. Urutan nilainya — 3B / 8B / 30B:
- SWE-Bench Verified: untuk 3B tidak ada penilaian, pada 8B — 47.6, pada 30B — 57.00;
- Terminal-Bench 2.1: 20.56 dan 29.24;
- τ³-bench: 50.99 / 66.34 / 68.05;
- BFCL v4: 52.41 / 50.29 / 61.39;
- AIME25: 78.33 / 86.67 / 89.17;
- GPQA: 54.80 / 64.14 / 66.41;
- MMLU-Pro: 67.84 / 74.04 / 77.60;
- RULER 128K: 55.30 / 71.41 / 81.38.
Detail yang menarik — pada uji pemanggilan fungsi, 8B sedikit tertinggal dari 3B (50.29 berbanding 52.41). Ini menjadi pengingat bahwa ukuran saja tidak menjamin keunggulan pada setiap keterampilan tertentu, dan memilih model sesuai tugas lebih penting daripada mengejar checkpoint tertinggi.
Suara: 470 juta parameter tanpa backbone LLM
Granite Speech 5.0 Turbo CTC dirancang secara fundamental berbeda dari sistem ASR berbasis model bahasa pada umumnya: di sini tidak digunakan backbone LLM sama sekali, dan konversi audio ke teks dilakukan melalui connectionist temporal classification. Dari sinilah muncul kekompakannya — 470 juta parameter.
IBM mengklaim RTFx sekitar 12.600 pada satu H200, sementara pemimpin kecepatan saat ini di Open ASR leaderboard menunjukkan sekitar 6.000. Bagi pusat kontak dengan volume rekaman besar, perbedaan throughput ini langsung berkonversi menjadi uang. Model ini dapat dicoba dalam demonstrasi di WebGPU.
Kesimpulannya
IBM menyusun produk yang prediktif untuk pasar korporat: model padat tanpa keeksotisan arsitektural, lisensi terbuka, penerapan pada perangkat sendiri, dan mode penalaran untuk berbagai jenis tugas. Kemampuan agentik terpusat pada 8B dan 30B, sehingga 3B wajar dipandang sebagai titik masuk berbiaya rendah dan model untuk skenario sederhana, bukan sebagai "saudara kecil" tanpa kompromi. Detailnya sebaiknya diverifikasi melalui blog IBM Research, deskripsi teknis, dan repositori di GitHub, yang tautannya disertakan bersama rilis ini.