
Metode GoldiMask untuk fine-tuning model bahasa difusi: pemilihan konteks dan pembobotan target
Karya ini memperkenalkan GoldiMask—pendekatan supervised fine-tuning untuk model bahasa dengan difusi diskret, yang memilih token yang terlihat melalui maksimisasi aproksimatif fungsi submodular dan menetapkan bobot pada target yang tersisa berdasarkan kegunaannya dalam pelatihan. Eksperimen pada beberapa model dan dataset menunjukkan peningkatan akurasi rata-rata, peningkatan pada tugas penalaran dan pemrograman, serta lebih sedikit iterasi decoding paralel pada GSM8K dan MATH-500 dengan kualitas yang sebanding.
Masking Menentukan Dua Keputusan Sekaligus
Pelatihan lanjutan model bahasa difusi diskret bergantung pada pemulihan token yang dimasking. Sebagian token dalam jawaban ditutupi dengan mask, lalu model memprediksi nilai aslinya berdasarkan konteks yang terlihat.
Skema masking sekaligus menentukan dua hal. Skema ini menentukan konteks yang tersedia bagi model. Skema ini juga menentukan token mana yang menjadi target prediksi.
Kedua keputusan ini saling terkait: token yang dibuka tidak lagi menjadi target. Masking acak seragam tidak memperhitungkan keterkaitan ini. Akibatnya, sebagian token dibuka padahal hal itu tidak banyak membantu prediksi.
Metode GoldiMask dijelaskan dalam makalah Fine-Tuning Diffusion Language Models with Context Selection and Target Weighting (arXiv:2609.38385, 29 September 2026). Metode ini ditujukan untuk supervised fine-tuning model bahasa difusi diskret.
| Keputusan | Masking acak seragam | GoldiMask |
|---|---|---|
| Token mana yang dibuka sebagai konteks | pilihan acak | pemilihan berdasarkan fungsi objektif submodular |
| Bobot token target yang tersisa | tidak bergantung pada konteks yang dipilih | bergantung pada manfaat konteks dan potensi pembelajaran |
| Hubungan antara kedua keputusan | tidak diperhitungkan | diperhitungkan melalui sinyal model |
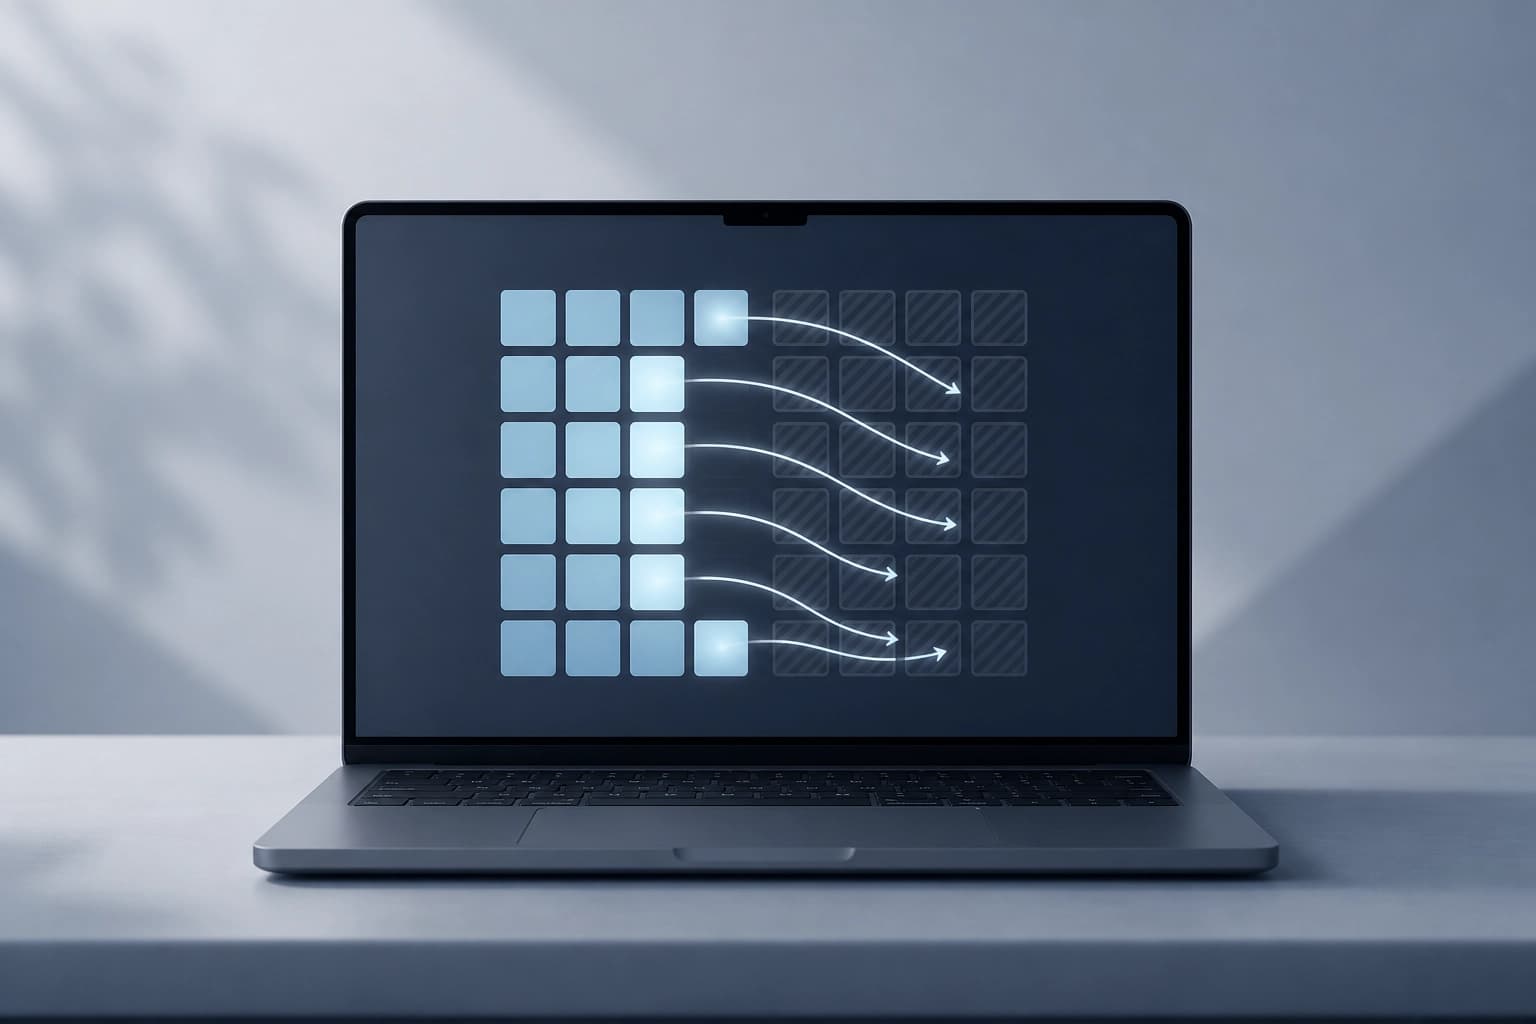
Kriteria: skema masking perlu dinilai sebagai satu keputusan terpadu tentang konteks dan target. Dengan begitu, terlihat kapan membuka token dapat dibenarkan dan kapan tidak.
Pemilihan konteks berdasarkan sinyal model
GoldiMask memilih token untuk dibuka sebagai konteks. Pemilihan ini secara aproksimatif memaksimalkan fungsi objektif submodular.
Metode ini menggunakan sinyal model dan menyeimbangkan dua hal:
- manfaat dari membuka token tertentu;
- nilai token tersebut sebagai target prediksi.
Token yang membantu memprediksi konteks sekitarnya sebaiknya dibuka. Token yang sulit diprediksi oleh model sebaiknya tetap dijadikan target.
Kriteria praktis: pemilihan konteks secara acak tidak menggunakan sinyal model. Jika skema seperti ini yang diterapkan, potensi pemilihan konteks tidak dimanfaatkan.
Pembobotan token target
Setelah konteks dipilih, sebagian token tetap menjadi target prediksi. GoldiMask memberikan bobot pada token-token tersebut dengan mempertimbangkan dua faktor:
- seberapa besar konteks yang dipilih membantu memprediksi token tertentu;
- seberapa besar potensi pembelajaran yang masih dimiliki token tersebut.
Dengan demikian, bobot mengaitkan target dengan keputusan tentang konteks yang telah dibuat. Pembobotan tidak menentukan token mana yang akan dibuka. Pembobotan menentukan kontribusi token yang tetap tertutup terhadap pelatihan.
Kriteria: saat menganalisis skema masking, ada baiknya memisahkan dua pertanyaan — apa yang perlu dibuka dan berapa bobot yang diberikan dalam pelatihan untuk token yang tersisa.
Hasil pada model dan kumpulan data
GoldiMask diuji pada tiga model dasar dan tiga kumpulan data pelatihan. Rata-rata akurasi metode ini menjadi yang tertinggi pada sebagian besar konfigurasi yang dievaluasi.
Peningkatan terlihat pada tugas penalaran dan pembuatan kode. Ablasi komponen menunjukkan bahwa kedua mekanisme berkontribusi terhadap peningkatan: pemilihan konteks dan pembobotan token target.
Kriteria praktis: akurasi tertinggi pada sebagian besar konfigurasi tidak berarti metode ini unggul pada setiap konfigurasi. Metode ini perlu diuji pada pasangan «model dasar + kumpulan data pelatihan» yang spesifik.
Dampak pada decoding paralel
Hasil terpisah berkaitan dengan decoding paralel yang menggunakan ambang batas keyakinan. Pada GSM8K dan MATH-500, GoldiMask mengurangi jumlah iterasi decoding.
Akurasi tetap sebanding pada ambang batas keyakinan yang lebih tinggi.
Kriteria praktis: jika pipeline menggunakan decoding paralel dengan ambang batas keyakinan, metode ini memengaruhi jumlah langkah decoding sekaligus akurasi. Penilaian berdasarkan akurasi saja tidak lengkap.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026