Hadiah yang dapat diverifikasi dan titik butanya
Pembelajaran penguatan berbasis hadiah yang dapat diverifikasi telah menjadi resep umum untuk model bahasa: ada tugas dengan jawaban yang dapat diverifikasi secara jelas — matematika, kode, pertanyaan dengan jawaban singkat — dan ada sinyal "berhasil / tidak berhasil". Skema ini berhasil, tetapi memiliki kelemahan yang sudah dikenal. Hadiah akhir menilai hasil secara keseluruhan, bukan jalannya. Model bisa mendapat nilai untuk kesimpulan yang benar yang dibangun di atas premis yang dibuat-buat, dan sebaliknya bisa kehilangan nilai untuk penalaran yang benar dengan perumusan akhir yang kurang tepat.
Di sinilah risiko halusinasi bersemayam. Jika hadiah hanya bergantung pada kecocokan akhir, kebijakan tidak memiliki insentif untuk berhati-hati di sepanjang jalan — cukup menebak jawabannya. Salah satu cara untuk memperbaikinya adalah menambahkan kontrol faktual di tingkat proses: memeriksa pernyataan-pernyataan antara, bukan hanya hasil akhirnya.
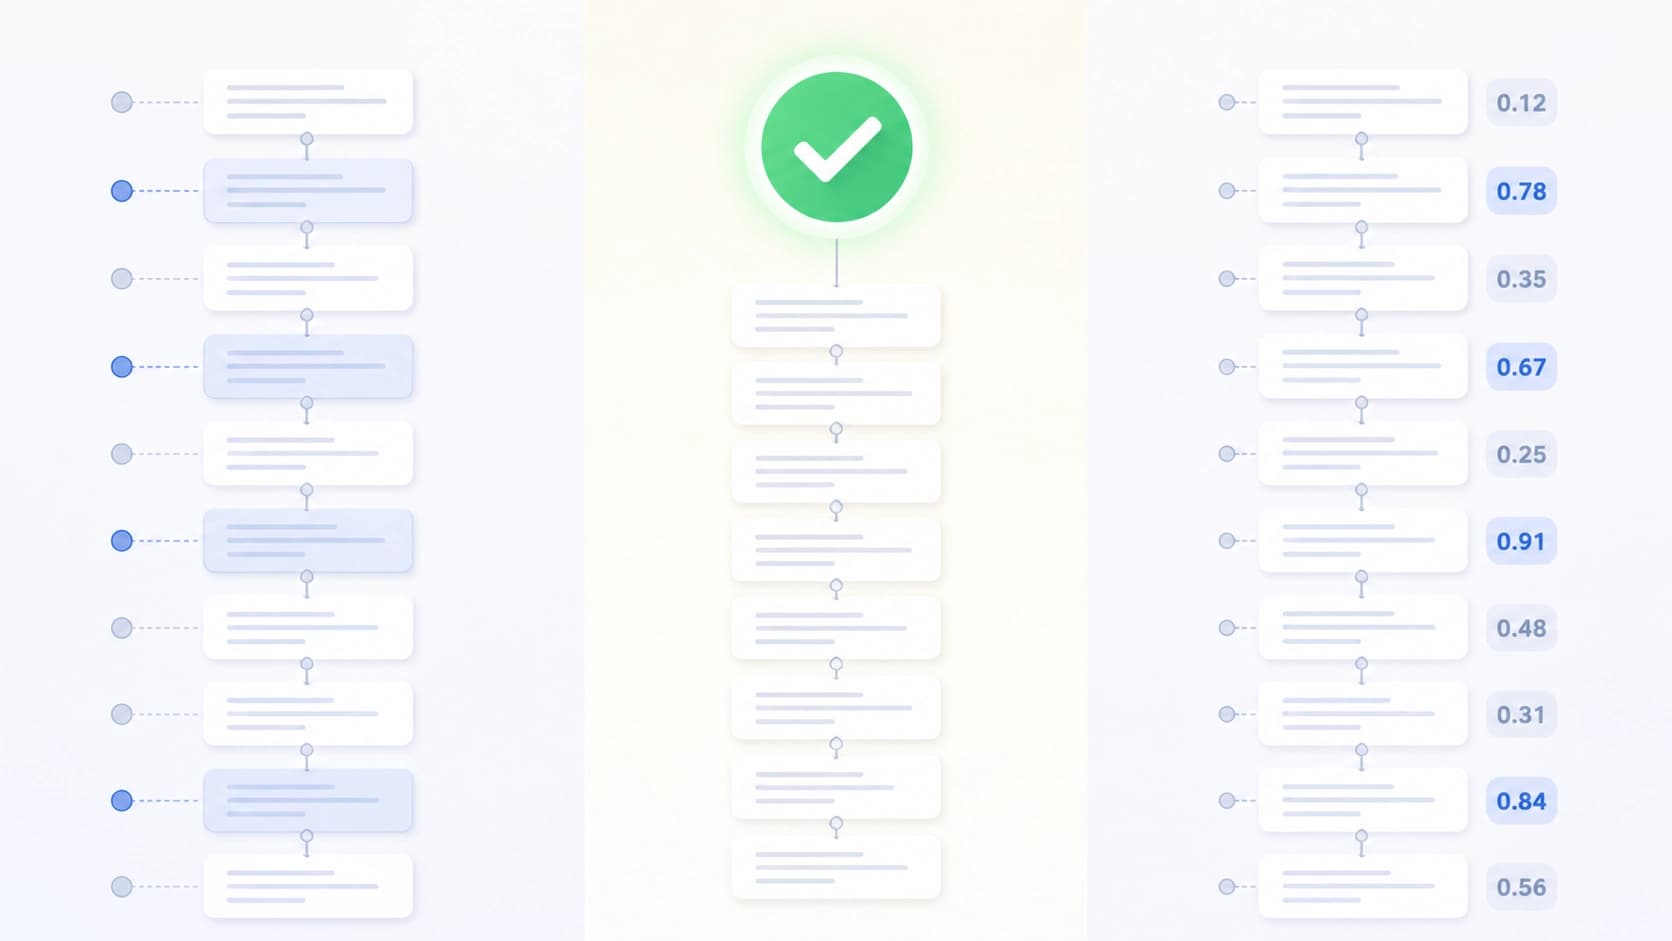
Namun pendekatan tingkat proses ini ternyata memiliki masalahnya sendiri. Pemeriksaan fakta dikumpulkan dan dirata-ratakan secara kasar: sinyal datang sebagai satu paket untuk seluruh fragmen, dan keandalan pemeriksaan itu sendiri tidak dinilai oleh siapa pun. Akibatnya, muncul celah antara apa yang benar-benar diperiksa dan apa yang benar-benar diperbarui dalam kebijakan.
Dua ambiguitas alih-alih satu masalah
Penulis karya arXiv:2608.24350 (Qiming Xie, Wenjie Zheng, Xiangqing Shen, Rui Xia) memberi nama pada celah ini — "penetapan kredit faktual yang berisik" (noisy factual credit assignment) — dan menguraikannya menjadi dua aspek yang independen.
- Ambiguitas lokalisasi kredit. Tidak jelas token atau fragmen mana yang harus diberi pujian atau kesalahan. Fakta diperiksa pada tingkat kalimat, sementara pembaruan terjadi pada tingkat token — granularitasnya tidak cocok, dan sinyalnya tersebar.
- Ambiguitas keandalan kredit. Tidak jelas seberapa besar pemeriksaan itu sendiri dapat dipercaya. Sebagian penilaian faktual andal dan dapat direproduksi, sebagian lagi rapuh, bergantung pada konteks atau perumusan tertentu. Tanpa bobot kepercayaan, semuanya masuk ke dalam pelatihan dengan hak yang sama.
Aspek kedua adalah yang paling diremehkan. Skema biasa dalam menangani sinyal faktual berperilaku seolah-olah semua pemeriksaan memiliki kualitas yang sama. Dalam praktiknya tidak demikian, dan pemeriksaan yang lemah mulai merusak optimisasi setara dengan yang kuat.
Bagaimana FARCA dirancang
FARCA adalah singkatan dari Fact-Aligned Reliability-Aware Credit Assignment — penetapan kredit yang selaras dengan fakta dan sadar akan keandalannya. Ini bukan model baru dan bukan dataset, melainkan kerangka kerja optimisasi kebijakan: ia merombak cara kontrol faktual diubah menjadi sinyal pelatihan.
Menyelaraskan granularitas
Langkah pertama adalah lokalisasi kredit berbutir halus. Idenya sederhana secara perumusan dan tidak sepele dalam implementasi: granularitas pemeriksaan fakta perlu diselaraskan dengan granularitas pembaruan kebijakan. Dengan begitu, sinyal faktual tidak datang "sebagai rata-rata untuk seluruh jawaban", melainkan dikaitkan dengan token-token tertentu yang benar-benar bertanggung jawab atas pernyataan tersebut. Alih-alih perata-rataan yang kabur, kebijakan menerima petunjuk yang tepat sasaran.
Menilai seberapa besar pemeriksaan dapat dipercaya
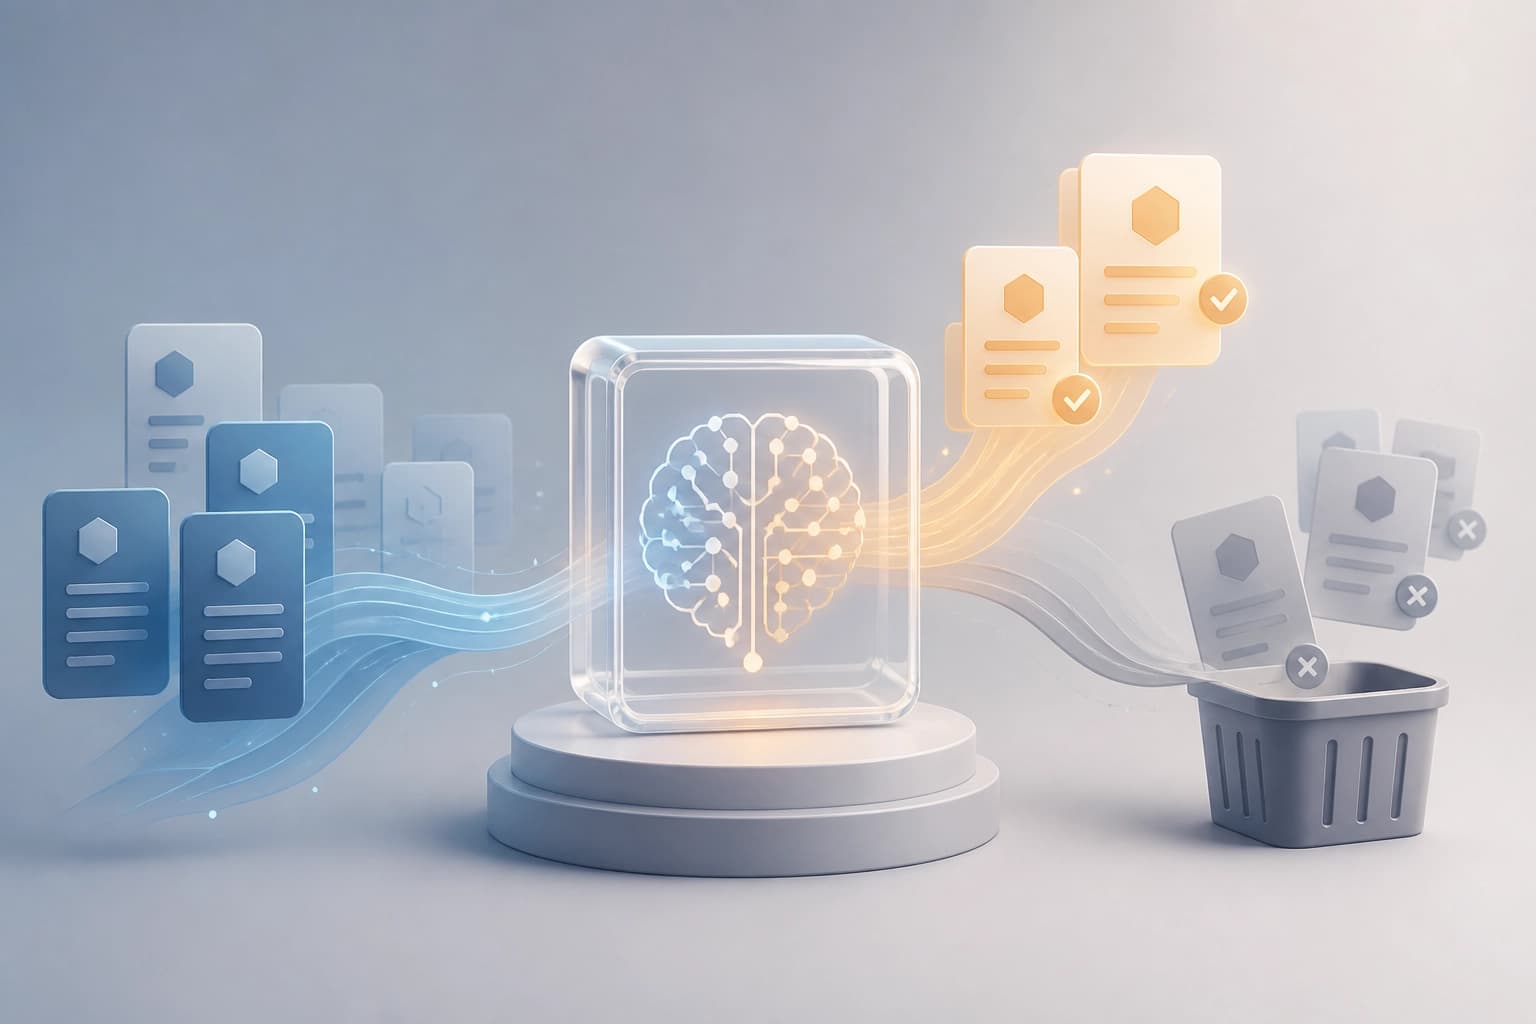
Langkah kedua adalah bobot keandalan. Untuk menghitungnya, penulis memperkenalkan atribusi bukti kontrafaktual (counterfactual evidence attribution): mereka melihat seberapa besar penilaian faktual bergantung pada fragmen bukti kunci. Jika bukti ini dihapus atau diganti dan putusannya berubah — berarti pemeriksaan itu benar-benar bersandar padanya, dan sinyal semacam itu layak mendapat kepercayaan lebih besar. Jika putusannya tetap sama terlepas dari buktinya, penilaian itu kemungkinan besar bukan tentang apa yang kita pikirkan — dan bobotnya turun.
Bobot yang diperoleh kemudian memodulasi hadiah faktual dan keunggulan lokal kebijakan. Makna praktisnya: sinyal yang berpotensi tidak andal mendapat suara yang lebih kecil saat pembaruan, bukan diblokir sepenuhnya. Ini adalah penyaringan lunak alih-alih penyaringan keras — kebijakan tidak kehilangan informasi, tetapi berhenti mengikutinya secara membabi buta.
Apa yang ditunjukkan eksperimen
Penulis menguji pendekatan ini pada berbagai model dan beberapa benchmark yang menilai penalaran faktual. Hasil yang diklaim adalah peningkatan faktualitas yang signifikan sambil mempertahankan kemampuan penalaran umum. Bagian terakhir ini sama pentingnya dengan yang pertama: peningkatan faktualitas sering kali dibeli dengan harga degradasi keterampilan lain, ketika model menjadi lebih hati-hati sekaligus lebih lemah. Menurut data penulis, hal itu tidak terjadi di sini.
Perlu dicatat secara khusus bahwa metode ini tetap berada dalam paradigma RL dengan hadiah yang dapat diverifikasi — ia tidak menuntut untuk meninggalkan pipeline yang ada dan tidak menggantinya dengan sesuatu yang secara fundamental berbeda. Ia terpasang sebagai lapisan antara pemeriksaan fakta dan pembaruan kebijakan.
Apa implikasinya
Gagasan utama karya ini lebih luas dari satu arsitektur. Diskusi tentang faktualitas model biasanya berlangsung dalam logika "memeriksa atau tidak memeriksa". Tetapi ketika pemeriksaan sudah ada, pertanyaan kuncinya bergeser: bagaimana tepatnya hasilnya diubah menjadi pelatihan. Kesalahan pada persimpangan ini tidak terlihat seperti kesalahan, ia terlihat seperti kebisingan pelatihan biasa — dan karena itu mudah luput dari perhatian.
Mengakui bahwa sumber tidak dipercaya secara setara tampaknya hampir sepele pada tingkat akal sehat. Tetapi dalam skema pembelajaran penguatan, hal ini masih jarang: sinyal-sinyal digabungkan ke dalam satu kuali, dan perbedaan antara bukti yang andal dan tebakan acak terhapus. FARCA adalah upaya untuk mengembalikan perbedaan itu ke dalam rumus. Seberapa jauh pendekatan ini dapat ditransfer ke luar tugas-tugas dengan jawaban yang dapat diverifikasi, di mana fakta tidak dapat begitu saja dikonfirmasi atau dibantah, adalah pertanyaan terbuka — dan sekaligus arah paling menarik untuk karya selanjutnya.