Mengapa LLM keliru saat observasi tidak lengkap
Penulis mengaitkan kesalahan agen LLM di lingkungan yang hanya teramati sebagian dengan tidak adanya distribusi keyakinan yang eksplisit mengenai keadaan tersembunyi. Biasanya, agen bertindak sebagai kebijakan yang dikondisikan pada riwayat tindakan dan observasi.
Artikel ini menjelaskan tiga kesalahan yang umum terjadi:
- mengambil keputusan terlalu dini saat menerima umpan balik yang ambigu;
- bias terhadap hipotesis yang keliru setelah observasi yang informatif;
- pergeseran kebijakan seiring bertambahnya riwayat.
Masalahnya bukan hanya kualitas jawaban untuk satu permintaan. Agen tidak memiliki representasi eksplisit tentang keadaan tersembunyi apa yang dianggap mungkin.
Cara kerja loop Bayesian eksternal
Belief-State Engine (BSE) adalah modul inferensi yang berada di luar LLM. Modul ini mempertahankan distribusi posterior Bayesian atas keadaan tersembunyi dalam model POMDP tertentu—proses keputusan Markov yang hanya teramati sebagian.
Pada setiap langkah, loop ini bekerja sebagai berikut:
- BSE memperbarui distribusi keyakinan atas keadaan tersembunyi.
- LLM hanya menerima distribusi tersebut.
- Log asli tindakan dan observasi tidak dapat diakses oleh LLM.
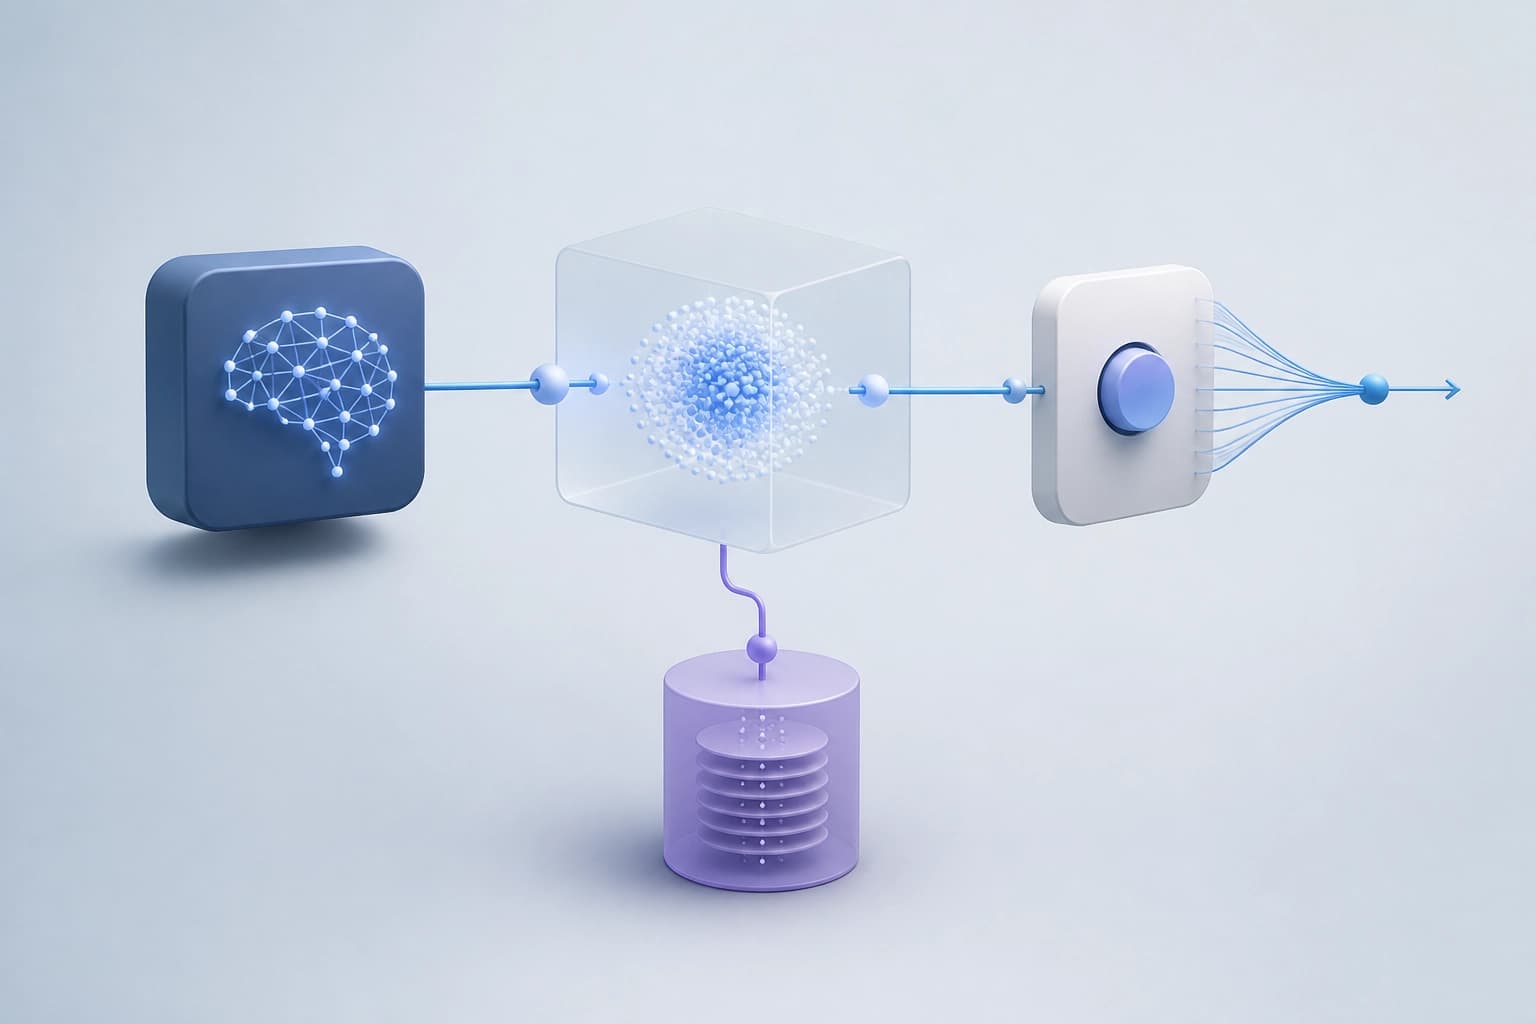
Pendekatan ini memisahkan penanganan ketidakpastian dari model bahasa. Syarat utama arsitekturnya adalah LLM tidak menerima riwayat asli.
Jaminan yang bergantung pada arsitektur
Penulis menetapkan spesifikasi minimal yang terdiri atas empat aksioma untuk keadaan internal yang konsisten dengan keyakinan. Isi aksioma tersebut tidak dijelaskan di sini.
Penulis membuktikan bahwa kombinasi LLM dan BSE membentuk kebijakan Markov yang valid pada belief MDP yang diinduksi oleh POMDP asli. Dengan syarat LLM tidak pernah memperoleh akses ke riwayat asli, kombinasi ini mewarisi jaminan optimalitas Bellman dari teori POMDP klasik.
Kriteria praktis: jaminan ini berlaku untuk kombinasi yang dijelaskan dan bergantung pada pembatasan akses ke riwayat. Jaminan tersebut tidak dapat dipisahkan dari persyaratan arsitektur.
Hasil evaluasi
Arsitektur ini diuji pada Tiger POMDP dan tugas attack-graph red-team. Perbandingan mencakup enam metode dasar.
| Metode dasar | Hasil BSE di kedua bidang |
|---|---|
| Reactive LLM | Task return lebih tinggi, kalibrasi keyakinan lebih baik, dan keputusan lebih konsisten |
| Chain-of-Thought | Task return lebih tinggi, kalibrasi keyakinan lebih baik, dan keputusan lebih konsisten |
| ReAct | Task return lebih tinggi, kalibrasi keyakinan lebih baik, dan keputusan lebih konsisten |
| Pelacak keyakinan bahasa alami | Task return lebih tinggi, kalibrasi keyakinan lebih baik, dan keputusan lebih konsisten |
| QMDP | Task return lebih tinggi, kalibrasi keyakinan lebih baik, dan keputusan lebih konsisten |
| POMCP | Task return lebih tinggi, kalibrasi keyakinan lebih baik, dan keputusan lebih konsisten |
Abstraknya juga menyatakan bahwa efeknya tidak spesifik pada satu model. Sepuluh ablasi terarah dirancang untuk mengisolasi kontribusi tiap keputusan arsitektur.
Kapan pendekatan ini layak dipertimbangkan
BSE mendukung distribusi atas keadaan tersembunyi dalam POMDP tertentu. Karena itu, deskripsi tugas dalam kerangka model semacam ini merupakan kriteria utama untuk menerapkan pendekatan tersebut.
Evaluasi dalam artikel ini mencakup dua bidang yang disebutkan. Evaluasi tersebut tidak membuktikan bahwa hasilnya dapat diterapkan pada semua tugas dengan data yang tidak lengkap.
Materi yang tersedia untuk diperiksa
Preprint Belief-State Engine: Augmenting LLMs for Principled Planning Under Partial Observability menyertakan kode, spesifikasi lingkungan, templat prompt, dan log seed.
Artikel karya Arnab Chattopadhayay dan Debdipta Halder diajukan ke arXiv pada 9 September 2026. Kesimpulan praktisnya perlu dinilai dengan mempertimbangkan lingkungan, perbandingan, dan persyaratan akses LLM ke riwayat yang dijelaskan.