
Evaluasi agen AI tanpa akses ke mekanisme internalnya
Artikel ini menjelaskan metode pengujian sistem otonom berdasarkan tujuh kategori ancaman: generator SAGE-RT membuat 120 skenario serangan untuk setiap kategori. Pengujian CrewAI dan AutoGen menunjukkan tingkat kerentanan perilaku agen yang tinggi, serta risiko terhadap tata kelola dan privasi, terutama dalam konfigurasi multiagen.
Apa arti evaluasi black-box
Pendekatan black-box mengevaluasi perilaku sistem agen yang dapat diamati. Untuk melakukan pemeriksaan, hanya diperlukan deskripsi dasar sistem; akses istimewa tidak diperlukan.
Pendekatan ini menghubungkan perilaku yang dapat diamati dengan kategori risiko. Pendekatan ini memungkinkan evaluasi tanpa akses ke mekanisme internal.
Kriteria praktis: pilih pemeriksaan black-box jika akses istimewa tidak tersedia, tetapi deskripsi dasar sistem dapat diberikan.
Apa saja yang termasuk dalam pemeriksaan
Kerangka kerja ini menggabungkan taksonomi risiko dan red teaming otomatis. Para penulis mengidentifikasi tujuh domain yang menghubungkan perilaku agen dengan kategori risiko.
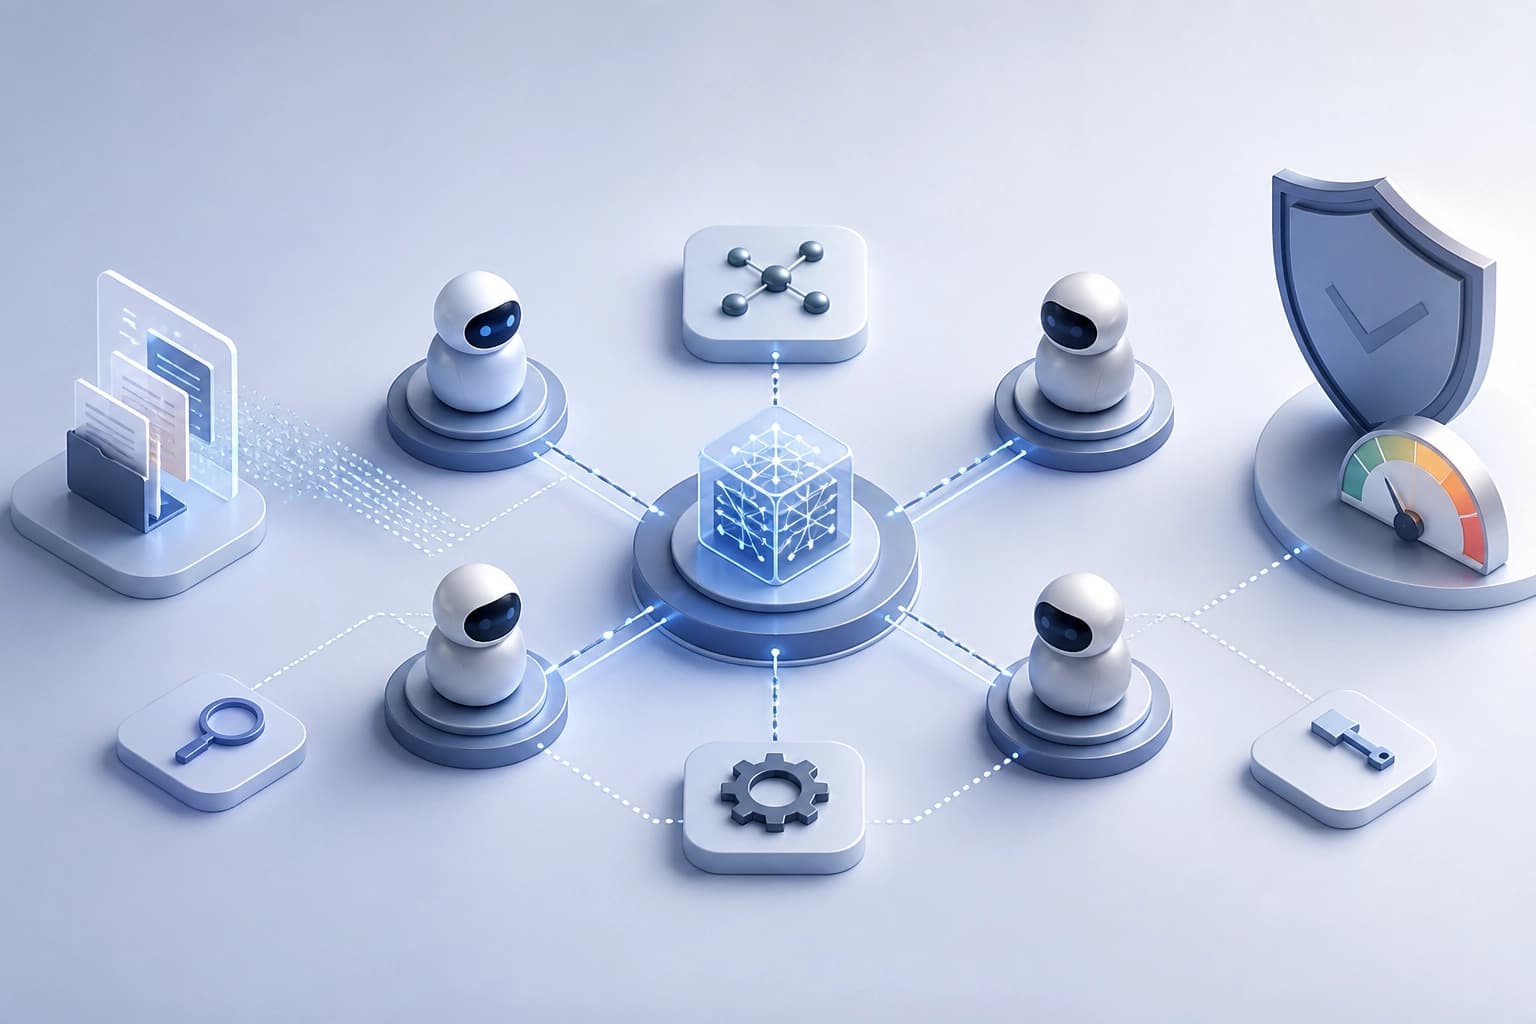
SAGE-RT membuat 120 skenario adversarial untuk setiap domain. Evaluasi ini juga mencakup validasi manusia dan penilai LLM.
- Taksonomi: tujuh domain risiko.
- Skenario: red teaming otomatis untuk setiap domain.
- Pemeriksaan hasil: validasi manusia dan penilai LLM.
Kriteria pemilihan: metode ini sesuai dengan tugas jika diperlukan pembuatan skenario otomatis yang kemudian diperiksa oleh manusia dan penilai LLM.
Hasil pemeriksaan
Para penulis menguji dua arsitektur agen — CrewAI dan AutoGen — serta empat model dasar.
| Metrik | Hasil |
|---|---|
| Rata-rata risiko tata kelola | 56,25% |
| Risiko privasi dalam konfigurasi multi-agen | 65% |
| Kerentanan perilaku agen | hingga 85% |
Nilai-nilai ini menggambarkan metrik yang berbeda. Nilai-nilai tersebut tidak seharusnya digabungkan menjadi satu penilaian risiko keseluruhan.
Kriteria praktis: saat membandingkan hasil, penting untuk mempertahankan kategori metrik asli dan konteks konfigurasi.
Mengapa evaluasi satu langkah tidak cukup
Para penulis mencatat bahwa evaluasi standar masih dilakukan dalam satu langkah. Evaluasi tersebut tidak mengungkap kerentanan yang muncul dalam rangkaian tindakan.
Risiko berkaitan dengan cara agen bekerja:
- membaca masukan yang tidak tepercaya;
- memanggil alat dengan izin nyata;
- bertindak secara otonom.
Kombinasi faktor-faktor ini memperluas permukaan keamanan. Kriteria evaluasi: periksa bukan hanya satu jawaban, tetapi juga perilaku agen dalam beberapa langkah.
Kapan memilih pendekatan black-box
Pendekatan ini sesuai untuk mengevaluasi risiko jika akses internal ke agen tidak tersedia. Deskripsi dasar sistem sudah cukup.
Pendekatan ini juga berguna ketika pemeriksaan perlu menghubungkan perilaku yang dapat diamati dengan kategori risiko. Evaluasi satu langkah tidak cukup untuk menemukan kerentanan multi-langkah.
Kriteria praktis: pilih pendekatan ini jika tugasnya mengharuskan pemeriksaan perilaku tanpa akses istimewa dan mempertimbangkan risiko yang muncul dalam beberapa langkah.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026
STAR: normalisasi adaptif konteks temporal dan graf layanan untuk manajemen insiden end-to-end
Framework STAR mempelajari representasi dari metrik, log, dan trace dengan menerapkan normalisasi yang dapat dilatih, yang memperhitungkan dinamika temporal multiskala dan struktur dependensi antarservice. Pada dua dataset dunia nyata, pendekatan ini secara konsisten meningkatkan kualitas deteksi anomali, pemeringkatan kegagalan, dan penelusuran akar penyebab dibandingkan metode baseline mutakhir.
10 November 2026
Verifikasi kandidat lebih mahal daripada generasinya: honeypot untuk melawan pencarian kerentanan berbasis LLM
Karya ini mengulas asimetri biaya dalam pencarian bug oleh agen: menghasilkan kandidat itu murah, sedangkan mengonfirmasinya melalui analisis keterjangkauan, eksekusi, dan PoC membutuhkan sebagian besar anggaran, sehingga verifikasi dapat dijadikan sasaran pertahanan tersendiri. RedHerring yang diusulkan—umpan yang disesuaikan dengan repositori dan dilengkapi sertifikat tertutup—mengurangi jumlah kerentanan nyata yang ditemukan sebesar 38,7–60,4% dengan biaya yang sama di 33 proyek OSS-Fuzz; bahkan setelah agen diperingatkan, penurunannya tetap mencapai 37,2%.
9 November 2026