
Slide gigapiksel vs model "penglihatan-bahasa": apa yang diungkap benchmark baru EviPathBench
Peneliti dari kelompok Dankai Liao memperkenalkan EviPathBench — kumpulan tugas yang menguji bukan jawaban siap pakai model patologi, melainkan proses pencarian bukti pada slide secara keseluruhan. Ternyata, VLM jauh lebih mampu bernalar berdasarkan data yang telah disiapkan sebelumnya dibandingkan menemukan sendiri area yang relevan: akurasi lokalisasi zona diagnostik dan pencarian otonom menurun tajam seiring bertambahnya perbesaran.
Masalah: model diuji di tempat yang tidak perlu dicari lagi
Slide histologi adalah citra gigapiksel. Untuk menegakkan diagnosis, ahli patologi pertama-tama mengamati sediaan pada perbesaran rendah, menangkap area yang mencurigakan, lalu mengamatinya dari dekat, membandingkan gambaran pada berbagai skala, dan baru kemudian merumuskan kesimpulan. Sebagian besar pekerjaan ini bukan untuk mengamati, melainkan untuk mencari: ke mana sebenarnya harus dilihat.
Sebagian besar benchmark yang ada untuk AI patologi mengambil bagian pekerjaan ini dari model. Input yang diberikan berupa patch yang sudah dipotong sebelumnya, atau fitur slide yang sudah diekstraksi — artinya pihak lain sudah menentukan sebelumnya apa yang penting di sini. Model menerima bukti yang sudah siap dan menunjukkan kemampuan bernalar berdasarkan bukti tersebut. Namun seberapa baik model mengumpulkan bukti sendiri — hampir tidak teruji.
Justru pada celah inilah karya EviPathBench diarahkan. Para penulisnya adalah Dankai Liao, Tianyi Zhang, Yufeng Wu, Xinyue Zhang, Qiaochu Xue, Zeyu Liu, Dachun Zhao, Linghan Cai, dan Yueming Jin; pracetak muncul di arXiv pada 21 Juli 2026, dan pada 25 Agustus sudah mencapai versi keempat (arXiv:2607.19261, cs.CV / cs.AI). Frekuensi revisi seperti ini sendiri memberi petunjuk: para penulis menganggap topik ini masih hidup dan diperdebatkan.
Bagaimana benchmark ini disusun
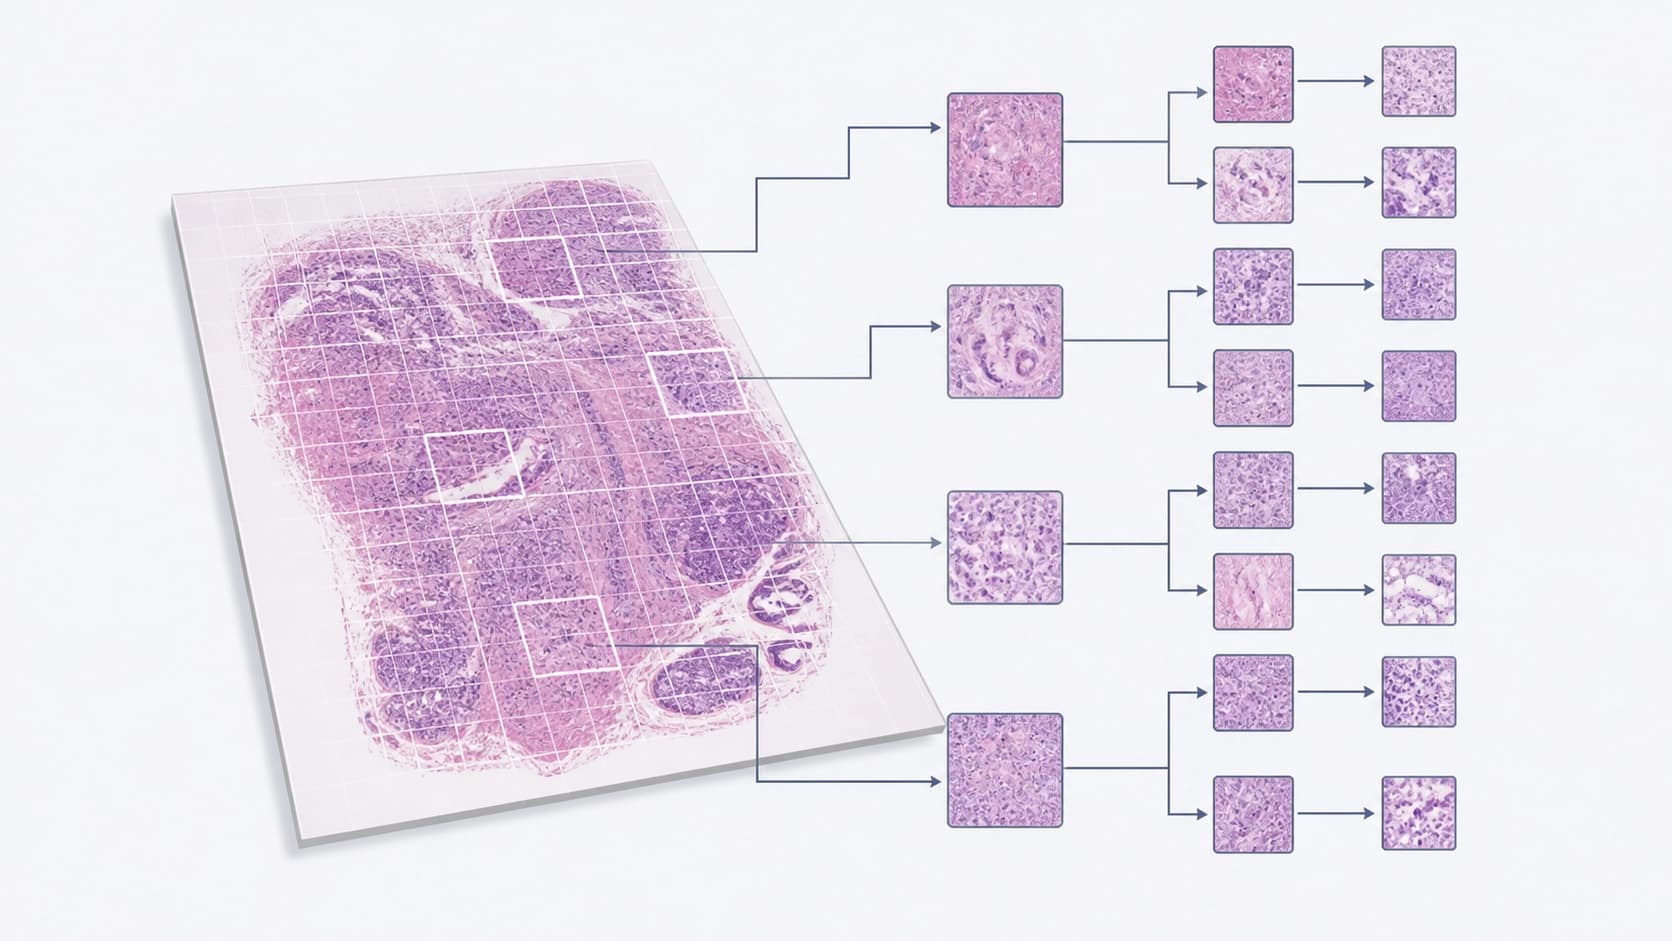
EviPathBench dibangun bukan sebagai kumpulan pertanyaan terpisah dengan pilihan jawaban, melainkan sebagai pohon diagnostik. Area yang saling bersarang pada berbagai perbesaran dihubungkan dengan temuan yang spesifik untuk skala tertentu, dan pada akhirnya — dengan diagnosis tingkat kesimpulan patologis. Model dituntut tidak sekadar memberikan label "kanker", tetapi menempuh rantai: menemukan area, mendeskripsikan temuan pada perbesaran ini, naik ke tingkat yang lebih tinggi, menyelaraskan data antar skala, dan menyatukannya menjadi kesimpulan umum.
Empat kemampuan yang diuji
Para penulis menguraikan keterampilan bekerja dengan slide menjadi komponen-komponen dan menilai masing-masing secara terpisah:
- Pencocokan citra dengan teks — interpretasi bukti, ketika model menghubungkan apa yang dilihat dengan deskripsi.
- Kueri teks ke citra (retrieval) — verifikasi: berdasarkan rumusan, perlu menemukan fragmen yang sesuai dalam slide.
- Lokalisasi area diagnostik — inti dari pengumpulan bukti: di mana tepatnya harus dicari.
- Penalaran lintas tingkat — integrasi temuan yang diperoleh pada berbagai perbesaran menjadi satu gambaran utuh.
Pembagian seperti ini berharga dengan sendirinya: ini menunjukkan bahwa "pemahaman slide" bukanlah satu kemampuan, melainkan beberapa, dan bisa sangat berbeda satu sama lain.
Data dan anotasi
Dasar utamanya terdiri dari 1.822 WSI dari TCGA dan 17.135 jalur diagnostik, yang dianotasi oleh sepuluh ahli patologi bersertifikat. Secara terpisah digunakan kohort privat dari 190 slide kanker payudara dengan anotasi terperinci — ini diperlukan untuk menguji secara khusus penelusuran otonom seluruh sediaan, tanpa petunjuk tentang di mana area yang dimaksud berada.
Hasil: bernalar bisa, mencari — tidak
Evaluasi melibatkan 19 model "visi-bahasa" — umum, medis, dan patologi khusus — plus satu model teks referensi, yang diperlukan sebagai titik acuan.
Gambarannya kontras. Model terbuka terbaik melampaui 93% akurasi dalam penalaran lintas tingkat dan lebih dari 50% — dalam kedua tugas pencocokan lintas modal. Sekilas, semuanya baik-baik saja.
Namun untuk lokalisasi area diagnostik — masalah. Hasil terbaik untuk text-guided mean IoU bahkan tidak mencapai 0,09. Ini lebih buruk daripada heuristik sederhana yang menempatkan persegi panjang di tengah slide, tanpa menganalisis apa pun. Dengan kata lain, model yang dilatih untuk mengamati jaringan mencari lebih buruk daripada program yang tidak melihat ke mana pun.
Skala merusak pencarian
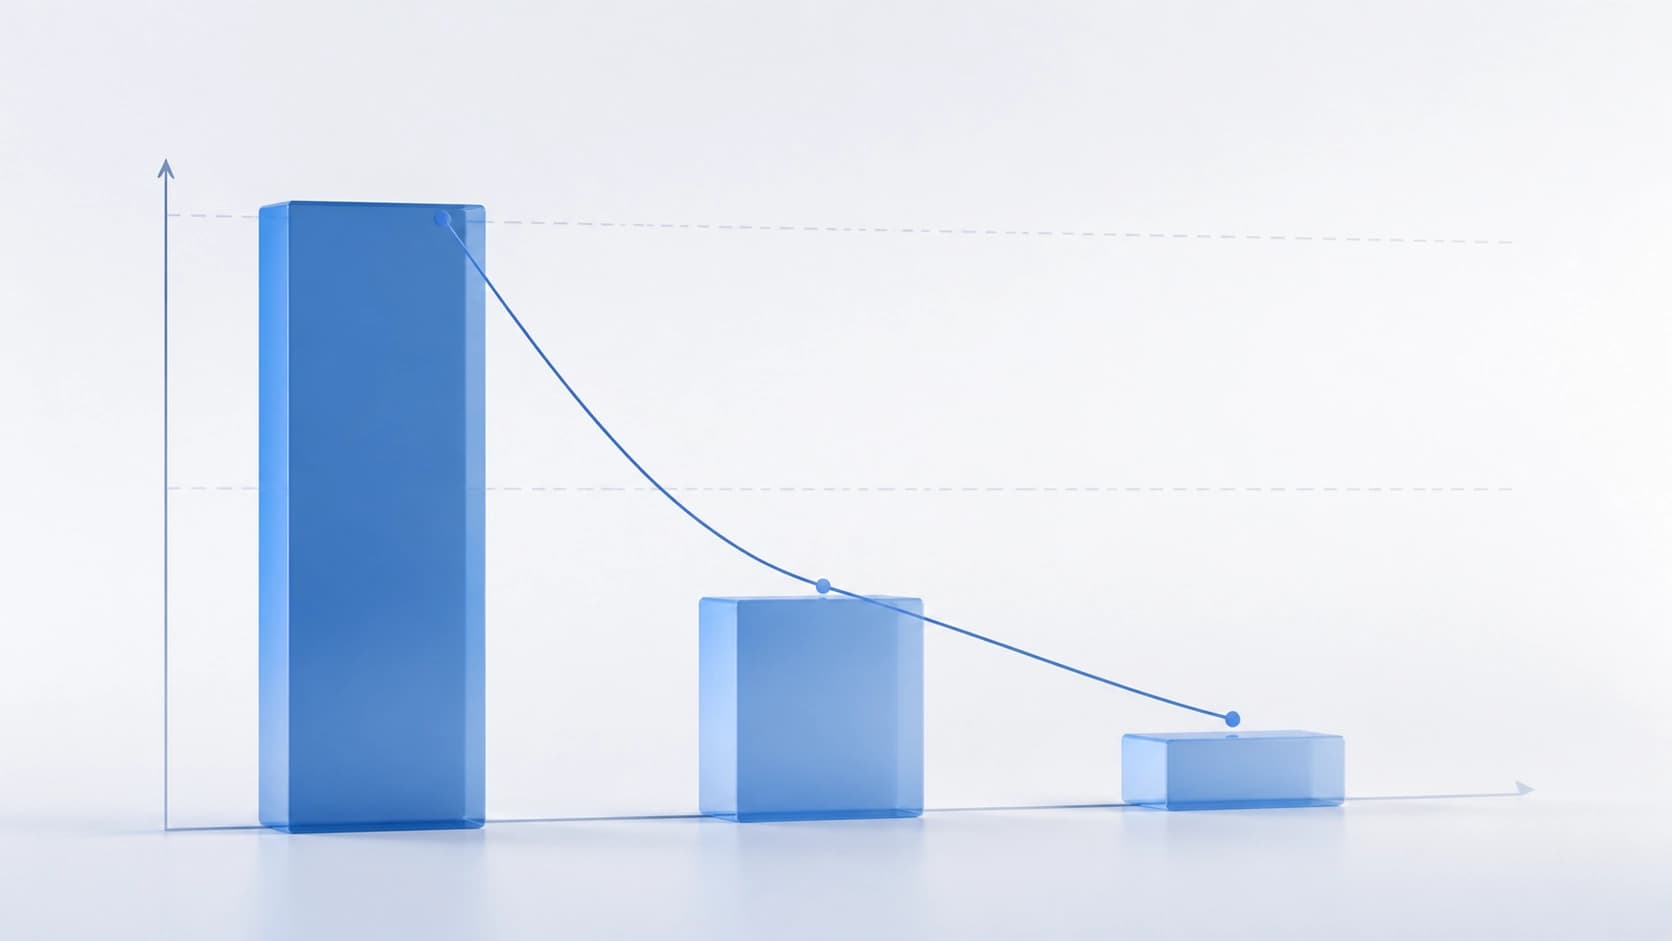
Lini eksperimen terpisah adalah penelusuran slide secara otonom. Di sini unconditional hit rate merosot seiring bertambahnya perbesaran: 0,522 pada perbesaran rendah, 0,185 pada sedang, dan 0,020 pada tinggi. Logika penurunannya jelas: pada perbesaran rendah model melihat arsitektur jaringan secara umum dan mudah mengenai "suatu tempat di zona yang benar", tetapi semakin kuat zoom, semakin sempit bidang pandang dan semakin mahal setiap kesalahan pada langkah sebelumnya. Kesalahan menumpuk, dan pada perbesaran maksimum model hampir pasti melihat ke tempat yang salah.
Apa yang bisa disimpulkan
Kesimpulan utama karya ini dirumuskan secara sederhana: antara kemampuan bernalar berdasarkan bukti yang telah disiapkan dan kemampuan mengumpulkan bukti tersebut terdapat jurang yang dalam. Yang pertama sudah cukup baik pada model modern, yang kedua — hampir tidak berhasil.
Untuk praktik, ini berarti navigasi slide untuk sementara tidak bisa diserahkan sepenuhnya kepada model dan mengharapkan hasil yang bermakna secara klinis. Namun benchmark ini sendiri menyediakan kerangka umum: dengannya kita dapat mengukur kedua kemampuan dan melihat apakah peningkatan tertentu — pembelajaran penguatan, memori antar langkah zoom, pencarian hierarkis — membantu kemajuan pada bagian yang gagal.
Perlu juga diingat beberapa catatan. Kohort privat terbatas pada kanker payudara, dan sebagian besar data adalah materi retrospektif TCGA, sehingga variabilitas klinis nyata tidak sepenuhnya terwakili di sana. Metrik lokalisasi sensitif terhadap bagaimana batas area dianotasi, dan empat versi pracetak dalam sebulan menunjukkan bahwa angka-angkanya masih bisa berubah.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
OpenCollab: koordinasi agen yang dapat diprogram, lingkungan eksekusi terkontrol, dan metrik kepatuhan terhadap kebijakan
Framework ini menyatukan penetapan struktur interaksi agen, lingkungan eksperimen bersama, dan pelacakan peristiwa yang terperinci, sementara metrik Adherence yang diperkenalkan menunjukkan sejauh mana pelaksanaan aktual sesuai dengan skema yang dinyatakan. Dalam benchmark, konfigurasi Duo mencapai tingkat SOTA baru, sedangkan varian agen tunggal memiliki konsumsi token terendah.
11 November 2026
Toollery: memilih alat untuk agen LLM dari puluhan ribu opsi tanpa fine-tuning
Toollery membangun indeks pencarian berdasarkan deskripsi keterampilan dan alat, lalu saat ada permintaan hanya meneruskan sekumpulan kandidat terbatas ke model. Dalam eksperimen pada pustaka berskala hingga puluhan ribu fungsi, pendekatan ini mampu mempertahankan kualitas pemilihan dengan top-K tetap, meskipun dampak akhirnya bergantung pada profil beban dan caching di penyedia.
11 November 2026
Diagnostik bertahap agen GUI dalam analisis dasbor: benchmark DashAct
DashAct diperkenalkan sebagai tolok ukur yang terdiri atas 348 trajektori yang diverifikasi manusia, yang menguraikan kerja agen GUI dengan panel interaktif menjadi tiga tahap dan empat kondisi visual. Hasilnya menunjukkan masalah yang terus berulang dalam memprediksi tindakan dan mengaitkannya dengan target visual, serta ketergantungan respons agen pada dukungan kontekstual dan spasial.
11 November 2026