
Metode CHOIR: enumerasi bebas mengungkap perbedaan posisi model di dalam sistem kolektif
Para penulis mengusulkan pendekatan CHOIR, di mana berbagai kelompok model berulang kali diminta menghasilkan daftar jawaban berperingkat, lalu membandingkan tingkat kemunculan konsep yang digabungkan di antara model, formulasi prompt, dan kondisi peran. Penelitian ini menunjukkan bahwa kemiripan eksternal yang tinggi pada jawaban terbuka belum tentu menandakan kesepahaman: identitas model dasar tetap menjadi pembeda yang paling konsisten, sementara pengaturan persona menggeser konsep yang ditampilkan.
Apa yang ditawarkan CHOIR
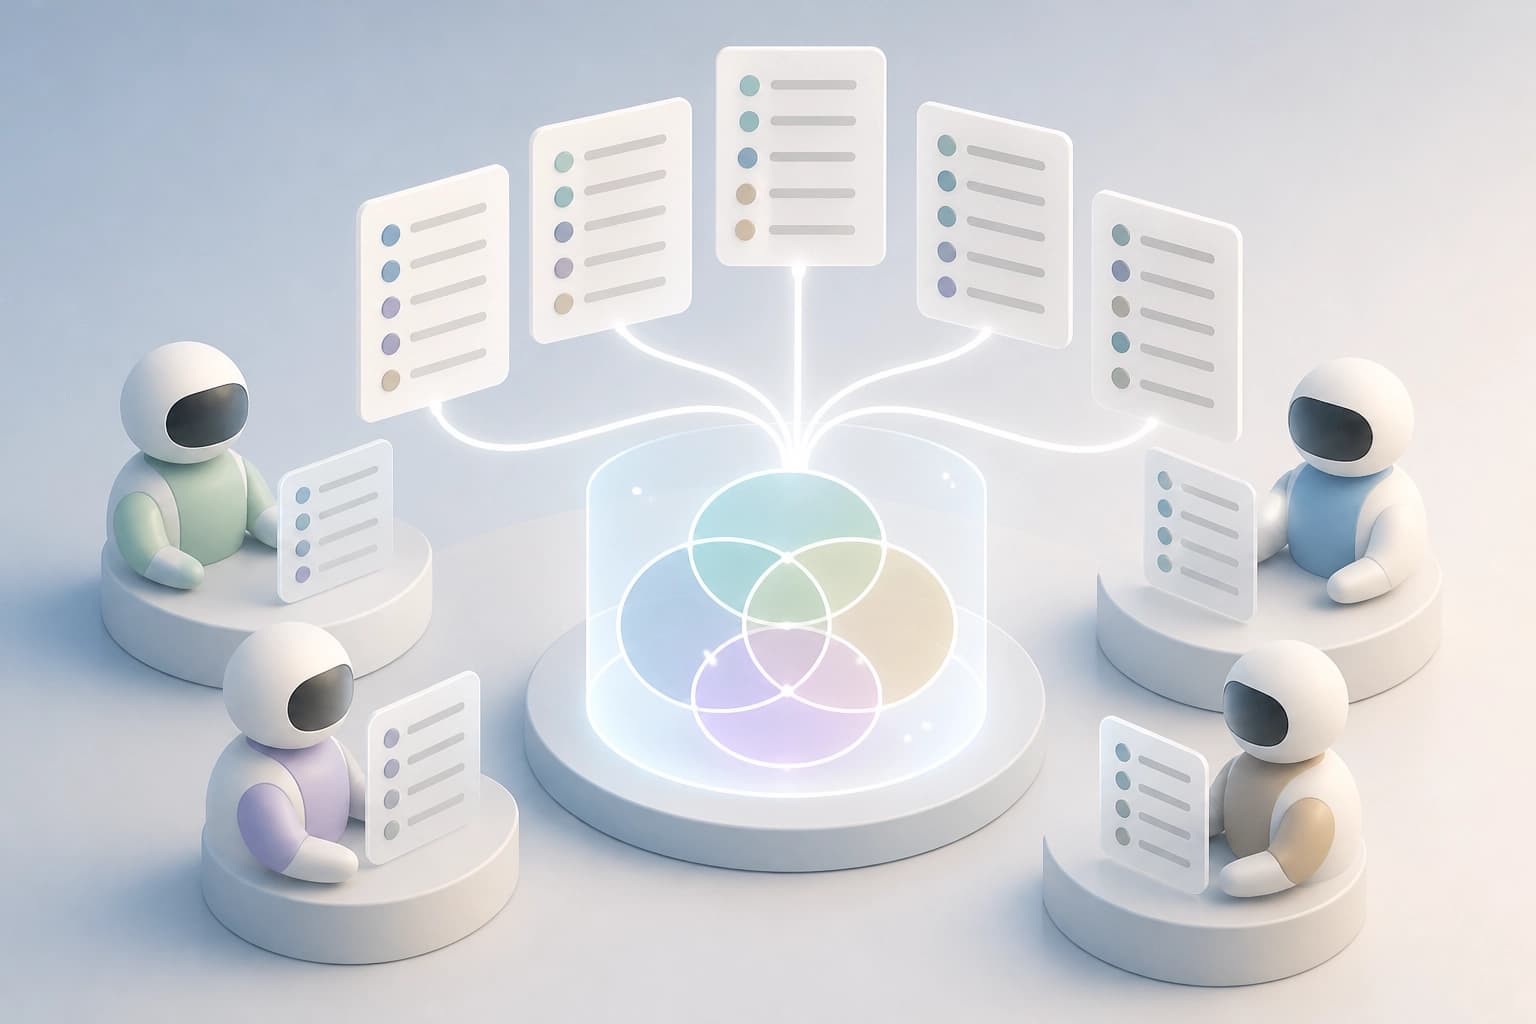
CHOIR adalah singkatan dari Collective Hierarchically-Ordered Inquiry Responses. Pendekatan ini mengadaptasi elisitasi daftar bebas untuk ensemble LLM. Tujuannya adalah mengungkap posisi yang membuat model-model dalam ensemble berbeda pendapat. Kesepakatan yang tampak di permukaan menyembunyikan perbedaan tersebut.
Metode ini bekerja dengan daftar, bukan rumusan yang sudah jadi. Permintaan berulang menghasilkan bahan tentang topik apa yang diangkat model secara spontan. Selanjutnya, bahan tersebut diseragamkan agar bisa dibandingkan.
Kriteria praktis: gunakan CHOIR ketika jawaban ensemble tampak sama, tetapi Anda perlu memahami persis di mana model-model tersebut berbeda.
Tahapan kerja metode
Metode ini terdiri dari tiga langkah.
- Meminta model-model dalam ensemble menyusun daftar berperingkat secara berulang.
- Menggabungkan elemen-elemen daftar menjadi konsep pada tingkat prompt.
- Mengukur tingkat kemunculan konsep pada berbagai model, variasi prompt, dan kondisi dengan persona.
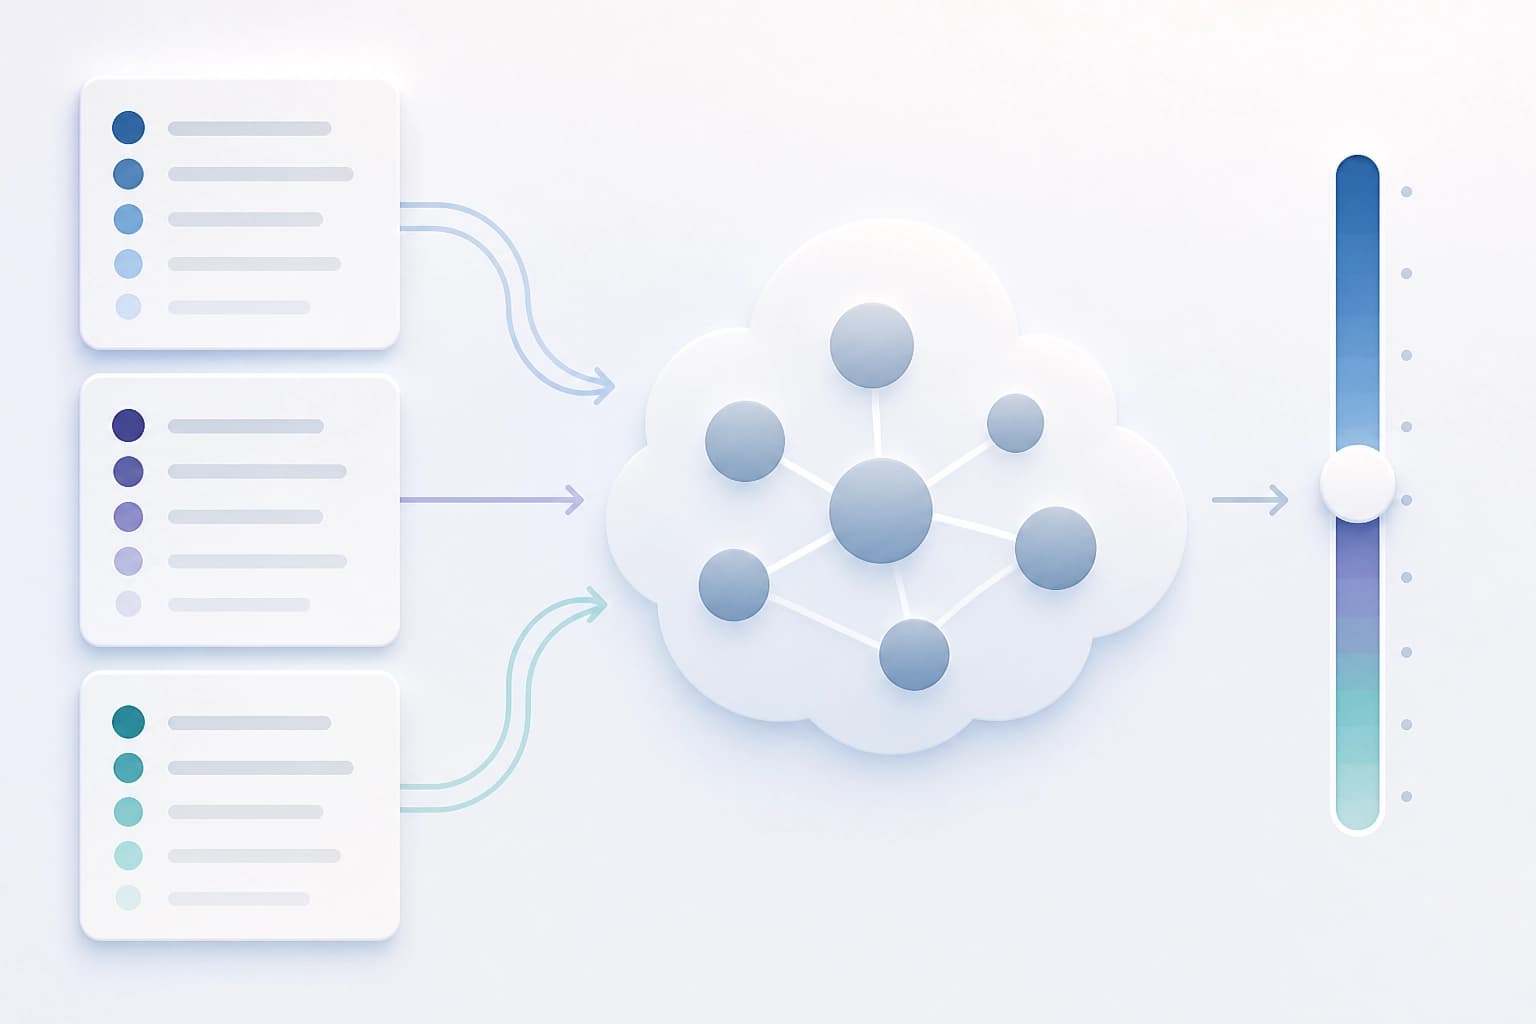
Setiap langkah menambahkan dimensi. Daftar menyediakan bahan mentah, penggabungan membuatnya bisa dibandingkan, dan pengukuran tingkat kemunculan menunjukkan perbedaannya. Tanpa menyatukannya menjadi konsep, perbandingan hanya berhenti pada kata-kata yang terpisah.
Kriteria praktis: uji metode ini dengan melihat apakah metode tersebut mempertahankan perbedaan setelah elemen-elemen digabungkan menjadi konsep.
Dataset yang digunakan untuk pengujian
| Dataset | Apa itu | Apa yang ditunjukkan |
|---|---|---|
| Infinity-Chat 100 | Dataset prompt eksternal dari penelitian terbaru tentang homogenitas jawaban terbuka model | Mereproduksi tingkat kesepakatan permukaan yang tinggi: 93/100 prompt berada di atas tingkat acak. Membedakan prompt sempit dari prompt luas, yang mengungkap kedalaman jawaban tersembunyi |
| Dataset diagnostik terarah | 27 pertanyaan untuk mengungkap perbedaan pada tingkat mekanisme | Digunakan untuk pemeriksaan terarah atas perbedaan di antara model |
Kedua dataset memiliki tujuan yang berbeda. Dataset eksternal menunjukkan gambaran umum kesepakatan sekaligus membedakan prompt luas dari prompt sempit. Dataset terarah dirancang untuk mengidentifikasi perbedaan pada tingkat mekanisme.
Kriteria pemilihan: gunakan dataset prompt eksternal untuk melihat gambaran kesepakatan, dan dataset diagnostik untuk menganalisis mekanisme.
Ciri-ciri perbedaan yang terlihat
Temuan-temuan ini terbagi menjadi tiga kelompok.
- Identitas model dasar tetap menjadi ciri yang paling kuat untuk dipulihkan. Hal ini berlaku baik untuk pemeriksaan terarah maupun dataset prompt eksternal.
- Prompt dengan persona menggeser konsep yang muncul dalam sidik jari model dasar.
- Modul pemeringkatan yang tidak mengetahui sumbernya mengidentifikasi kandidat langka tetapi stabil untuk dipelajari lebih lanjut.
Persona mengubah kemunculan konsep, tetapi tidak menutupi sinyal model dasar. Pemeringkatan tanpa informasi sumber berfungsi sebagai filter untuk analisis lebih lanjut.
Kriteria praktis: tetapkan model dasar terlebih dahulu, lalu nilai pergeseran akibat persona.
Kerangka diagnostik, bukan sekadar menyatakan kesepakatan
Para penulis menyarankan agar homogenitas jawaban terbuka dipandang sebagai tugas diagnostik. Dengan begitu, pertanyaannya berubah: di mana model-model mencapai kesepakatan, mengapa mereka sepakat, dan apa lagi yang dapat diungkap.
- Di mana mereka sepakat — peta konsep yang sama di antara model-model.
- Mengapa mereka sepakat — penyebab di balik kesepakatan permukaan.
- Apa lagi yang terlihat — kandidat yang diidentifikasi oleh pemeringkatan tanpa informasi sumber.
Artikel ini diterbitkan dalam Proceedings of the Third Conference on Language Modeling (COLM 2026), 2026. Artikel ini diajukan ke arXiv pada 29 September 2026. Penulisnya adalah Ben Wigler dan Maria Tsfasman.
Kriteria: homogenitas jawaban bukan kesimpulan akhir, melainkan titik awal untuk mendiagnosis kedalamannya.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026