
Manajemen memori terpusat dalam AI multiagen: personalisasi dengan biaya lebih rendah
Para penulis mengusulkan lapisan sistem memori bersama: agen menyimpan informasi terstruktur, sementara sistem mengendalikan pemilihan, perlindungan data, dan penyampaiannya kepada model. Dalam pengujian pada AIOS, pendekatan ini meningkatkan personalisasi dibandingkan penyimpanan eksternal dan RAG, serta mengurangi latensi sebesar 15–61% dibandingkan penggunaan konteks lengkap, dengan hasil yang sebanding pada dua dari tiga model.
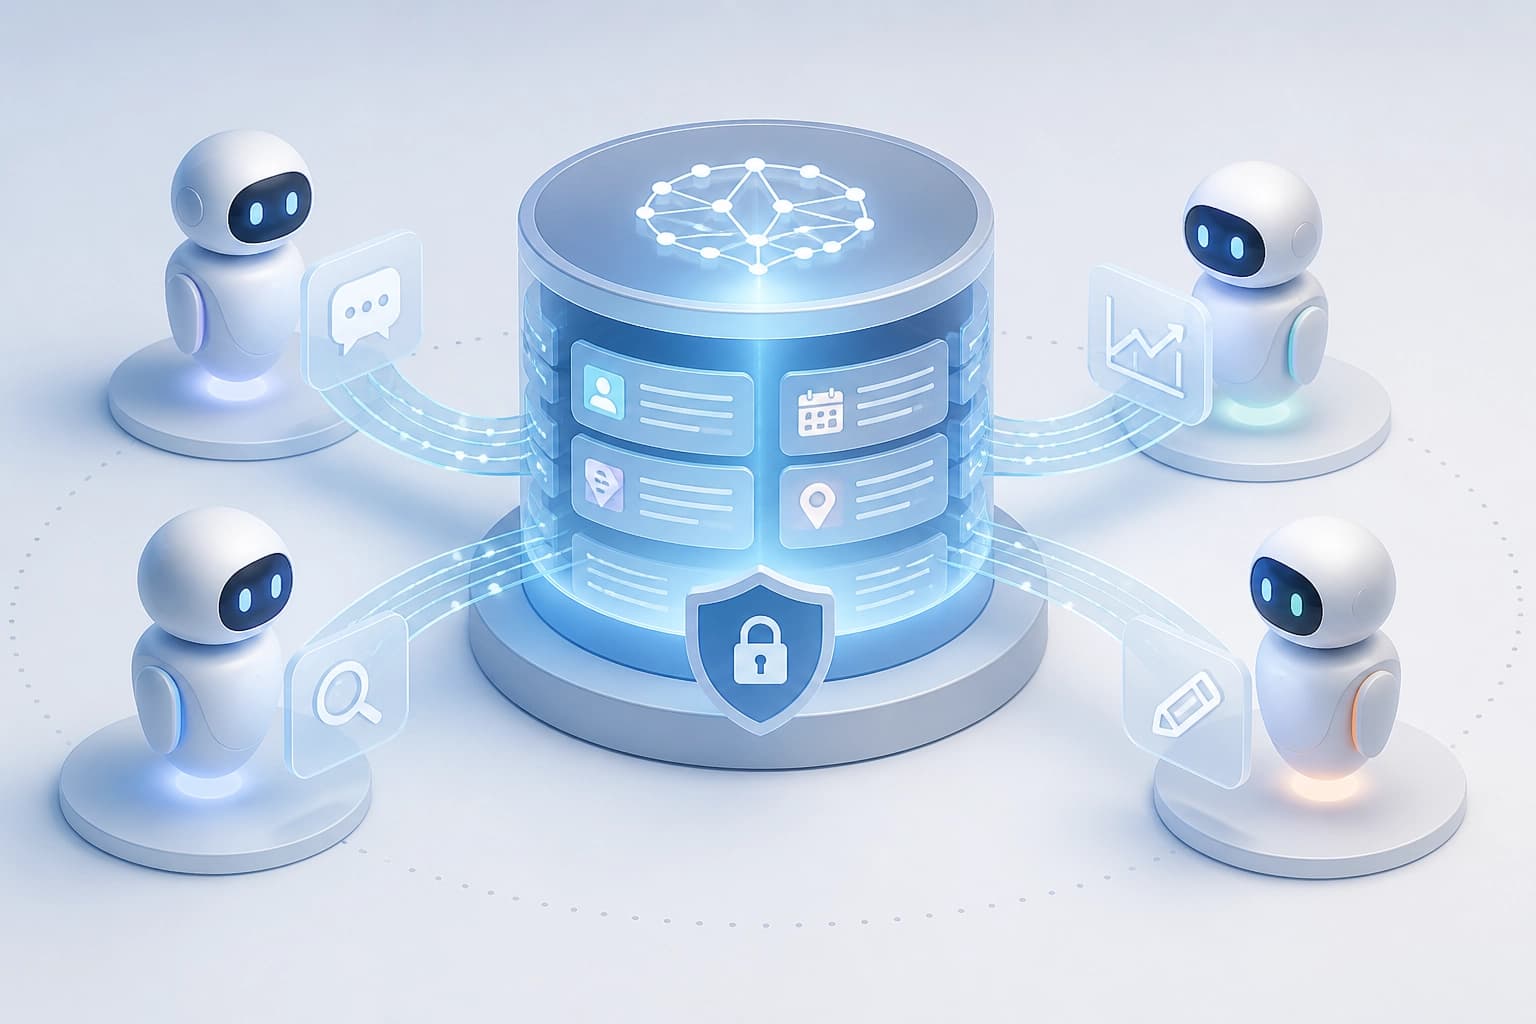
Cara kerja memori terpusat
Agen khusus mencatat memori terstruktur yang diberi label. Kernel sistem agen mengelola pengambilan, kerahasiaan, dan penyisipannya ke dalam prompt.
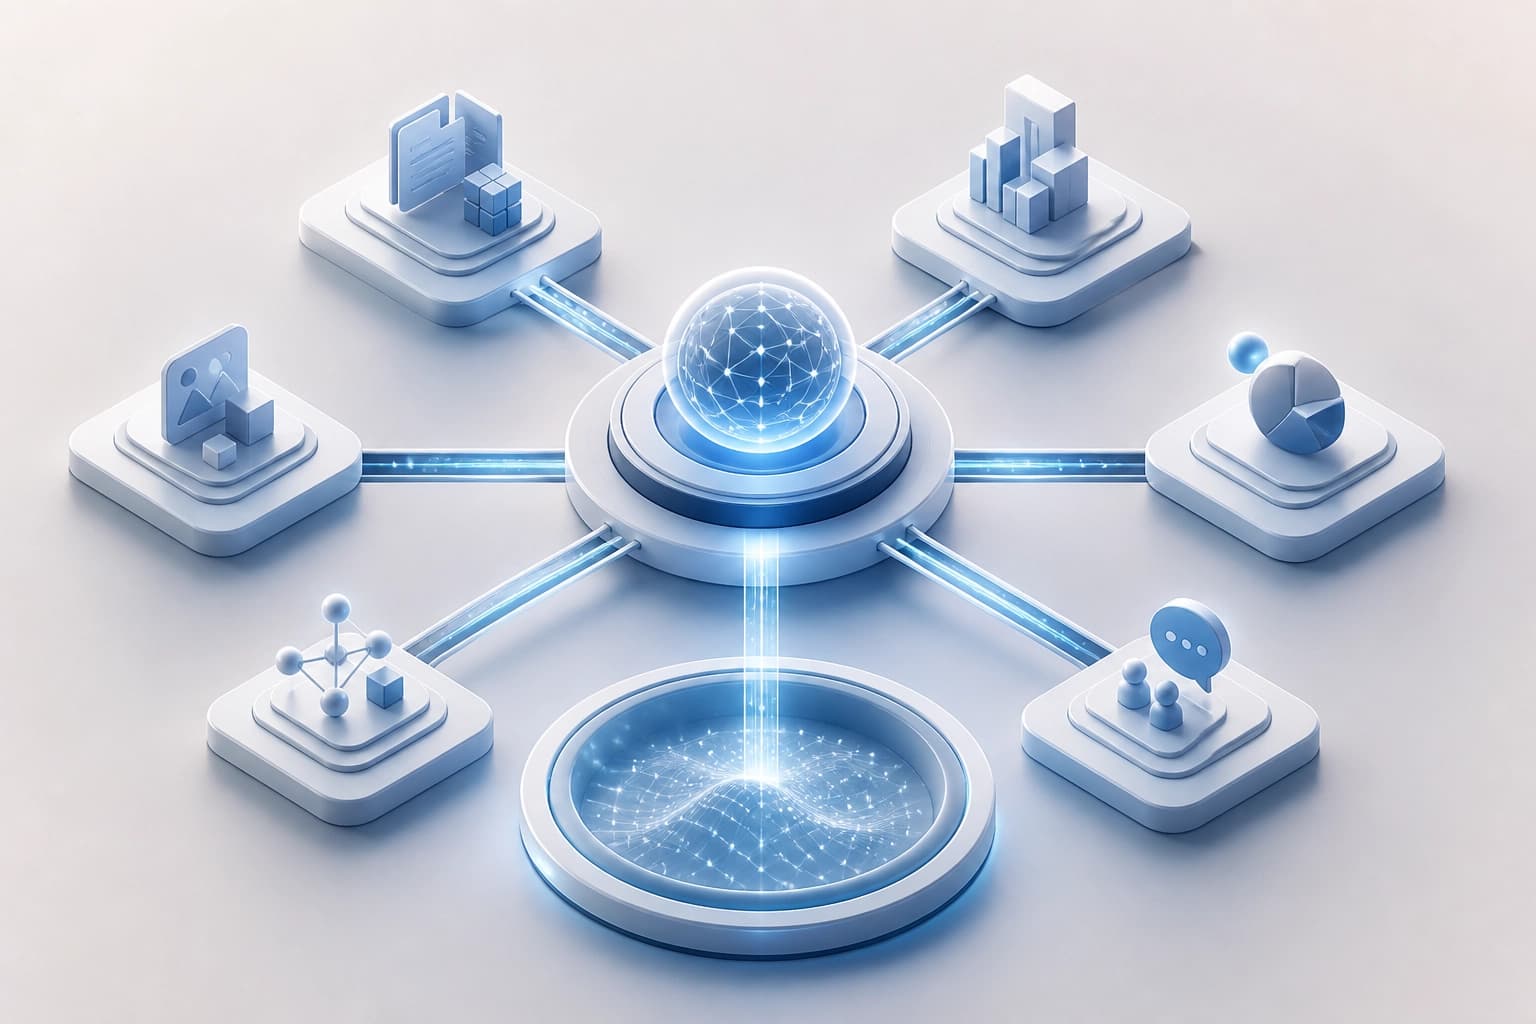
Dalam skema ini, agen membuat memori, sedangkan kernel menentukan cara sistem menggunakannya:
- Pencatatan: agen menyimpan memori terstruktur yang diberi label.
- Pengambilan: proses ini dikelola oleh kernel, bukan oleh agen individual.
- Perlindungan dan penyisipan: kernel bertanggung jawab atas kerahasiaan dan penyisipan memori ke dalam prompt.
Sentralisasi memisahkan pembuatan memori dari pengendalian penggunaannya. Hal ini penting jika aturan pengambilan dan penyisipan harus berlaku di seluruh sistem agen.
Cara pendekatan ini diuji
Desain ini diterapkan dan dievaluasi pada AIOS. Para penulis membandingkannya dengan tiga alternatif pada tiga model asisten.
- GPT-4o
- Llama-3.1:8B
- Qwen-2.5:7B
Penelitian ini mencakup total 1.800 uji coba. Bagian ini menjelaskan skala pengujian, bukan kondisi perbandingan tertentu.
Hasil perbandingan
Hasilnya bergantung pada cara memori dikelola. Tabel berikut menyajikan temuan para penulis untuk tiga alternatif.
| Alternatif | Hasil pengelolaan terpusat |
|---|---|
| Mem0 dengan penyimpanan dasar yang sama | Skor personalisasi meningkat 2,4–4,0 poin pada skala lima poin. Setiap perbandingan signifikan secara statistik: p < 10^-18. |
| Penyisipan standar melalui retrieval-augmented generation | Peningkatannya besar dan konsisten pada ketiga model. |
| Penggabungan konteks penuh tanpa filter | Pada dua model, hasilnya sebanding secara statistik; pada model ketiga, pendekatan terpusat sedikit tertinggal. Prompt menjadi lebih pendek, dan latensi dari awal hingga akhir turun 15–61% pada semua model. Jumlah token per panggilan dan biaya inferensi juga menurun. |
Untuk GPT-4o, contoh skor penggunaan profil berubah dari 1,05 menjadi 4,69. Indikator ini menggambarkan hasil perbandingan dengan Mem0.
Kapan sentralisasi perlu dipertimbangkan
Pengelolaan memori terpusat patut dipertimbangkan jika sistem membutuhkan aturan umum untuk pengambilan, perlindungan, dan penyisipan memori. Pendekatan ini memindahkan keputusan tersebut dari agen individual ke kernel sistem.
Kriteria praktisnya adalah membandingkan personalisasi yang dibutuhkan dengan jumlah konteks dan biaya yang dapat diterima. Para penulis menyimpulkan bahwa sentralisasi memberikan sebagian besar manfaat personalisasi dari konteks tanpa batas dengan biaya yang jauh lebih rendah.
Artikel ini didasarkan pada Kernel-Managed Shared Memory for System-Wide Personalization karya Ryan Lum dan Yongfeng Zhang, yang diajukan pada 9 September 2026.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026