
CEG-Agent: Analisis kausal kegagalan dalam jejak agen LLM melalui graf kesalahan
Karya ini memperkenalkan CEG-Agent, sebuah kerangka kerja berbasis alat untuk mendiagnosis secara kausal jejak agen. Klasifikasi formal membedakan anomali, kesalahan, dan kegagalan, sementara graf CEG bertipe menghubungkan peristiwa eksekusi dengan simpul diagnostik dan kegagalan akhir; benchmark CEG-Bench mengonfirmasi keunggulan pendekatan ini dalam akurasi semantik dan struktural.
Di Mana Diagnosis Jejak Agen Bermasalah
Agen berbasis LLM digunakan dalam aplikasi kompleks. Jejak agen tersebut panjang. Hal ini mempersulit diagnosis kegagalan.
Metode diagnosis yang ada mencampur anomali, kesalahan, dan kegagalan. Akibatnya, sasaran diagnosis menjadi ambigu.
Metode-metode ini tidak memodelkan secara terstruktur bagaimana kesalahan yang signifikan secara kausal menyebar dan semakin parah. Kegagalan tugas pada akhirnya tidak dapat diatribusikan secara andal.
Kriteria praktis: metode diagnosis harus memisahkan jenis-jenis penyimpangan dan menelusuri hubungan kausal di antara semuanya.
Apa itu CEG-Agent
CEG-Agent adalah kerangka kerja berbasis agen yang menggunakan alat. Kerangka ini melakukan diagnosis kausal terhadap jejak agen.
Kerangka ini memperkenalkan taksonomi eksplisit untuk anomali, kesalahan, dan kegagalan. Berdasarkan taksonomi ini, kerangka tersebut membangun Causal Error Graphs (CEGs).
| Pendekatan | Pemisahan anomali, kesalahan, dan kegagalan | Model penyebaran kesalahan |
|---|---|---|
| Metode diagnosis yang ada | Mencampur konsep-konsep ini | Tidak memodelkan secara terstruktur |
| CEG-Agent | Memperkenalkan taksonomi eksplisit | Membangun CEG dengan hubungan kausal |
Kriteria pemilihan: kerangka kerja harus memberikan sasaran diagnosis yang tidak ambigu dan didasarkan pada model kausal bertipe.
Causal Error Graphs: Representasi Kausal Bertipe
CEG adalah representasi bertipe yang terpadu. Representasi ini menghubungkan elemen-elemen jejak dengan hubungan kausal.
Graf mencakup tiga jenis elemen:
- peristiwa eksekusi;
- simpul diagnostik;
- hasil berupa kegagalan.
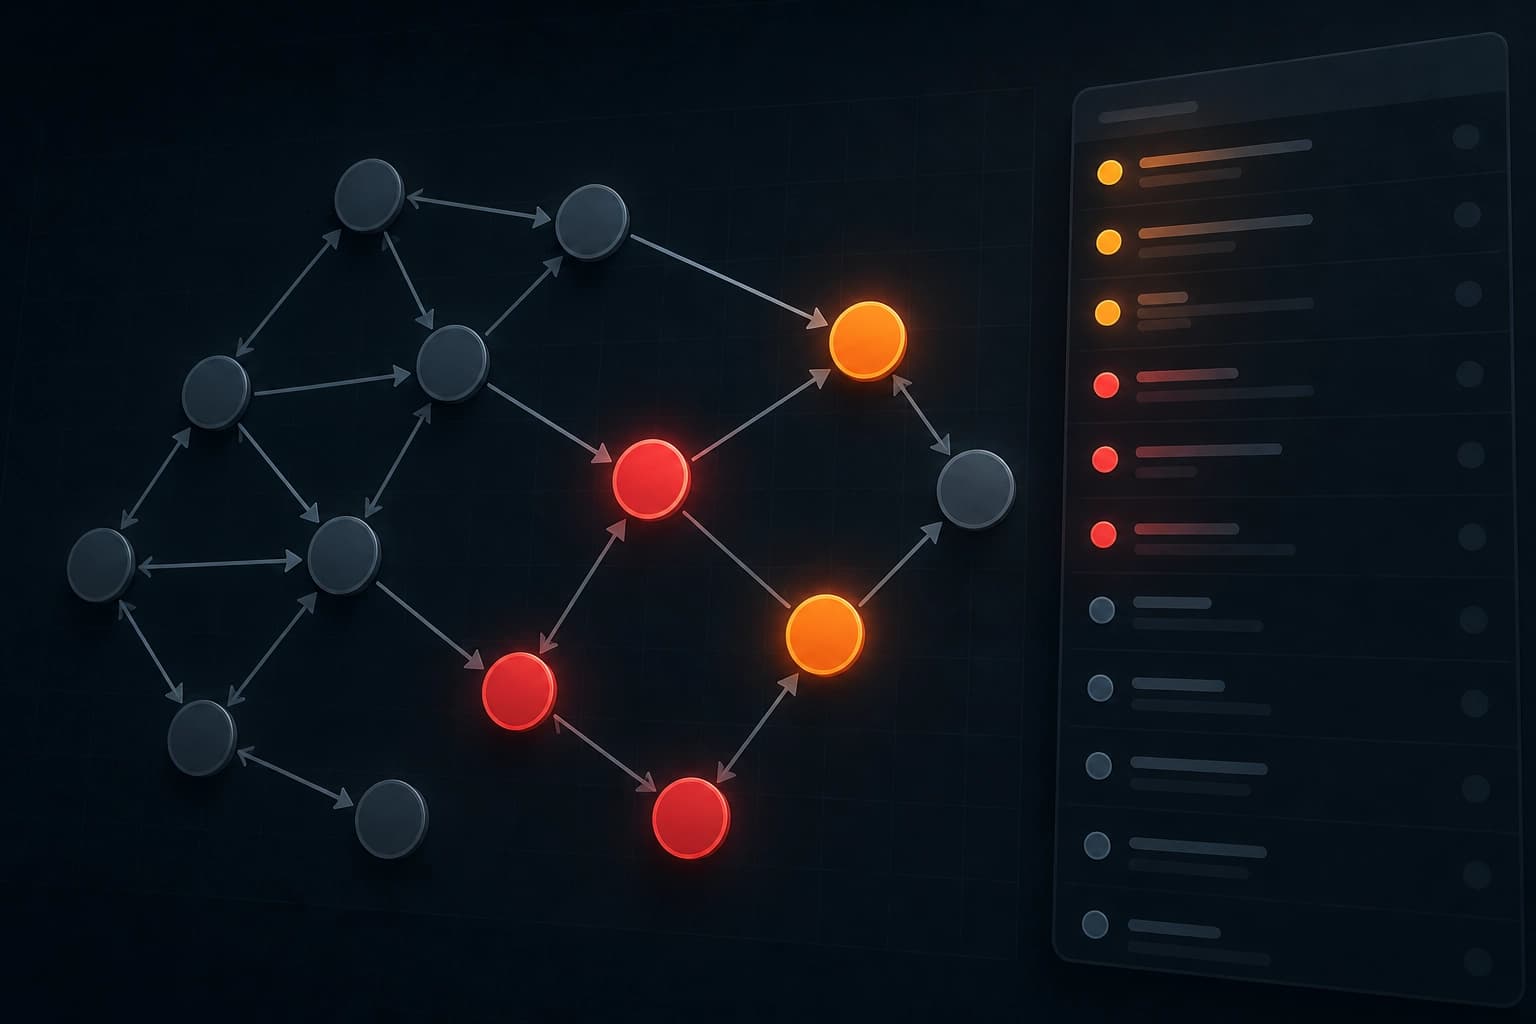
Semua elemen terhubung melalui hubungan kausal dalam format terpadu. Hal ini membedakan graf tersebut dari kumpulan sinyal yang terpisah-pisah.
Kriteria: representasi harus menghubungkan jalannya eksekusi dengan kegagalan akhir melalui hubungan kausal yang eksplisit.
CEG-Bench dan Anotasi melalui AAAP
CEG-Bench dibuat untuk mengevaluasi diagnosis kausal terhadap jejak. Ini adalah tolok ukur dengan anotasi yang sepenuhnya dilakukan oleh agen.
Anotasi CEG dalam tolok ukur ini diperoleh menggunakan Adversarial Agentic Adjudication Protocol (AAAP). Anotasi tersebut memiliki keandalan dan konsistensi yang tinggi.
Anotasi tersebut diperiksa menggunakan set acuan buatan manusia yang disusun oleh para ahli. Anotasi otomatis menunjukkan kesesuaian yang tinggi dengan anotasi para ahli.
Kriteria: tolok ukur dengan anotasi yang divalidasi terhadap set acuan manusia layak digunakan untuk membandingkan metode diagnosis kausal.
Hasil dan Kriteria Pemilihan
Dalam eksperimen pada CEG-Bench, CEG-Agent mencapai hasil state-of-the-art. Evaluasi dilakukan berdasarkan dua kriteria.
Kriteria pertama adalah evaluasi yang dilunakkan secara semantik. Kriteria kedua adalah evaluasi yang akurat secara struktural. Kerangka ini menunjukkan hasil state-of-the-art pada kedua kriteria.
Kriteria pemilihan: jika tugas memerlukan ketepatan baik secara semantik maupun struktural dalam analisis, jadikan metode dengan hasil pada tingkat tersebut sebagai acuan.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026
Model dunia untuk agen berbasis LLM tertutup: koreksi pada titik risiko
PAWM diusulkan sebagai prediktor eksternal yang tidak menduplikasi observasi langkah demi langkah, tetapi aktif saat kegagalan mungkin terjadi dan mengarahkan agen menjauhi tindakan yang keliru. Setelah SFT pada skenario sintetis dan pelatihan bersama GRPO, metode ini menghasilkan peningkatan 24,3% di ScienceWorld dan 7,7% di WebArena-Lite untuk Claude Sonnet 4.5.
4 November 2026
Lapisan klasifikasi di atas SpeechLLM: keunggulannya dibandingkan pembuatan label dalam pengenalan emosi
Dengan menggunakan dataset IEMOCAP dan MELD, keluaran generatif berupa label emosi dibandingkan dengan pengklasifikasi linear yang diterapkan pada representasi tersembunyi SpeechLLM yang ringkas. Peningkatan kualitas dari pengklasifikasi ini tidak berlaku universal: hasilnya bergantung pada korpus dan apakah yang digunakan adalah transkrip acuan atau hasil ASR.
4 November 2026