Apa yang diuji oleh simulasi
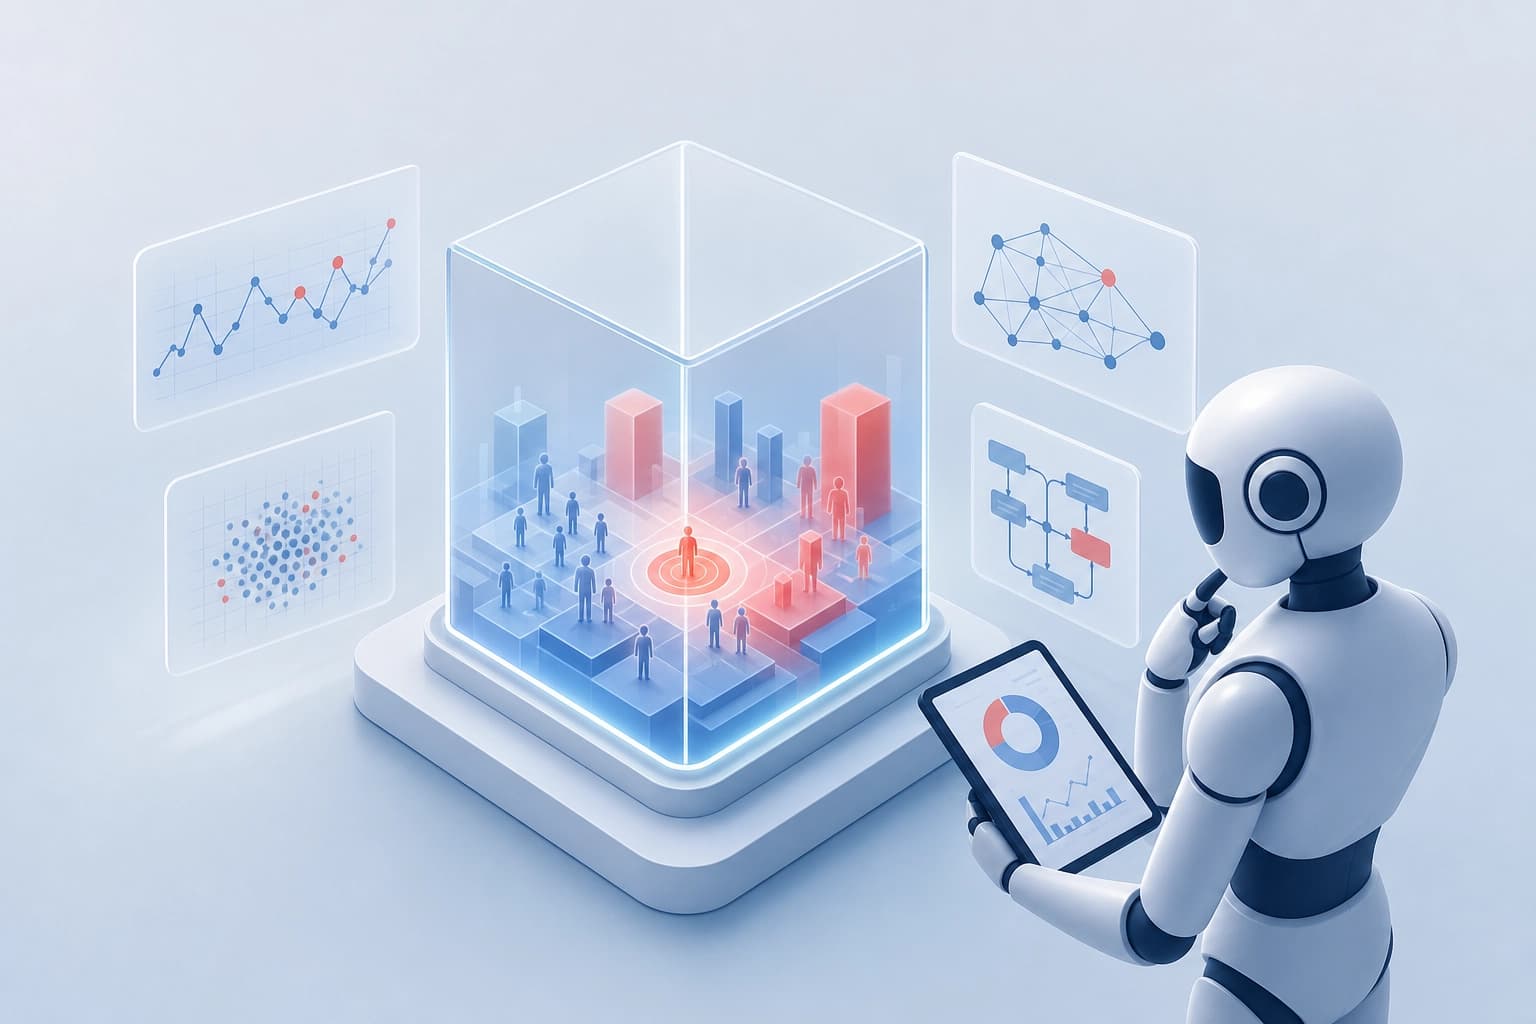
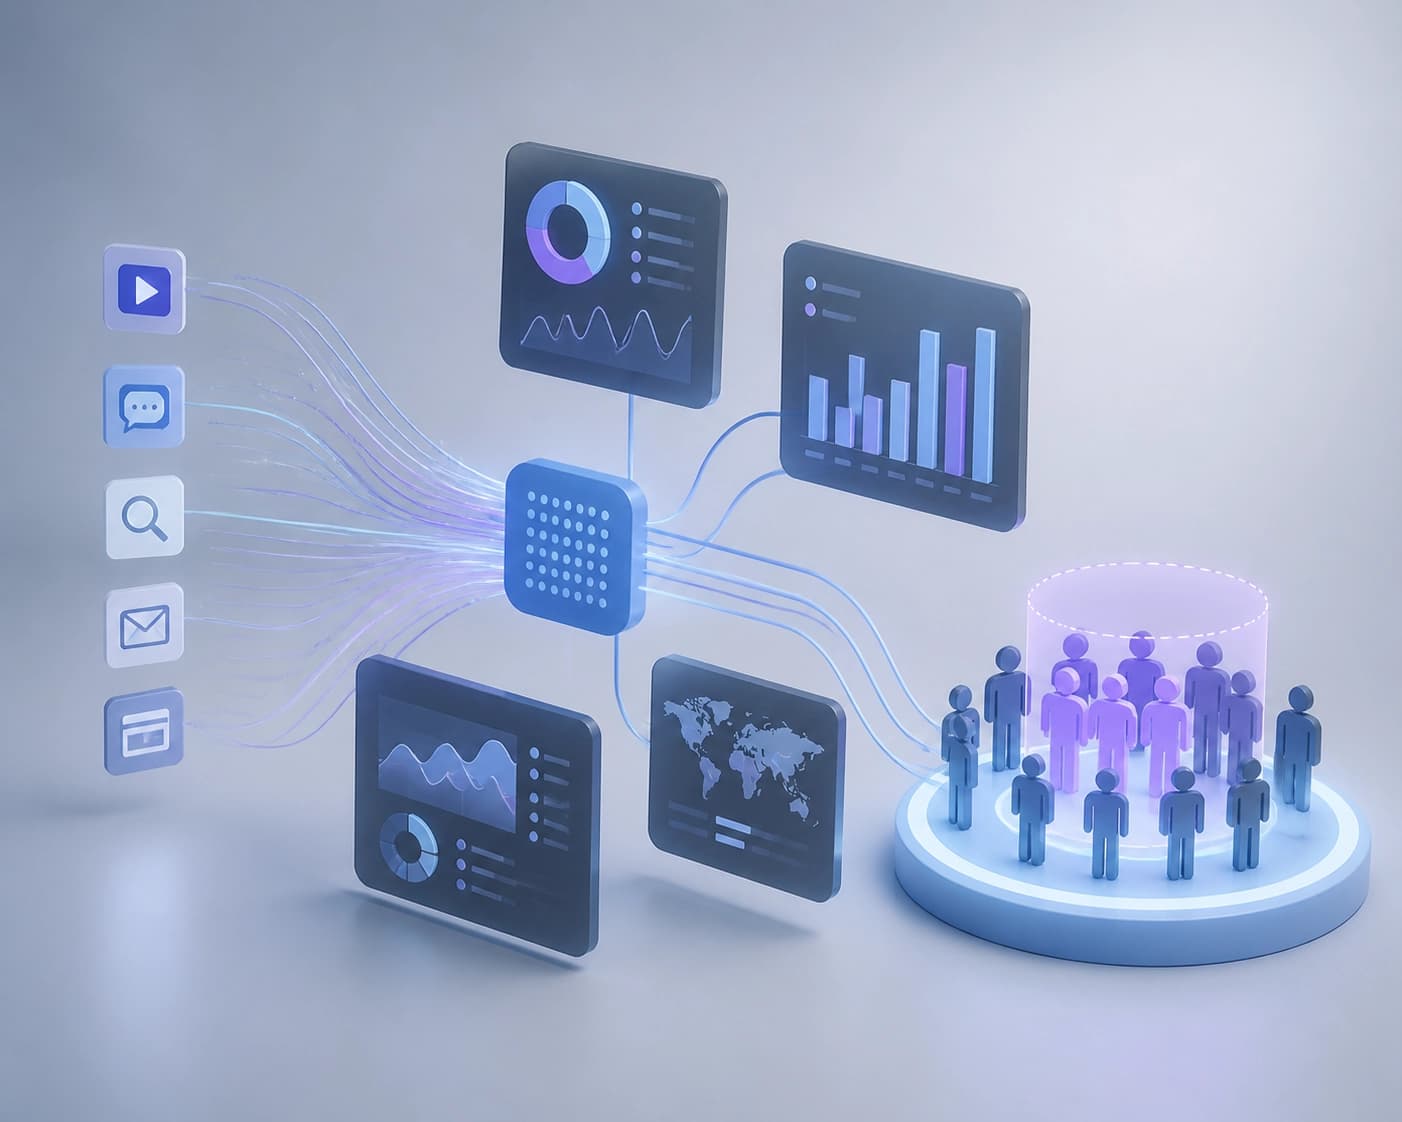
TRACE adalah lingkungan diagnostik untuk periklanan digital. TRACE mencakup 12 penyebab utama dan atribusi segmen yang terperinci. Dalam setiap episode, agen menyelidiki data menggunakan Python dan SQL. Kemudian, agen menentukan penyebab utama dan, jika relevan, segmen yang terdampak.
TRACE dijelaskan dalam makalah karya Rui Sun, Zhan Shi, dan Bing He, yang diajukan ke arXiv pada 9 September 2026. ID makalahnya adalah arXiv:2609.10315.
Cara evaluasi dilakukan
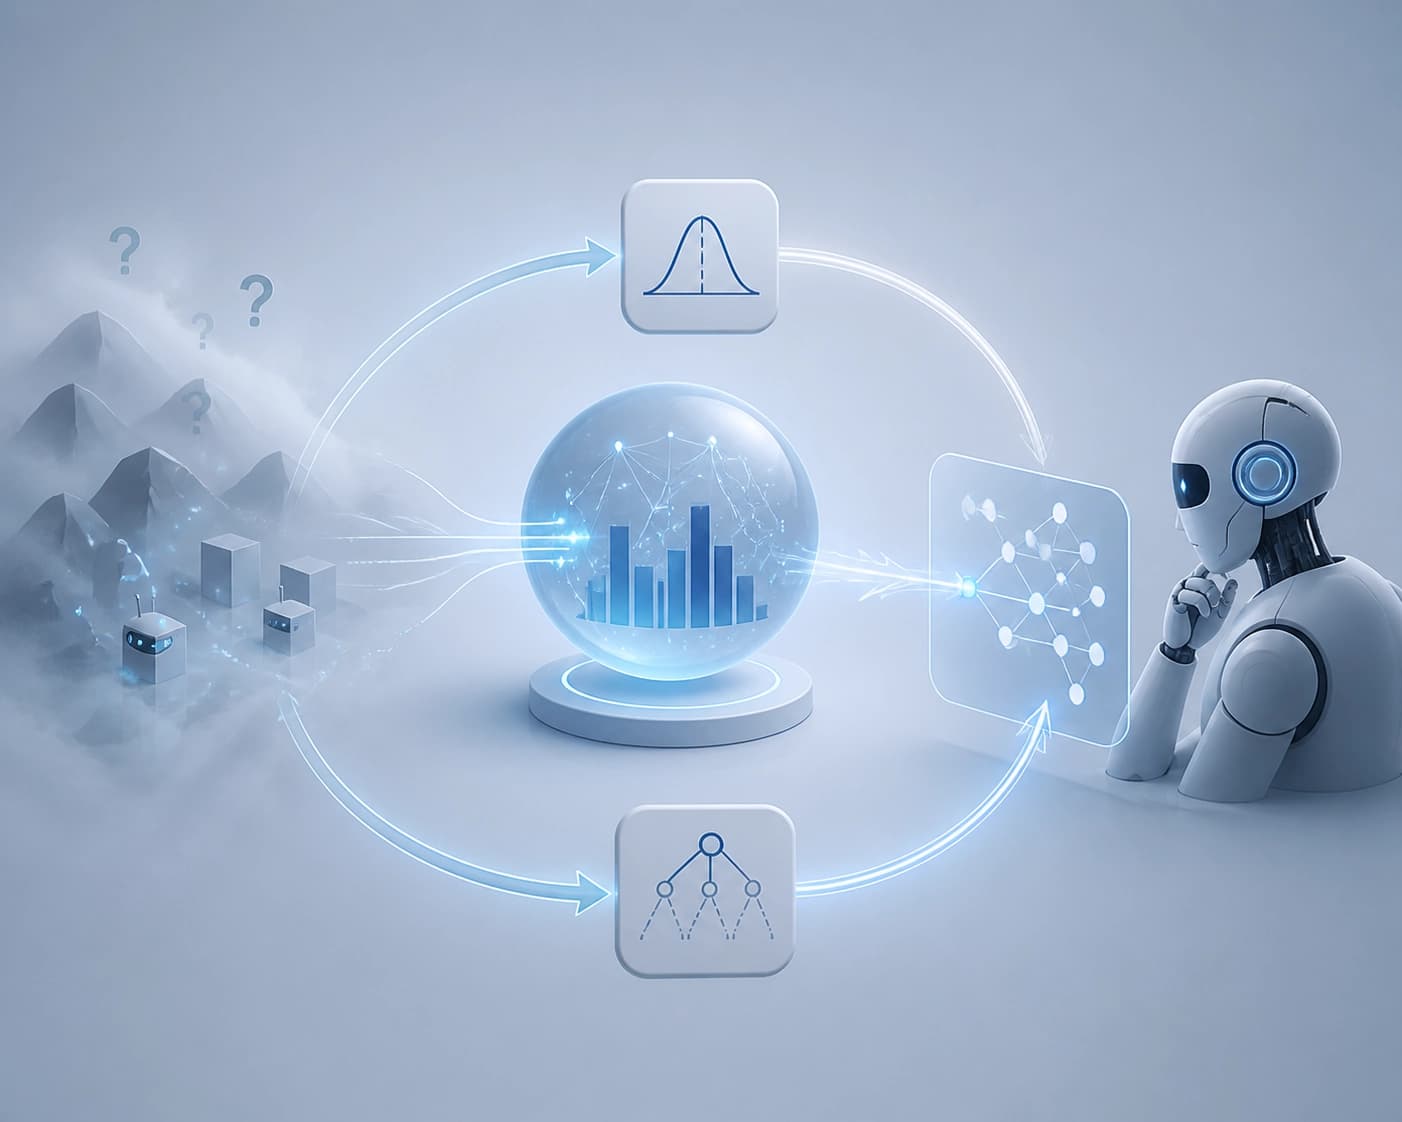
Evaluasi dibangun berdasarkan intervensi dan pengamatan yang ditimbulkannya:
- Intervensi dipilih dan dimasukkan ke dalam simulator terkontrol.
- Simulator menghasilkan pengamatan yang sesuai.
- Agen menyelidiki data dan mencari penyebab kegagalan.
- Intervensi tersembunyi berfungsi sebagai label acuan dan memungkinkan penghitungan imbalan objektif.
Agen tidak menerima penjelasan yang sudah jadi. Agen harus mencocokkan bukti yang berisik, bercampur, dan tersebar di antara data. Dengan demikian, simulasi ini menguji inferensi kausal, bukan sekadar pengenalan jawaban yang telah ditentukan sebelumnya.
Cara membaca hasil
Para penulis mengevaluasi model pada set pengujian tertahan yang terdiri atas 235 episode. Baseline prompting terkuat adalah Claude Opus 5 dengan skor 0.686 FullAttr@1.
| Model atau tahap | Hasil |
|---|---|
| Qwen3.5-35B-A3B setelah supervised fine-tuning | 0.159 → 0.637 |
| Model yang sama setelah RL dengan imbalan tersintesis | 0.757 |
| Qwen3.5-122B-A10B dalam baseline prompting | Di bawah hasil 0.757 |
Hasil 0.757 melampaui semua baseline prompting yang dievaluasi, termasuk model frontier dengan kode sumber tertutup. Para penulis juga melaporkan bahwa policy yang dihasilkan menggunakan panggilan alat jauh lebih sedikit daripada versi prompting dari model dasar 35B.
Implikasi hasil bagi pelatihan agen
Para penulis berpendapat bahwa akses ke sinyal pelatihan objektif yang dapat diskalakan berpotensi menjadi kendala yang lebih penting daripada ukuran model semata. Kesimpulan ini berlaku untuk tugas yang dijelaskan, bukan aturan universal untuk semua sistem AI.
Evaluasi simulasi dapat membuat tugas penalaran diagnostik yang ambigu cocok untuk pelatihan penguatan berskala besar. Syarat utamanya adalah kesimpulan agen dapat dicocokkan dengan intervensi tersembunyi dan imbalan objektif dapat dihitung.
Kapan pendekatan ini sesuai
Simulasi cocok untuk menguji inferensi kausal jika rumusan tugas memungkinkan:
- menetapkan intervensi dan memasukkannya ke dalam lingkungan terkontrol;
- menghasilkan pengamatan yang terkait dengannya;
- menyimpan intervensi sebagai label acuan tersembunyi;
- mengevaluasi penyebab utama dan segmen yang terdampak, jika relevan.
Jika tugas tidak memungkinkan pencocokan dengan label acuan seperti itu, mekanisme imbalan objektif yang dijelaskan tidak dapat diterapkan. Kriteria praktis untuk memilih pendekatan ini adalah apakah kesimpulan agen dapat diverifikasi berdasarkan penyebab tersembunyi tanpa mengungkapkannya selama analisis.