
CARAT: menguji apakah LLM ilmu material menghasilkan struktur atau hanya merangkum prompt
Studi ini mengusulkan protokol yang menetapkan pertanyaan dan jawaban acuan dalam delapan cara penyajian struktur serta menandai relasi di GraphSpace secara terpisah. Eksperimen dengan fine-tuning berpasangan, masking bidang target, dan penambahan bukti menunjukkan bahwa model mampu mempelajari penerapan relasi maupun mengikuti tautan, tetapi penghapusan tautan menurunkan akurasi hingga di bawah tingkat penelusuran heuristik.
Mengapa akurasi tidak membuktikan penalaran
Model bahasa untuk ilmu material dapat memberikan jawaban yang benar karena dua alasan berbeda. Model mungkin menyimpulkannya dari data struktural, atau mengulang nilai yang sudah ada dalam input. Metrik akurasi biasa tidak membedakan kedua kasus ini. Deskripsi struktural mungkin memuat kolom yang digunakan untuk menilai jawaban, sehingga skornya mencerminkan kemampuan membaca petunjuk.
Benchmark CARAT dibangun dengan berfokus pada perbedaan ini. Benchmark ini menguji apakah LLM ilmu material bernalar berdasarkan data struktural atau sekadar mengulang petunjuk. Penulis makalah ini adalah Jiajun Wu, Jian Yang, Zixiang Ni, Zhenzhu Li, dan Bin Chong; makalah tersebut diajukan pada 29 September 2026.
Kriteria praktis: akurasi tinggi pada data struktural saja tidak membuktikan apa pun. Yang perlu diperhatikan adalah kondisi saat jawaban diperoleh.
Cara kerja perbandingan berpasangan
Pertanyaan dan jawaban acuan tetap sama untuk delapan representasi yang dibandingkan. Relasi struktural ditandai secara terpisah di GraphSpace.
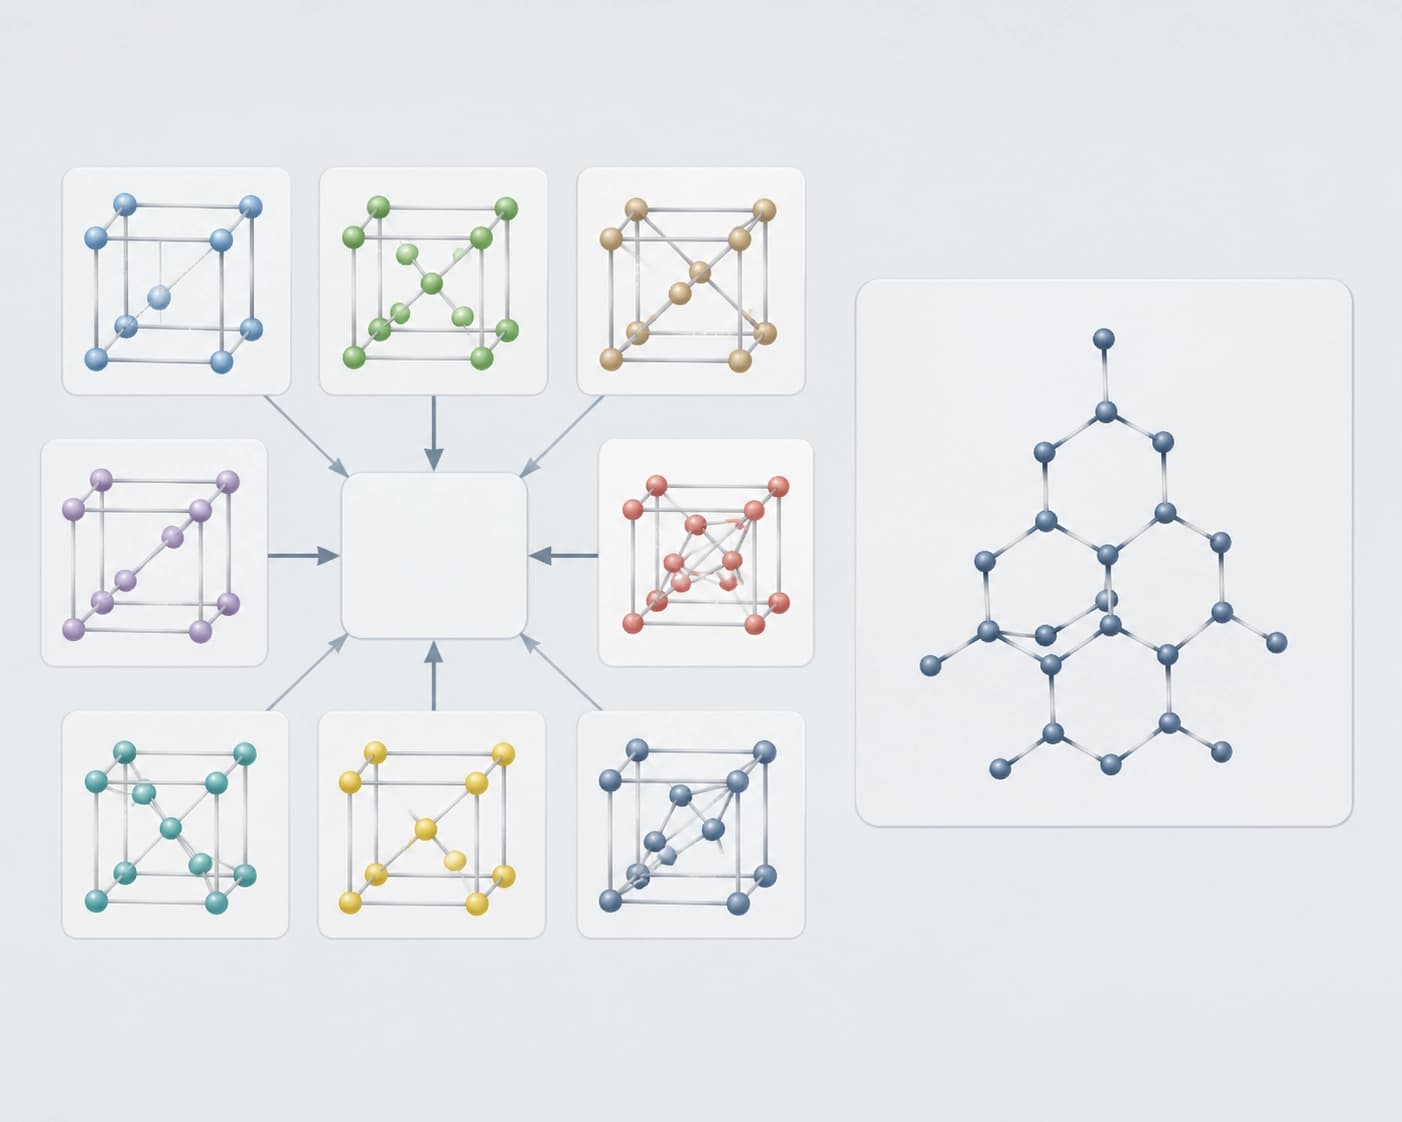
Metode ini dilengkapi dengan fine-tuning berpasangan, pemaskeran jawaban, penambahan bukti, inferensi berpasangan, dan aturan yang memungkinkan model menahan diri untuk tidak membuat pernyataan.
| Yang dibandingkan | Perbedaan |
|---|---|
| Representasi berbasis struktur dibandingkan dengan input yang hanya berisi formula pada keluarga tugas tersulit | 17.3 poin |
Pertanyaan yang tetap sama meniadakan penjelasan yang didasarkan pada rumusan tugas. Pemaskeran jawaban menghalangi model untuk langsung memberikan nilai yang sudah tersedia.
Kesimpulan: representasi hanya layak dibandingkan jika pertanyaan dan jawaban acuannya tetap sama. Jika tidak, perbedaannya menunjukkan kualitas teks tugas, bukan pemrosesan struktur.
Seberapa besar kesenjangan antara GraphSpace dan graf sederhana
GraphSpace mengungguli graf periodik sederhana sebesar 19.3 poin. Kesenjangan ini berasal dari dua efek yang berbeda.
| Kondisi | Perbedaan |
|---|---|
| Representasi sederhana memuat semua yang diperlukan untuk menjawab | 1.96 poin |
| Kolom-kolom tersebut sama sekali tidak ada dalam representasi sederhana | 46.7 poin |
Ketika representasi dasar sudah cukup untuk menjawab, keunggulannya hampir hilang. Ketika kolom yang diperlukan tidak ada di dalamnya, kesenjangannya menjadi besar. Para penulis mencatat bahwa hasil utama perbandingan ini mencerminkan kurangnya data dalam representasi dasar, bukan cara bukti direpresentasikan.
Kriteria praktis: sebelum menyimpulkan bahwa satu representasi lebih unggul, periksa kolom apa saja yang tersedia di dalamnya. Jika tidak, yang diukur adalah kelengkapan data, bukan metode.
Strategi jalan pintas dan perombakan benchmark
Pengujian ini mengungkap kelemahan dalam kumpulan tugas tersebut. Aturan yang melewati rujukan dan langsung membaca daftar dapat menjawab empat dari tujuh keluarga tugas yang dibuat lebih sulit. Model mungkin tidak memahami relasinya, tetapi hanya mencari jalan pintas.
Benchmark tersebut diperbarui. Sebelas strategi jalan pintas semacam ini kini menghasilkan skor yang mendekati acak.
Kesimpulan: kumpulan tugas hanya layak digunakan untuk menilai penalaran setelah diuji terhadap jalan pintas. Jika aturan sederhana dapat menyelesaikan beberapa keluarga tugas, yang diukur bukanlah penalaran.
Menyebutkan rujukan dalam jawaban dan menggunakan relasi
Model beku menyebutkan rujukan, tetapi memberikan jawaban yang sama pada 95.6% kasus berpasangan saat rujukan tersebut dialihkan. Model mengulang relasi tanpa menggunakannya.
| Kondisi | Persentase kasus berpasangan dengan jawaban yang sama |
|---|---|
| Model beku, rujukan dialihkan | 95.6% |
| Setelah pelatihan berpasangan, rujukan dialihkan | 99.8% |
| Rujukan dihapus | 23.4% |
| Strategi jalan pintas terbaik | 27.0% |
Setelah pelatihan berpasangan, angkanya mencapai 99.8%. Menghapus rujukan menurunkannya menjadi 23.4%, di bawah 27.0% yang dihasilkan strategi jalan pintas terbaik. Para penulis menyimpulkan bahwa kedua langkah pelatihan—menggunakan relasi dan mengandalkan rujukan—dapat dipelajari.
Kriteria: menyebutkan rujukan tidak sama dengan menggunakannya. Perilaku model perlu diuji saat rujukan dialihkan maupun dihapus.
Implikasinya bagi evaluasi alat
- Periksa apakah input memuat jawaban yang sudah tersedia untuk pertanyaan yang diajukan.
- Perhatikan hasil saat rujukan dialihkan dan dihapus, bukan hanya saat rujukan disebutkan.
- Minta penjelasan tentang kontrol yang digunakan: pertanyaan, jawaban acuan, dan beberapa representasi yang tetap sama.
- Pastikan apakah kumpulan tugas diperbarui setelah diuji terhadap strategi jalan pintas.
- Evaluasi kesenjangan yang diklaim bersama dengan komposisi datanya, bukan sebagai angka yang berdiri sendiri.
Kriteria pemilihan: hasil layak dipercaya jika tidak dapat dijelaskan oleh keberadaan kolom yang diperlukan dalam petunjuk atau oleh cara kerja aturan jalan pintas yang sederhana.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian agen pemrograman dalam pengembangan XR interaktif: hasil GenXR-Bench
GenXR-Bench telah dirilis—seperangkat 112 tugas ahli untuk mengevaluasi agen coding secara menyeluruh dalam pengembangan XR interaktif: mulai dari menyempurnakan fitur dan memperbaiki bug hingga membuat aplikasi dengan pengujian perilaku pada perangkat konsumen. Dari sepuluh model yang diuji, hasil terbaik adalah 50,9% Pass@1; kegagalan yang berulang meliputi penanganan peristiwa sensor asinkron, penempatan objek di ruang nyata, dan pemahaman interaksi dalam konteks fisik.
5 November 2026
Dari Imbalan Skalar ke Front Pareto: Sintesis RTL LLM dengan Pembelajaran Penguatan Multikriteria
Diusulkan metode untuk melatih model bahasa agar menghasilkan bukan hanya satu skema, melainkan serangkaian kandidat RTL dengan kompromi berbeda antara luas area, latensi, dan konsumsi daya; reward dihitung berdasarkan kontribusi kandidat terhadap hypervolume front Pareto. Pada RTLLM v2, hypervolume relatif meningkat 13,3 poin persentase dibandingkan versi dasar tanpa optimasi PPA dan 14,4 poin persentase dibandingkan pelatihan penguatan dengan satu tujuan.
5 November 2026
LLM Medis Mengetahui Revisi Pedoman, tetapi Sering Menjawab Berdasarkan Pedoman Lama
Studi ChronoEvo terhadap 1709 perubahan rekomendasi klinis menunjukkan: pada model utama, 90,8% jawaban mencatat pembaruan, tetapi hanya 58,5% yang menerapkannya sepenuhnya, sementara kesenjangan sebesar 32,3 poin persentase tetap terlihat pada 14 model. Bahkan peningkatan visibilitas pembaruan tidak menghasilkan peningkatan signifikan dalam penerapan penuh aturan baru ke dalam rekomendasi klinis.
4 November 2026