
Zero2Repo बेंचमार्क: खाली डायरेक्टरी से स्वायत्त रूप से प्रोजेक्ट बनाने की सीमाएँ
अध्ययन में कोडिंग एजेंटों का मूल्यांकन पूरे रिपॉज़िटरी को बिल्ड करके करने का प्रस्ताव है: इनपुट में विनिर्देश, इंटरफ़ेस कॉन्ट्रैक्ट और खाली वातावरण हो, जबकि जाँच LLM-जज के बिना छिपे हुए टेस्ट से की जाए। अग्रणी एजेंट भी शायद ही सभी जाँचों में सफल होते हैं, और ज़्यादातर विफलताएँ आवश्यकताओं के कुछ अलग-अलग बिंदुओं के छूट जाने के कारण होती हैं।
Zero2Repo क्या जाँचता है
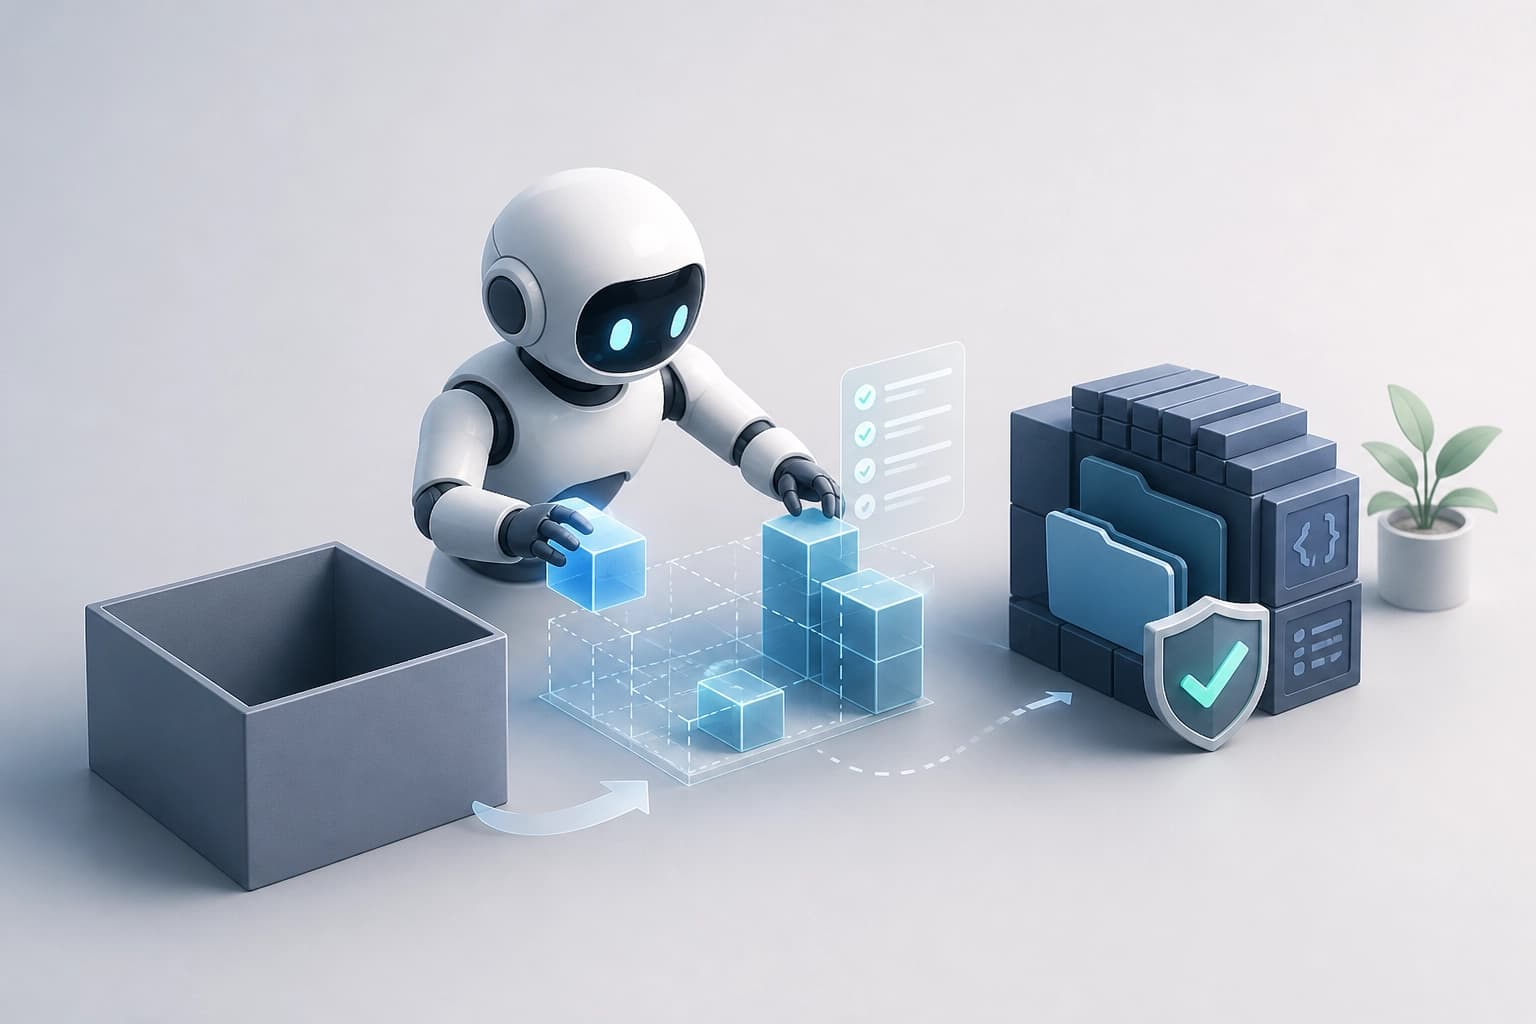
बेंचमार्क यह आकलन करता है कि क्या कोई कोडिंग एजेंट शुरू से एक रिपॉज़िटरी बना सकता है। एजेंट को उत्पाद आवश्यकताओं का दस्तावेज़, इंटरफ़ेस अनुबंध और एक खाली कार्यक्षेत्र दिया जाता है। एजेंट को परियोजना के लिए मूल इकोसिस्टम में एक पूरी रिपॉज़िटरी तैयार करनी होती है।
जाँच पूरी परियोजना के निर्माण को कवर करती है। मूल्यांकन तैयार रिपॉज़िटरी पर आधारित होता है।
- इनपुट: उत्पाद आवश्यकताओं का दस्तावेज़, इंटरफ़ेस अनुबंध, खाली कार्यक्षेत्र।
- आउटपुट: परियोजना के लिए मूल इकोसिस्टम में एक पूरी रिपॉज़िटरी।
- मूल्यांकन का विषय: शुरू से रिपॉज़िटरी बनाने की क्षमता।
निष्कर्ष: बेंचमार्क खाली डायरेक्टरी से स्वायत्त निर्माण की जाँच करता है। व्यावहारिक मानदंड: पूरी परियोजना के निर्माण के कार्यों पर एजेंटों का मूल्यांकन करने के लिए इसका उपयोग करें।
कार्य कैसे बनाए जाते हैं
पाइपलाइन भाषा-निरपेक्ष तरीके से कार्य बनाती है। यह निश्चित संस्करणों वाले वास्तविक ओपन-सोर्स प्रोजेक्ट लेती है। फिर पाइपलाइन उन्हें व्यवहार संबंधी विनिर्देशों, पुनरुत्पादित किए जा सकने वाले वातावरणों और छिपे हुए स्वीकृति परीक्षणों में बदल देती है।
चरण:
- निश्चित संस्करणों वाले वास्तविक ओपन-सोर्स प्रोजेक्ट चुनना।
- उन्हें व्यवहार संबंधी विनिर्देशों में बदलना।
- पुनरुत्पादित किए जा सकने वाले वातावरण तैयार करना।
- छिपे हुए स्वीकृति परीक्षण बनाना।
सत्यापन:
- मूल प्रोजेक्ट का संदर्भ कार्यान्वयन परीक्षणों में सफल होता है।
- प्रतिकूल परीक्षण यह पुष्टि करते हैं कि परीक्षण गलत कार्यान्वयनों को अस्वीकार करते हैं।
निष्कर्ष: कार्य संदर्भ कार्यान्वयन और प्रतिकूल परीक्षण से गुज़रे परीक्षणों पर आधारित होता है। व्यावहारिक मानदंड: केवल कार्य का विवरण नहीं, बल्कि परीक्षणों के सत्यापन की मौजूदगी भी जाँचें।
एजेंट का मूल्यांकन कैसे होता है
बेंचमार्क उत्पादन-स्तर के कोडिंग एजेंटों का मूल्यांकन अलग-थलग कंटेनरों में करता है। समाधान स्पष्ट रूप से सबमिट किए जाने तक स्वीकृति परीक्षण छिपे रहते हैं। पुरस्कार बाइनरी होता है: यह तभी मिलता है जब सभी परीक्षण पास हों। बेंचमार्क LLM जज का उपयोग नहीं करता।
मानदंड:
- एजेंट के लिए अलग-थलग कंटेनर।
- समाधान सबमिट करने तक छिपे हुए परीक्षण।
- सभी परीक्षण पास करने पर बाइनरी पुरस्कार।
- LLM जज का अभाव।
निष्कर्ष: आंशिक रूप से पास हुए परीक्षणों पर कोई पुरस्कार नहीं मिलता। व्यावहारिक मानदंड: एजेंटों की तुलना के लिए ऐसा मूल्यांकन उपयुक्त है जिसमें सफलता के लिए सभी छिपे हुए परीक्षण पास करना ज़रूरी हो।
वर्तमान रिलीज़ की भाषाएँ और दायरा
पाइपलाइन और परीक्षण प्रणाली किसी विशिष्ट प्रोग्रामिंग भाषा को नहीं मानतीं। वर्तमान रिलीज़ में Python, TypeScript, Go और C++ के कार्य शामिल हैं।
रिलीज़ में शामिल भाषाएँ:
- Python.
- TypeScript.
- Go.
- C++.
निष्कर्ष: बेंचमार्क किसी एक भाषा तक सीमित नहीं है, लेकिन कार्यों का वर्तमान सेट चार भाषाओं तक सीमित है। व्यावहारिक मानदंड: परियोजना की भाषा का मिलान रिलीज़ में शामिल भाषाओं से करें।
परिणामों से दिखने वाली सीमाएँ
सीमाएँ 11 कार्यों के सेट में दिखाई देती हैं। ये कार्य उन रिपॉज़िटरी से लिए गए हैं जिनका सामना उन्नत मॉडलों ने प्रशिक्षण के दौरान संभवतः किया होगा।
परिणाम क्या दिखाते हैं:
- सबसे अच्छा एजेंट 11 में से 10 कार्य हल करता है।
- हर असफल सबमिशन 90-99% छिपे हुए परीक्षण पास करता है।
- दो सबसे अच्छे एजेंटों के विफल परीक्षणों में से 67-100% किसी एक छूटे हुए बिंदु या विनिर्देश के किसी दुर्लभ नियम से जुड़े होते हैं।
- विफलता का संबंध विनिर्देश का सटीक पालन करने से है, न कि किसी उपप्रणाली के न होने से।
- लेखक हर ऐसी विफलता को सुधार के एक विशिष्ट लक्ष्य के रूप में बताते हैं।
निष्कर्ष: स्वायत्त निर्माण की सीमा विनिर्देश के दुर्लभ नियमों और पूर्णता को याद रखने में दिखाई देती है। व्यावहारिक मानदंड: यह जाँचें कि एजेंट केवल उपप्रणालियाँ बनाने के बजाय विनिर्देश के दुर्लभ नियमों को कैसे याद रखता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
FedSocket: बहुमाध्यमीय विषमता में प्राप्तकर्ता-पक्ष पर अनिवार्य निष्पादन-क्षमता वाले विनिमेय मॉडल
FedSocket का प्रस्ताव है—एक ऐसा दृष्टिकोण जिसमें साझा किया जाने वाला मॉडल प्राप्तकर्ता की ओर से गणना योग्य होना चाहिए, और विषम निजी मॉडलों को पूर्वानुमानों के साझा इंटरफ़ेस Q से जोड़ा जाता है। लेख में सदस्यता को ध्यान में रखकर किए जाने वाले एग्रीगेशन, केवल Q के पैरामीटर और काउंटरों को अग्रेषित करने, तथा छह डेटासेट पर किए गए प्रयोगों का वर्णन है, जो अनुपलब्ध मॉडैलिटीज़ के बावजूद सटीकता में वृद्धि और स्वतंत्र एन्सेम्बल की तुलना में Joint-इन्फ़रेंस की श्रेष्ठता दर्शाते हैं।
13 नवम्बर 2026
CyberArena: AI एजेंटों के युग्मित मुकाबले स्थिर साइबर बेंचमार्क की सीमाएँ उजागर करते हैं
यह बेंचमार्क दो एजेंटों को लगातार बदलती सेवाओं वाले सैंडबॉक्स में रखता है और कई राउंड के बाद उनके कार्यों को आक्रामक और रक्षात्मक कौशल के बहुआयामी स्कोर में बदलता है। 12 आधुनिक मॉडलों के साथ 466 मैचों में इसने उन क्षमताओं के बीच अंतर पहचाना, जहाँ एकतरफ़ा परीक्षण अपनी सीमा पर पहुँच जाते हैं—जिनमें कई चालों की योजना बनाना और बैकडोर बनाना शामिल है।
13 नवम्बर 2026
पैराफ्रेज़ किए गए मशीन-जनित पाठ के प्रति डिटेक्टरों की मजबूती: परीक्षणों में क्या सामने आया
इस सामग्री में उन टूल्स की जाँच के नतीजे संकलित हैं, जो जनरेट किए गए अंशों को अधिक स्वाभाविक शैली में दोबारा लिखते हैं। इस प्रक्रिया के बाद पहचान की संभावना काफी कम हो जाती है, और बने रहने वाले फ़ॉल्स पॉज़िटिव के कारण डिटेक्टर के निष्कर्ष को प्रमाण नहीं माना जा सकता।
13 नवम्बर 2026