
पैराफ्रेज़ किए गए मशीन-जनित पाठ के प्रति डिटेक्टरों की मजबूती: परीक्षणों में क्या सामने आया
इस सामग्री में उन टूल्स की जाँच के नतीजे संकलित हैं, जो जनरेट किए गए अंशों को अधिक स्वाभाविक शैली में दोबारा लिखते हैं। इस प्रक्रिया के बाद पहचान की संभावना काफी कम हो जाती है, और बने रहने वाले फ़ॉल्स पॉज़िटिव के कारण डिटेक्टर के निष्कर्ष को प्रमाण नहीं माना जा सकता।
पैराफ़्रेज़िंग टेक्स्ट और डिटेक्टर के संकेतों को कैसे बदलती है
मानव-जैसी बनाई गई AI सामग्री मशीन से बना ऐसा टेक्स्ट है, जिसे इस तरह पैराफ़्रेज़ किया गया है कि वह अधिक स्वाभाविक लगे। टूल शब्दों के चुनाव, वाक्यों की लंबाई और लहजे को बदलते हैं। कुछ टूल असमान लय जोड़ते हैं या टेक्स्ट को बार-बार नए रूप में लिखते हैं। ऐसे बदलाव उन संकेतों को बदल देते हैं जिन पर डिटेक्टर निर्भर करते हैं: शब्दों की पूर्वानुमेयता और वाक्यों की लंबाई में विविधता।
- शब्दों का चुनाव;
- वाक्यों की लंबाई;
- लहजा;
- असमान लय;
- बार-बार दोबारा लिखना।
निष्कर्ष: पैराफ़्रेज़िंग ठीक उन्हीं विशेषताओं को बदलती है जिनके आधार पर डिटेक्टर मशीन से बने टेक्स्ट की पहचान करते हैं।
पैराफ़्रेज़ किए गए टेक्स्ट के परीक्षणों से क्या पता चला
इन परीक्षणों में यह जाँचा गया कि पैराफ़्रेज़िंग के बाद डिटेक्टर अपनी विश्वसनीयता बनाए रखते हैं या नहीं। 2025 के एक अध्ययन में टेक्स्ट को मानव-जैसा बनाने और पैराफ़्रेज़ करने वाले 19 टूल शामिल थे।
| परीक्षण | परिणाम |
|---|---|
| 2025 का अध्ययन, 19 टूल | कई डिटेक्टर मानव-जैसे बनाए गए टेक्स्ट को पहचान नहीं पाते। |
| Google Research | पैराफ़्रेज़िंग मॉडल अर्थ को बनाए रखता है और काफी हद तक पहचान से बच निकलता है। |
| ChatGPT के टेक्स्ट को QuillBot से पैराफ़्रेज़ करना | ChatGPT के टेक्स्ट पर डिटेक्टर की सटीकता घटकर 49% रह गई। |
| एक अन्य परीक्षण | ChatGPT के पैराफ़्रेज़ किए गए टेक्स्ट ने हर डिटेक्टर को कम-से-कम आधे मामलों में चकमा दिया। |
| Stanford, साहित्यिक भाषा | ChatGPT को अधिक साहित्यिक भाषा इस्तेमाल करने के लिए कहने पर AI टेक्स्ट की पहचान 100% से घटकर 13% रह गई। |
निष्कर्ष: मशीन से बने पैराफ़्रेज़ किए गए टेक्स्ट के प्रति डिटेक्टरों की विश्वसनीयता कम है।
डिटेक्टर टेक्स्ट में क्या पहचानते हैं
डिटेक्टर ऐसे संकेतों पर निर्भर करते हैं जो हमेशा यह नहीं बताते कि टेक्स्ट मशीन से बना है। Carnegie Mellon के शोधकर्ताओं ने पाया कि बुनियादी मॉडलों का टेक्स्ट अक्सर GPTZero और Pangram को मानव-लिखित लगता था। निर्देशों का पालन करने के लिए अतिरिक्त प्रशिक्षण दिए गए मॉडलों का टेक्स्ट ऐसा नहीं लगता था। टीम का मानना है कि डिटेक्टर मशीन-लेखन के विश्वसनीय संकेतों के बजाय मॉडल के प्रशिक्षण के निशान पहचानते हैं।
- बुनियादी मॉडल: GPTZero और Pangram को उनका टेक्स्ट अक्सर मानव-लिखित लगता है;
- निर्देशों का पालन करने के लिए अतिरिक्त प्रशिक्षण दिए गए मॉडल: उनका टेक्स्ट ऐसा नहीं लगता;
- टीम का निष्कर्ष: डिटेक्टर प्रशिक्षण के निशान पहचानते हैं।
Stanford ने उन लेखकों के 91 निबंधों पर सात डिटेक्टरों को परखा जिनकी मातृभाषा अंग्रेज़ी नहीं थी। गलत पहचान का औसत स्तर 61,3% रहा। कम-से-कम एक टूल ने 91% से अधिक निबंधों को चिह्नित किया। जिन लेखकों की मातृभाषा अंग्रेज़ी थी, उनके निबंधों के लिए यह आँकड़ा लगभग शून्य था। शोधकर्ता इस अंतर को शब्दों के सरल और पूर्वानुमेय चुनाव से जोड़ते हैं, जिसे डिटेक्टर मशीन से बना टेक्स्ट समझ लेते हैं।
निष्कर्ष: डिटेक्टर का संकेत इस बात का प्रमाण नहीं है कि टेक्स्ट मशीन से बना है, इसलिए उसका आकलन संदर्भ के साथ करना ज़रूरी है।
दावा की गई सटीकता और वास्तविक सीमाएँ
स्वतंत्र और निर्माताओं द्वारा किए गए परीक्षणों में सटीकता के अलग-अलग आँकड़े मिलते हैं। जाँच की परिस्थितियाँ परिणाम बदल देती हैं।
- स्वतंत्र परीक्षणों की समीक्षा: Turnitin, GPTZero और Originality.ai की सटीकता 70%–85% है। इन टूल में गलत पहचान की समस्या बनी रहती है।
- Turnitin 98% सटीकता और 1% से कम गलत पहचान का दावा करता है। यह दावा केवल उन दस्तावेज़ों पर लागू होता है जिनमें 20% से अधिक टेक्स्ट AI ने बनाया हो।
- OpenAI ने जुलाई 2023 में अपना वर्गीकरण टूल बंद कर दिया था। वह AI द्वारा बनाए गए टेक्स्ट में से केवल 26% की पहचान कर पाता था।
- 2025 के अध्ययन के लेखकों ने मानव-जैसे बनाए गए नमूनों पर एक मॉडल को प्रशिक्षित किया। मॉडल ने गलत पहचान का स्तर कम रखते हुए ऐसे टेक्स्ट की पहचान की। उसे चकमा देने की कोशिशों के बावजूद वह प्रभावी रहा। मॉडल के लेखकों ने ही ये परिणाम हासिल किए थे; स्वतंत्र परीक्षणों की ज़रूरत है।
निष्कर्ष: दावा की गई सटीकता जाँच की परिस्थितियों पर निर्भर करती है, और स्वतंत्र परीक्षण पहचान की सीमाएँ दिखाते हैं।
डिटेक्टर के नतीजे का व्यावहारिक आकलन
विशेषज्ञ सलाह देते हैं कि डिटेक्टर के नतीजे को प्रमाण नहीं, बल्कि एक संकेत मानें। जाँच के लिए मसौदों का इतिहास देखा जा सकता है, छोटे मौखिक सवाल पूछे जा सकते हैं और कक्षा में किए गए काम से तुलना की जा सकती है। लेखकों और प्रकाशकों को विशेषज्ञ स्रोत, साक्षात्कार और मूल डेटा माँगने की सलाह देते हैं।
- मसौदों का इतिहास;
- छोटे मौखिक सवाल;
- कक्षा में किए गए काम से तुलना;
- लेखकों और प्रकाशकों के लिए स्रोत, साक्षात्कार और मूल डेटा।
व्यावहारिक मानदंड: डिटेक्टर अतिरिक्त जाँच का संकेत है, निष्कर्ष निकालने का एकमात्र आधार नहीं।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
FedSocket: बहुमाध्यमीय विषमता में प्राप्तकर्ता-पक्ष पर अनिवार्य निष्पादन-क्षमता वाले विनिमेय मॉडल
FedSocket का प्रस्ताव है—एक ऐसा दृष्टिकोण जिसमें साझा किया जाने वाला मॉडल प्राप्तकर्ता की ओर से गणना योग्य होना चाहिए, और विषम निजी मॉडलों को पूर्वानुमानों के साझा इंटरफ़ेस Q से जोड़ा जाता है। लेख में सदस्यता को ध्यान में रखकर किए जाने वाले एग्रीगेशन, केवल Q के पैरामीटर और काउंटरों को अग्रेषित करने, तथा छह डेटासेट पर किए गए प्रयोगों का वर्णन है, जो अनुपलब्ध मॉडैलिटीज़ के बावजूद सटीकता में वृद्धि और स्वतंत्र एन्सेम्बल की तुलना में Joint-इन्फ़रेंस की श्रेष्ठता दर्शाते हैं।
13 नवम्बर 2026
CyberArena: AI एजेंटों के युग्मित मुकाबले स्थिर साइबर बेंचमार्क की सीमाएँ उजागर करते हैं
यह बेंचमार्क दो एजेंटों को लगातार बदलती सेवाओं वाले सैंडबॉक्स में रखता है और कई राउंड के बाद उनके कार्यों को आक्रामक और रक्षात्मक कौशल के बहुआयामी स्कोर में बदलता है। 12 आधुनिक मॉडलों के साथ 466 मैचों में इसने उन क्षमताओं के बीच अंतर पहचाना, जहाँ एकतरफ़ा परीक्षण अपनी सीमा पर पहुँच जाते हैं—जिनमें कई चालों की योजना बनाना और बैकडोर बनाना शामिल है।
13 नवम्बर 2026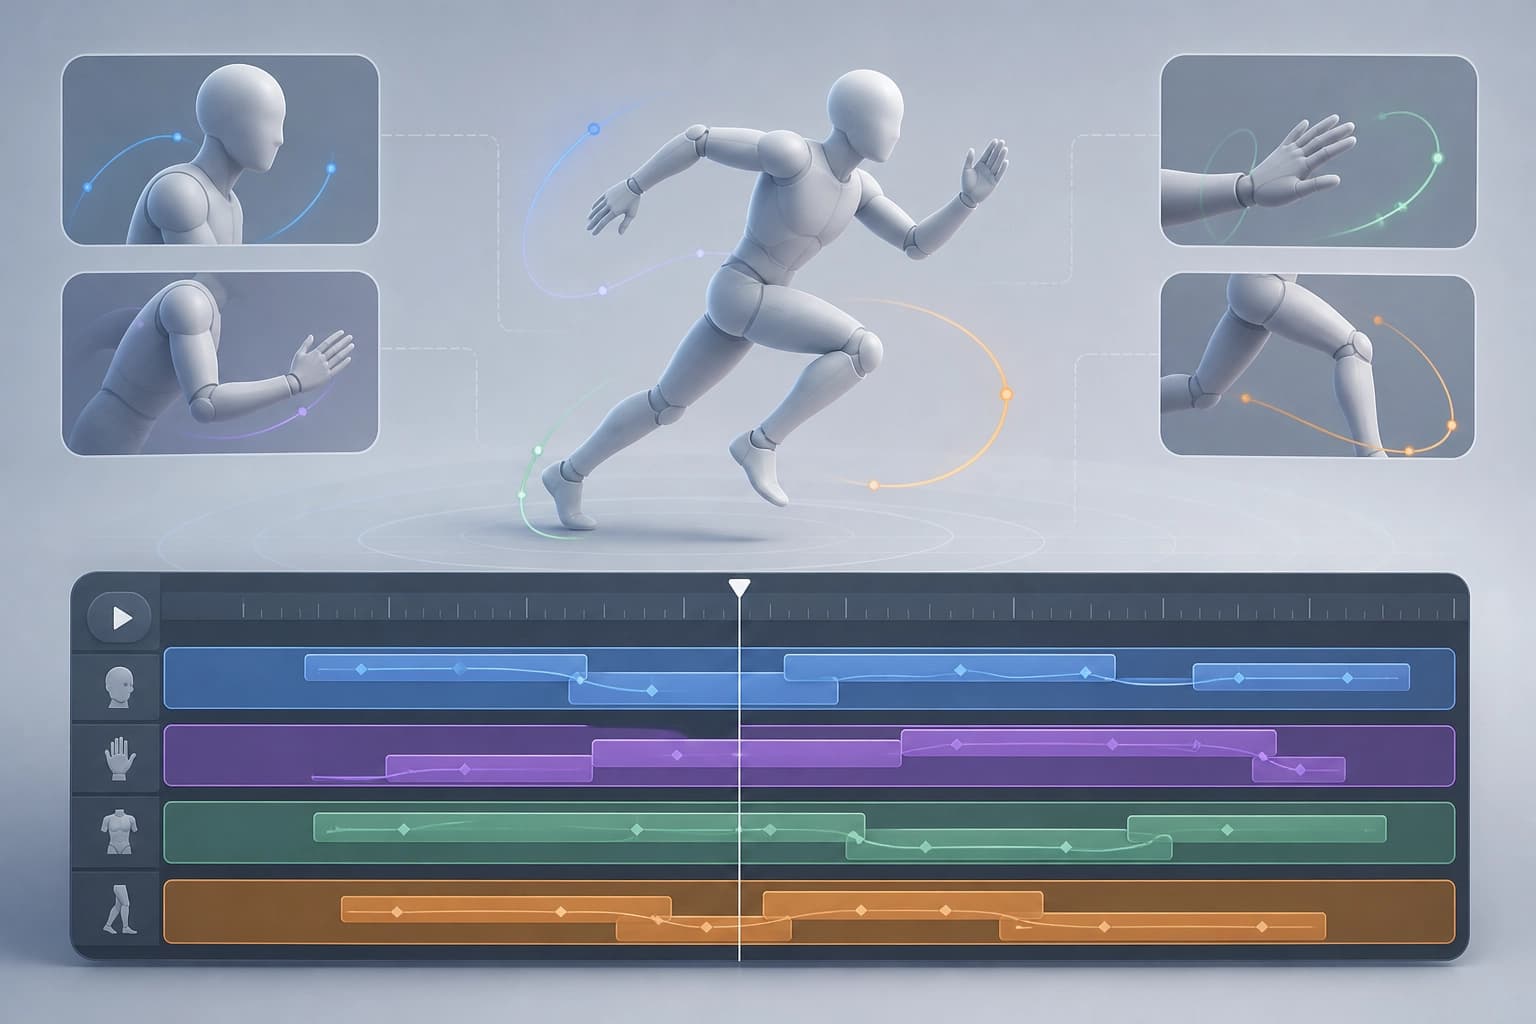
सिंथेसिस के दौरान नए कमांड: 3D मानव गतियों के लिए मल्टी-ट्रैक टाइमलाइन
एक ऐसी विधि प्रस्तावित की गई है, जो संश्लेषण के दौरान ही नए टेक्स्ट निर्देश स्वीकार करती है और क्रियाओं के परस्पर अतिव्यापी अंतरालों को स्वतंत्र रूप से निर्धारित करने देती है। शरीर के विभिन्न अंगों की एक साथ होने वाली गतिविधियों का समन्वय अंतराल-आधारित कंडीशनिंग और शरीर के अंगों को ध्यान में रखने वाली डिनॉइज़िंग प्रक्रिया के ज़रिए किया जाता है; TimelineMotion और MTT पर लेखक बताते हैं कि स्ट्रीमिंग बेसलाइन समाधानों की तुलना में यह अर्थ और समय-संबंधी सीमाओं के साथ बेहतर मेल खाता है।
12 नवम्बर 2026