लंबे शोध: समस्या एक ही प्रश्न में नहीं है
एक स्वायत्त शोधकर्ता सामान्य चैट-एजेंट की तुलना में एक अलग वास्तविकता में रहता है। उसे एक परिकल्पना प्रस्तावित करनी होती है, उसका परीक्षण करना होता है, त्रुटि ढूंढनी होती है, स्क्रिप्ट को फिर से लिखना होता है, प्रयोग चलाना होता है, और कभी-कभी मॉडल के पिछले संस्करण पर वापस जाना भी पड़ता है। ऐसा चक्र घंटों तक चल सकता है, और प्रत्येक चरण का मूल्य अंत में ही स्पष्ट होता है।
अधिकांश ऑटो-रिसर्च एजेंटों के लिए यह मुश्किल है। निरंतरता के तंत्र लगभग नहीं हैं: यदि प्रयोग गतिरोध में पहुँच जाता है, तो एजेंट नहीं जानता कि खोए हुए सूत्र को कैसे पुनर्स्थापित किया जाए। वर्तमान परिणाम की उपयोगिता के आधार पर कंप्यूटेशन को पुनर्वितरित करने का कोई कार्य भी नहीं है। परिणामस्वरूप, खोज ढीली हो जाती है, कंप्यूटेशनल संसाधन बर्बाद होते हैं, और काम को पूरा करने की संभावना कम हो जाती है।
नया दृष्टिकोण कैसे काम करता है
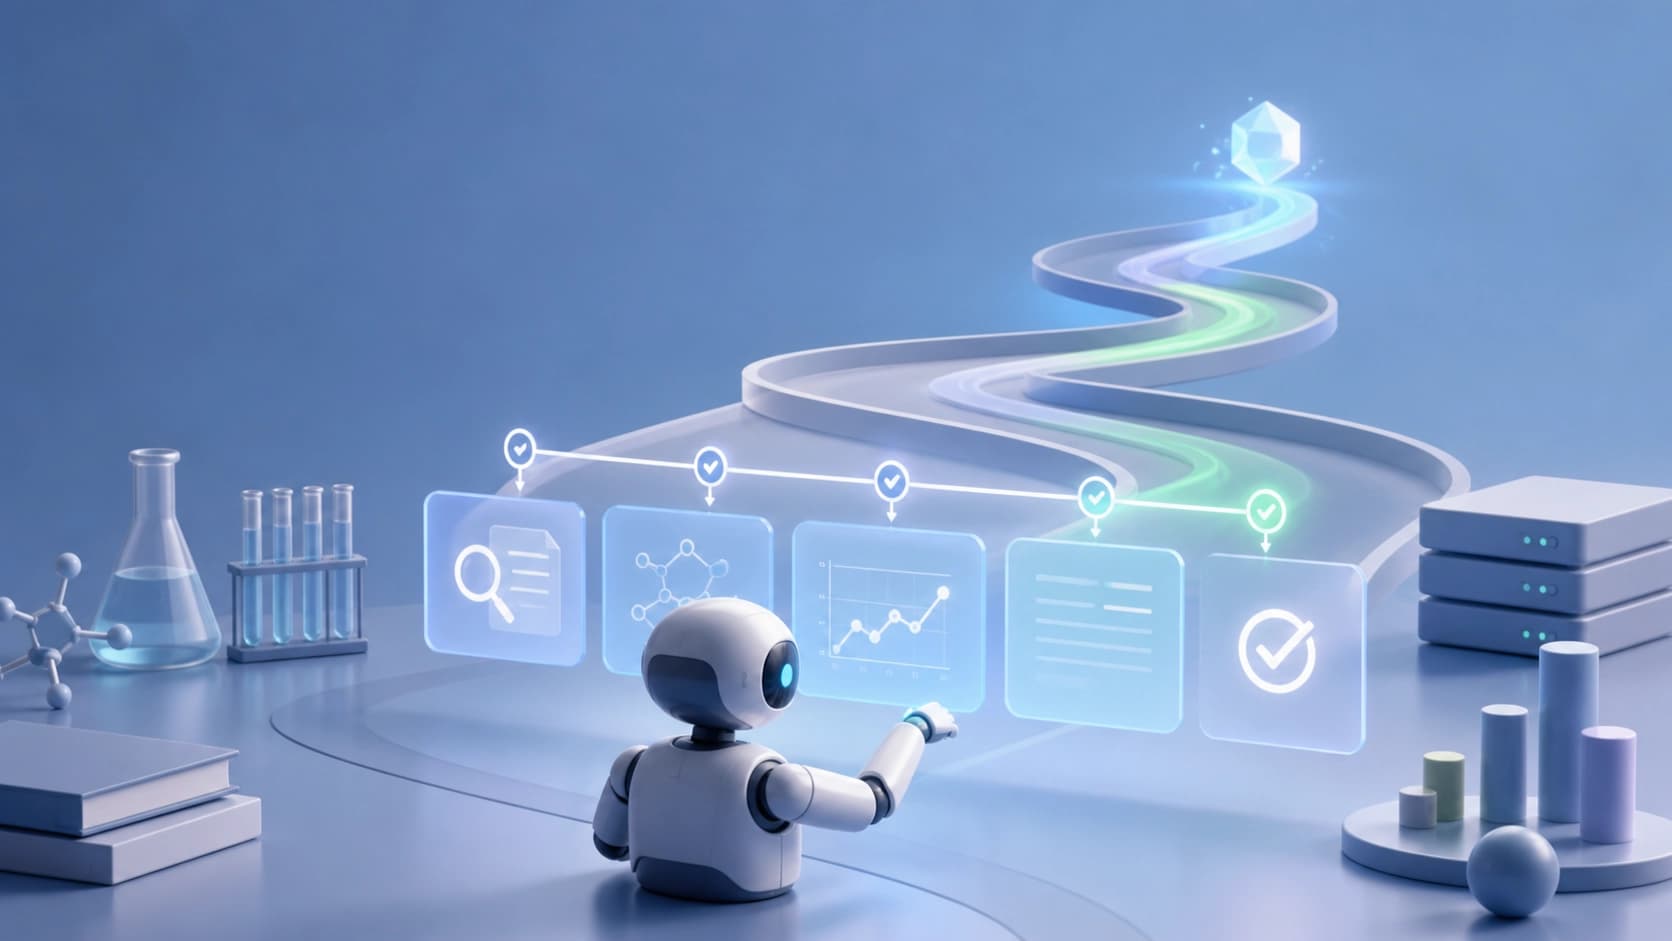
ScienceFlow फ्रेमवर्क इन्हीं समस्याओं को हल करता है। इसके लेखक — 19 शोधकर्ताओं की एक टीम — ने स्वायत्त वैज्ञानिक प्रयोगों के लिए एक एंड-टू-एंड आर्किटेक्चर प्रस्तुत किया। एजेंट "एक प्रॉम्प्ट पर" कार्य नहीं करता: वह एक लंबा शोध प्रक्षेपवक्र बनाता है।
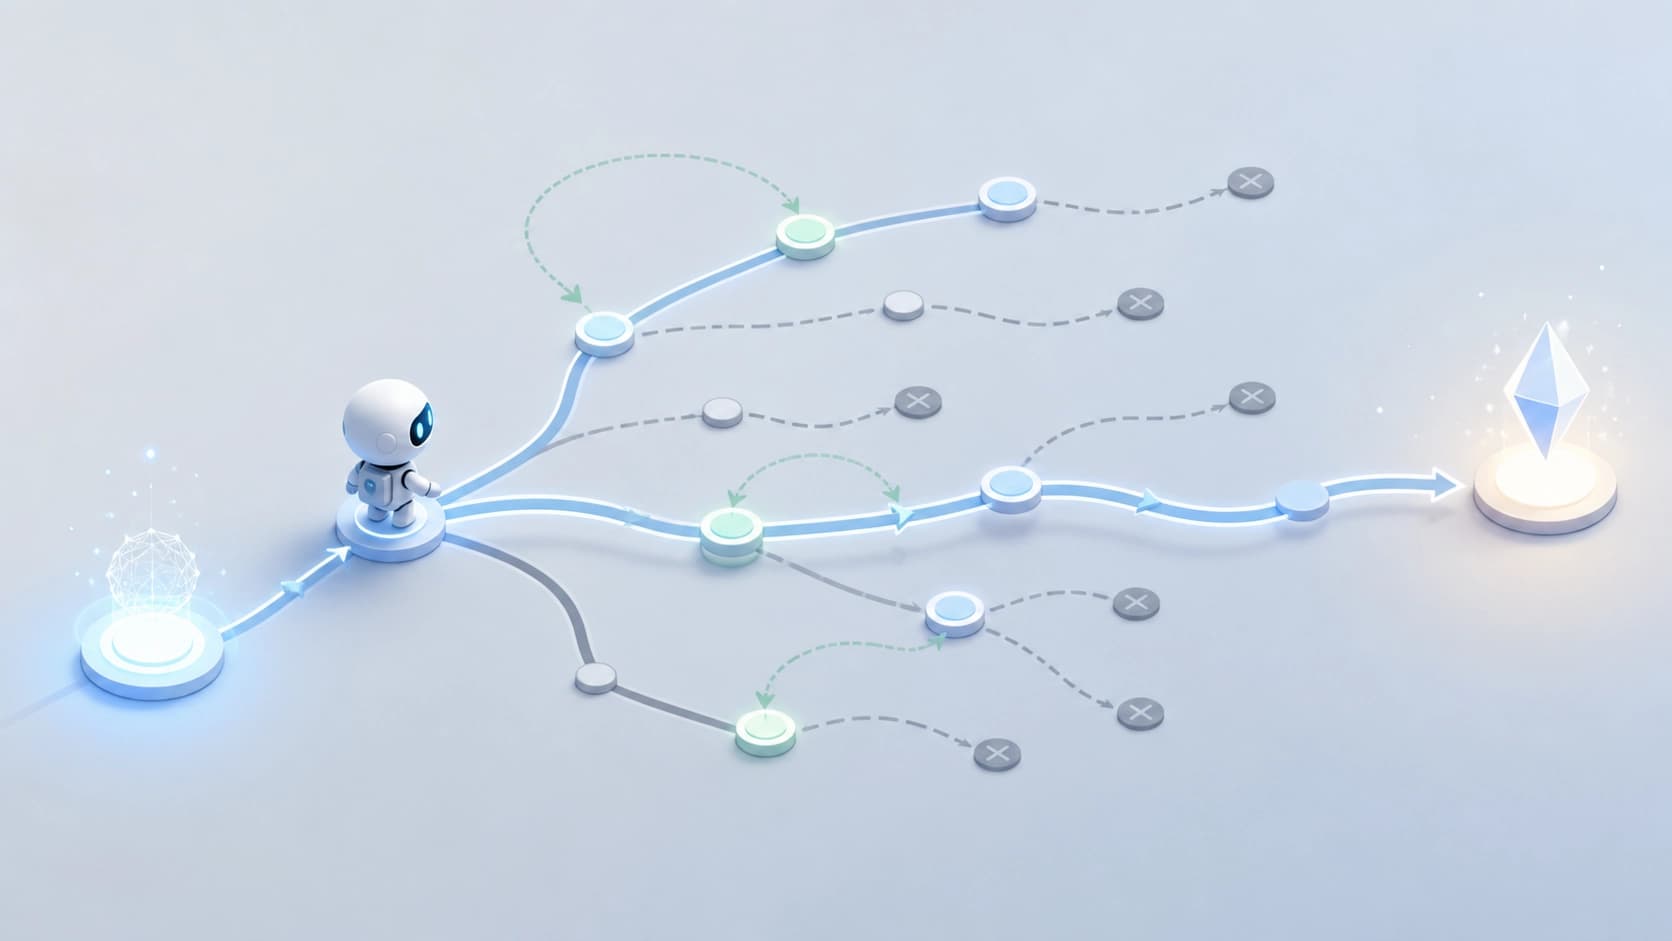
अंदर, काम को शोध खंडों में विभाजित किया गया है। प्रत्येक खंड एक निष्पादन योग्य कार्यक्षेत्र से जुड़ा होता है: स्क्रिप्ट, डेटा और वातावरण वहाँ रहते हैं। शोध की प्रगति बिखरे हुए पाठ्य नोट्स नहीं है, बल्कि एक पुनर्स्थापनीय निष्पादन योग्य स्थिति है। ऐसी स्थिति को डिस्क से "उठाया" जा सकता है, फिर से जांचा जा सकता है, फिर से इकट्ठा किया जा सकता है और फिर से चलाया जा सकता है। इसके लिए धन्यवाद, एजेंट आसानी से पिछले बिंदु पर लौट सकता है और एक अलग शाखा आज़मा सकता है, न कि सब कुछ फिर से शुरू कर सकता है।
ESTRA: अगला मोड़ कैसे चुनें
मुख्य विवरण ESTRA (Executable-State Transition through Re-Anchoring) तंत्र के माध्यम से राज्यों के बीच संक्रमण है। प्रत्येक चरण पर, एजेंट दो प्रकार की स्थितियों को देखता है: सक्रिय, जहाँ अभी जारी रखा जा सकता है, और संग्रहीत, जो पहले ही कुछ परिणाम दे चुकी हैं। लेकिन वह सिर्फ एक नया बिंदु नहीं चुनता, बल्कि आगे की गति के लिए एक एंकर चुनता है। फिर एक परिदृश्य निर्धारित किया जाता है: उस स्थिति से आगे बढ़ना जारी रखना या शोध को दूसरी दिशा में मोड़ना।
यह दृष्टिकोण लंबे प्रयोगों की मुख्य समस्या को दूर करता है — "फँसे हुए" एजेंट का प्रभाव, जो एक निराशाजनक शाखा में गहराई तक जाता रहता है क्योंकि वह नहीं जानता कि पीछे कैसे हटना है।
परिणामों के आधार पर निष्पादन नियंत्रक
फ्रेमवर्क की एक और परत — पुष्टि किए गए परिणामों को ध्यान में रखते हुए नियंत्रक। यह तीन कारकों के आधार पर व्यक्तिगत कंप्यूटिंग कार्यों के बीच संसाधनों को वितरित करता है: क्षमताओं की उपलब्धता, शेष बजट, और पहले से पुष्टि की गई प्रगति। यदि कोई दिशा मापने योग्य परिणाम देना बंद कर देती है, तो नियंत्रक उसका हिस्सा कम कर सकता है और संसाधनों को वहाँ पुनर्निर्देशित कर सकता है जहाँ वास्तविक गति दिखाई देती है। यह एक "लालची" कार्य शेड्यूलर नहीं है, बल्कि समग्र रणनीति को लक्ष्य के भीतर बनाए रखने का एक तरीका है।
परीक्षणों ने क्या दिखाया
परीक्षणों में, फ्रेमवर्क ने न केवल क्लासिक मशीन लर्निंग को कवर किया, बल्कि वैज्ञानिक मॉडलिंग और गणितीय अनुकूलन को भी कवर किया। प्राप्त परिणाम बताते हैं कि सिस्टम लंबे शोध सत्रों को उत्पादक रूप से संचालित करने में सक्षम है, बिना उन्हें असंबंधित चरणों की अंतहीन श्रृंखला में बदले।
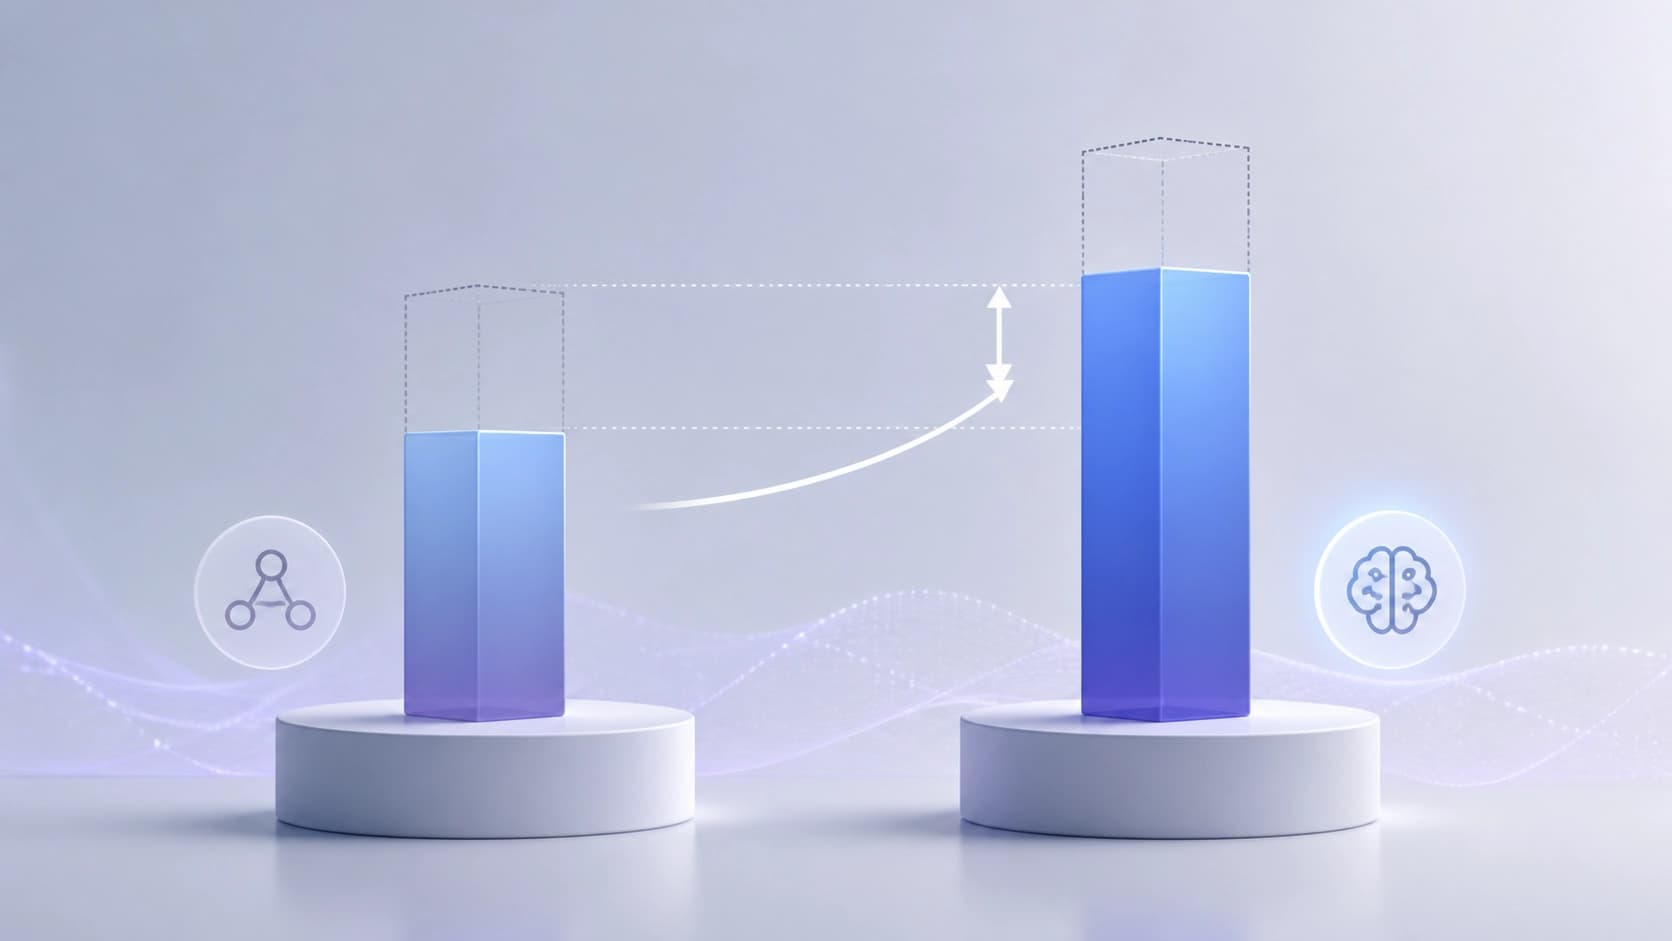
सबसे उल्लेखनीय परिणाम — 24-घंटे के बजट के भीतर पूर्ण MLE-bench पर: Any-Medal मीट्रिक पर 70.22%। यह पिछले प्रकाशित आंकड़ों से 4.92 प्रतिशत अंक अधिक है। यह देखते हुए कि MLE-bench वास्तविक मशीन लर्निंग परिदृश्यों का परीक्षण करता है, यह एक मजबूत संकेत है: प्रक्रिया की स्थिरता कभी-कभी मॉडल की मूल बुद्धि से अधिक महत्वपूर्ण होती है।
स्वायत्त विज्ञान के लिए इसका क्या अर्थ है
लेख के लेखक एक महत्वपूर्ण निष्कर्ष निकालते हैं: स्वायत्त शोध को बढ़ाने के लिए, राज्य प्रबंधन, अनुकूली अन्वेषण और लक्ष्य के साथ संरेखित निष्पादन का निर्णायक महत्व है। केवल खूबसूरती से तर्क करने की क्षमता पर्याप्त नहीं है — एक ऐसे बुनियादी ढांचे की आवश्यकता है जो एजेंट को पिछली उपलब्धियों को खोने से रोके और समय पर मुड़ने में मदद करे।
ऐसा लगता है कि यह LLM-सहायकों से वास्तविक स्वायत्त अनुसंधान प्रणालियों की ओर अगला कदम है। लंबे क्षितिज पर काम करना "मॉडल के साथ छोटी बातचीत" नहीं रह जाता और एक इंजीनियरिंग चुनौती बन जाता है: एक ऐसी प्रक्रिया कैसे बनाई जाए जिसमें प्रयोग का हर संस्करण सुलभ रहे, हर परिणाम सत्यापित हो, और हर अगला कदम पुष्टि की गई प्रगति से उत्पन्न हो।