
RLTLDR: एजेंट असफलता से खुद निष्कर्ष निकालता है और अगले प्रयास में उसे ध्यान में रखता है
विफलता के बाद, एजेंट को वेरिफ़ायर का संकेत दिखाया जाता है और उसे एक संकेत में संक्षिप्त करने को कहा जाता है; प्रशिक्षण «कार्य — संकेत» के जोड़ों पर होता है, बिना शिक्षक और संदर्भ समाधानों के। प्रोग्रामिंग और टूल कॉल के कठिन बेंचमार्क पर, यह विधि GRPO के 0–1% Pass@1 को बढ़ाकर 12–31% तक पहुँचा देती है, और इसका निर्णायक योगदान ठीक ऐसे जोड़े को आत्मसात करने से आता है।
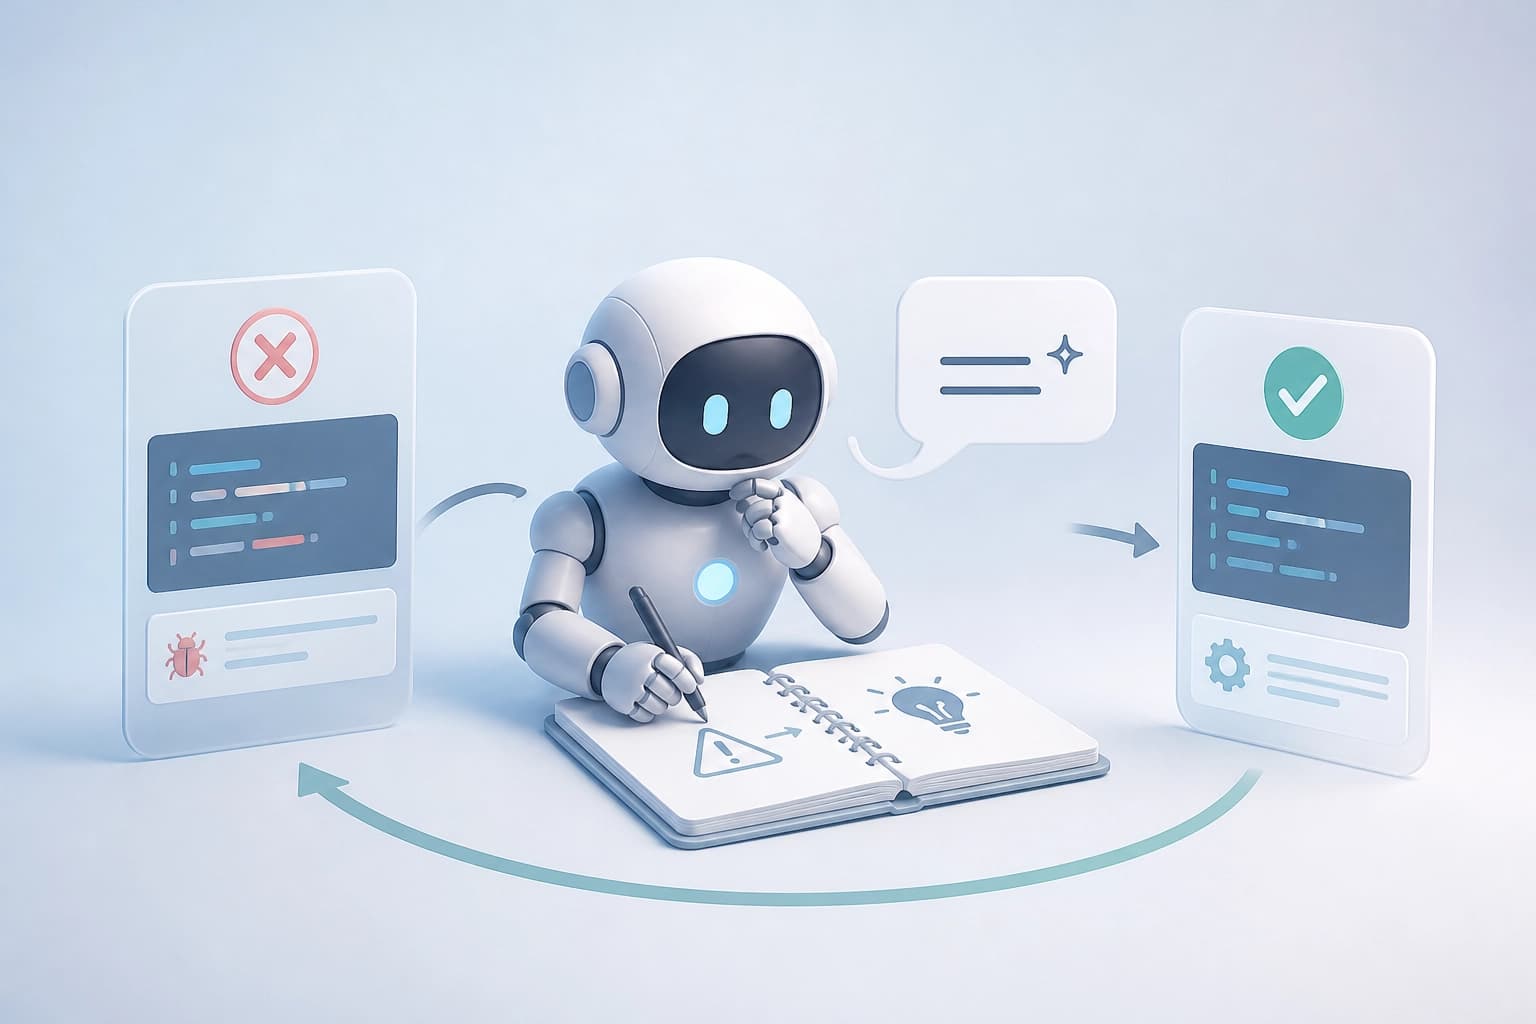
RLTLDR उन कार्यों में एजेंट के आत्म-सुधार की एक विधि है, जहाँ सफलता हासिल करना कठिन होता है। असफल प्रयास के बाद एजेंट वेरिफ़ायर का आउटपुट देखता है और स्वयं एक संक्षिप्त निष्कर्ष — TL;DR insight — तैयार करता है। अगला प्रयास पिछले सभी निष्कर्षों को ध्यान में रखता है। Michael Kirchhof, Eleonora Gualdoni, Andrew Szot और सह-लेखकों का काम इस दृष्टिकोण का वर्णन करता है। पहला संस्करण 29 सितंबर 2026 को जमा किया गया। नवीनतम संशोधन 19 अक्टूबर 2026 का है।
RLTLDR जिस समस्या का समाधान करता है
RLTLDR का लक्ष्य एजेंट का आत्म-सुधार है। ऐसे कार्यों में एजेंट के लिए सफलता हासिल करना कठिन होता है। डिस्टिलेशन के लिए शिक्षक मॉडल और समाधान के उदाहरण उपलब्ध नहीं होते। इसलिए विफलता और वेरिफ़ायर का आउटपुट फ़ीडबैक का स्रोत बनते हैं।
कार्य की शर्तें:
- कोई शिक्षक मॉडल नहीं;
- डिस्टिलेशन के लिए समाधान के उदाहरण नहीं;
- एजेंट के लिए सफलता हासिल करना कठिन;
- विफलता के बाद वेरिफ़ायर का आउटपुट उपलब्ध।
निष्कर्ष: RLTLDR उन स्थितियों में उपयोगी है जहाँ तैयार समाधान और शिक्षक उपलब्ध नहीं हैं, लेकिन विफलता की जाँच की जा सकती है। व्यावहारिक कसौटी यह है कि ऐसा वेरिफ़ायर मौजूद हो जिसका आउटपुट एजेंट को दिया जा सके।
चक्र कैसे काम करता है
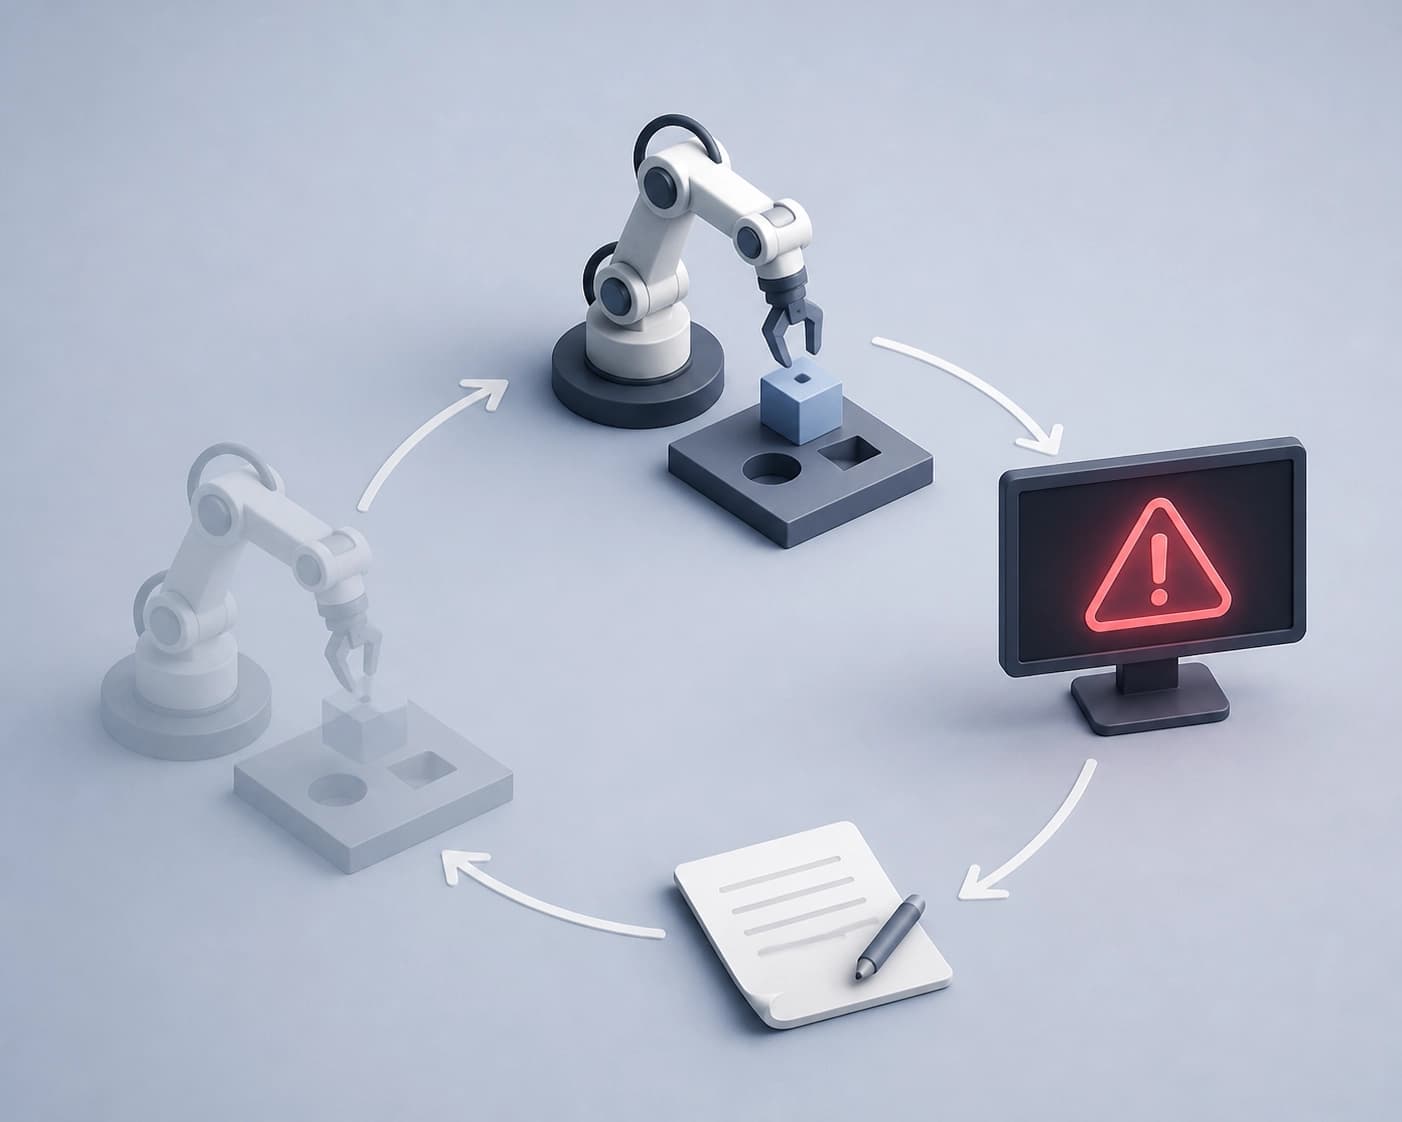
RLTLDR चक्र लगातार किए जाने वाले प्रयासों पर आधारित है। हर विफलता अगले चरण के लिए सामग्री देती है।
चरण:
- एजेंट एक rollout करता है और विफल हो जाता है।
- एजेंट वेरिफ़ायर का आउटपुट देखता है।
- एजेंट अपना फ़ीडबैक तैयार करता है — एक संक्षिप्त TL;DR insight।
- अगला rollout पिछले सभी निष्कर्षों को ध्यान में रखता है।
- समाधान मिलने तक rollouts लगातार चलते रहते हैं।
- संदर्भ में मौजूद निष्कर्षों पर backpropagation के साथ प्रशिक्षण «कार्य → निष्कर्ष» के संबंध को आत्मसात करता है।
निष्कर्ष: चक्र का मूल्य सिर्फ़ अगले प्रयास के लिए संकेत देने में नहीं है। मुख्य कारक कार्य और निष्कर्ष के बीच संबंध को आत्मसात करना है।
कठिन कार्यों पर परिणाम
परीक्षण tool-calling और coding के कठिन बेंचमार्क पर किए गए। लेखकों ने Pass@128=0 की शर्त के आधार पर बेंचमार्क फ़िल्टर किए। तुलना Qwen 3.5 9B Thinking नीति पर की गई।
| दृष्टिकोण | मूल्यांकन की शर्तें | Pass@1 |
|---|---|---|
| मानक GRPO प्रशिक्षण | वर्णित निष्कर्ष चक्र के बिना | 0–1% |
| RLTLDR | प्रशिक्षण के दौरान संदर्भ में निष्कर्ष | 14–31% |
| RLTLDR | मूल्यांकन के दौरान संदर्भ में निष्कर्ष नहीं | 12–13% |
मानक GRPO प्रशिक्षण Pass@1 के 0% से 1% के स्तर पर बना रहता है। प्रशिक्षण के दौरान संदर्भ में निष्कर्ष मौजूद होने पर RLTLDR 14–31% तक पहुँचता है। मूल्यांकन के दौरान संदर्भ में निष्कर्ष न होने पर परिणाम 12–13% होता है। लेखक «कार्य → निष्कर्ष» के संबंध को आत्मसात करने को मुख्य कारक बताते हैं।
निष्कर्ष: संदर्भ में निष्कर्ष होने से Pass@1 बढ़ता है। आत्मसात करने की जाँच के लिए विधि का मूल्यांकन निष्कर्षों के साथ और उनके बिना, दोनों स्थितियों में करना चाहिए।
SFTLDR: «कार्य — निष्कर्ष» युग्मों पर प्रशिक्षण
SFTLDR प्रशिक्षण का एक संक्षिप्त विकल्प है। यह केवल (कार्य, निष्कर्ष) युग्मों पर सीखता है। इसमें rollouts और उन पर backpropagation का उपयोग नहीं किया जाता।
SFTLDR के बारे में ज्ञात बातें:
- प्रशिक्षण केवल (कार्य, निष्कर्ष) युग्मों पर होता है;
- SFTLDR rollouts नहीं दिखाता;
- SFTLDR rollouts पर backpropagation लागू नहीं करता;
- ऐसे 4k युग्मों पर प्रशिक्षण RLTLDR के लगभग पूरे प्रदर्शन को बहाल कर देता है;
- SFTLDR पूर्ण rollouts पर पारंपरिक SFT के प्रदर्शन के लगभग बराबर पहुँचता है;
- लेखक इस दृष्टिकोण को एक संक्षिप्त प्रतिमान के रूप में वर्णित करते हैं: «इस तरह के कार्यों के लिए इस तरह की बातें ध्यान में रखो»।
निष्कर्ष: SFTLDR संक्षिप्त प्रशिक्षण का एक विकल्प है। कसौटी: इसे उन स्थितियों में जाँचें जहाँ «कार्य — निष्कर्ष» युग्म जुटाए जा सकते हैं।
लागू होने के मानदंड
RLTLDR के लिए जाँचा जा सकने वाला फ़ीडबैक और लगातार किए जाने वाले प्रयास ज़रूरी हैं। इन शर्तों के बिना चक्र नहीं बनाया जा सकता। नीचे दिए गए मानदंड लागू होने की संभावना का आकलन करने में मदद करते हैं।
मानदंड:
- कार्य में असफल प्रयास और दोबारा rollouts की गुंजाइश हो;
- ऐसा वेरिफ़ायर हो जिसका आउटपुट एजेंट को दिखाया जा सके;
- एजेंट एक संक्षिप्त निष्कर्ष तैयार कर सके;
- अगला प्रयास पिछले सभी निष्कर्षों को ध्यान में रखे;
- यदि आत्मसात करने की जाँच महत्वपूर्ण हो, तो मूल्यांकन में संदर्भ में निष्कर्षों के बिना वाला मोड भी शामिल हो।
निष्कर्ष: RLTLDR उन कार्यों के लिए चुनें जहाँ वेरिफ़ायर मौजूद हो और सफलता हासिल करना कठिन हो। संक्षिप्त «कार्य — निष्कर्ष» युग्म-आधारित प्रशिक्षण चाहिए तो SFTLDR चुनें।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
FedSocket: बहुमाध्यमीय विषमता में प्राप्तकर्ता-पक्ष पर अनिवार्य निष्पादन-क्षमता वाले विनिमेय मॉडल
FedSocket का प्रस्ताव है—एक ऐसा दृष्टिकोण जिसमें साझा किया जाने वाला मॉडल प्राप्तकर्ता की ओर से गणना योग्य होना चाहिए, और विषम निजी मॉडलों को पूर्वानुमानों के साझा इंटरफ़ेस Q से जोड़ा जाता है। लेख में सदस्यता को ध्यान में रखकर किए जाने वाले एग्रीगेशन, केवल Q के पैरामीटर और काउंटरों को अग्रेषित करने, तथा छह डेटासेट पर किए गए प्रयोगों का वर्णन है, जो अनुपलब्ध मॉडैलिटीज़ के बावजूद सटीकता में वृद्धि और स्वतंत्र एन्सेम्बल की तुलना में Joint-इन्फ़रेंस की श्रेष्ठता दर्शाते हैं।
13 नवम्बर 2026
पैराफ्रेज़ किए गए मशीन-जनित पाठ के प्रति डिटेक्टरों की मजबूती: परीक्षणों में क्या सामने आया
इस सामग्री में उन टूल्स की जाँच के नतीजे संकलित हैं, जो जनरेट किए गए अंशों को अधिक स्वाभाविक शैली में दोबारा लिखते हैं। इस प्रक्रिया के बाद पहचान की संभावना काफी कम हो जाती है, और बने रहने वाले फ़ॉल्स पॉज़िटिव के कारण डिटेक्टर के निष्कर्ष को प्रमाण नहीं माना जा सकता।
13 नवम्बर 2026
CyberArena: AI एजेंटों के युग्मित मुकाबले स्थिर साइबर बेंचमार्क की सीमाएँ उजागर करते हैं
यह बेंचमार्क दो एजेंटों को लगातार बदलती सेवाओं वाले सैंडबॉक्स में रखता है और कई राउंड के बाद उनके कार्यों को आक्रामक और रक्षात्मक कौशल के बहुआयामी स्कोर में बदलता है। 12 आधुनिक मॉडलों के साथ 466 मैचों में इसने उन क्षमताओं के बीच अंतर पहचाना, जहाँ एकतरफ़ा परीक्षण अपनी सीमा पर पहुँच जाते हैं—जिनमें कई चालों की योजना बनाना और बैकडोर बनाना शामिल है।
13 नवम्बर 2026