
उम्मीदवारों का सत्यापन उन्हें उत्पन्न करने से अधिक महँगा है: LLM-आधारित भेद्यता खोज के विरुद्ध प्रलोभन
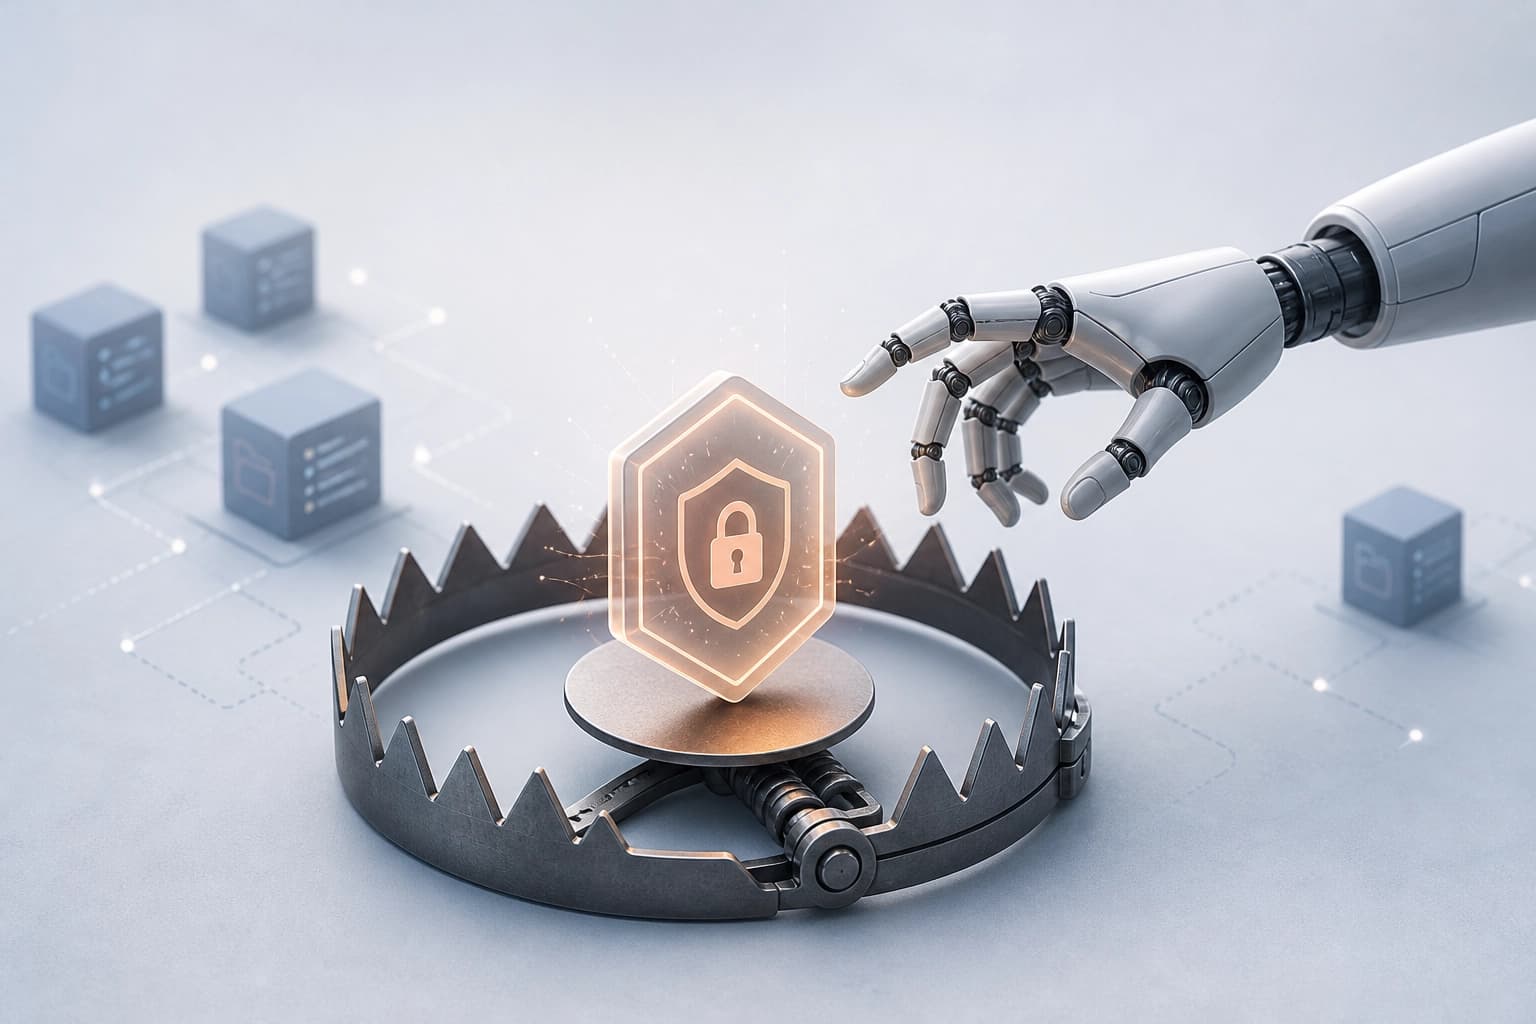
इस काम में एजेंट-आधारित दोष खोज की लागत संबंधी विषमता का विश्लेषण किया गया है: संस्करण बनाना सस्ता है, जबकि पहुँच-योग्यता विश्लेषण, निष्पादन और PoC के ज़रिए उनकी पुष्टि करने में अधिकांश बजट खर्च होता है। इसलिए सत्यापन को रक्षा का एक स्वतंत्र लक्ष्य बनाया जा सकता है। प्रस्तावित RedHerring—रिपॉज़िटरी के अनुरूप ढाली गई, सीलबंद प्रमाणपत्र वाली decoy—ने समान लागत पर 33 OSS-Fuzz परियोजनाओं में पाई गई वास्तविक कमज़ोरियों की संख्या 38.7–60.4% तक घटा दी; एजेंट को चेतावनी देने के बाद भी यह गिरावट 37.2% पर बनी रही।
परिकल्पनाओं की जाँच एक सीमित संसाधन के रूप में
स्वायत्त LLM एजेंट रिपॉज़िटरी स्तर पर कमज़ोरियों की खोज करते हैं। वे कई परिकल्पनाएँ पेश करते हैं। बजट सीमित होने पर एजेंट उनमें से केवल कुछ की ही जाँच करता है।
परिकल्पना की जाँच में कई चरण शामिल होते हैं:
- पहुँच-योग्यता का विश्लेषण;
- कोड का निष्पादन;
- proof-of-concept बनाना।
इन कार्रवाइयों की लागत परिकल्पना पेश करने की लागत से अधिक होती है। इसलिए कमज़ोरियों की खोज चुनिंदा जाँच की प्रक्रिया बन जाती है। जाँच की लागत एक अलग सुरक्षा सतह बनाती है।
व्यावहारिक मानदंड: सुरक्षा बजट का आकलन जनरेट की गई परिकल्पनाओं की संख्या से नहीं, बल्कि उम्मीदवारों की पुष्टि की लागत से करना चाहिए।
प्रमाणपत्र वाले ऑब्जेक्ट के रूप में चारा
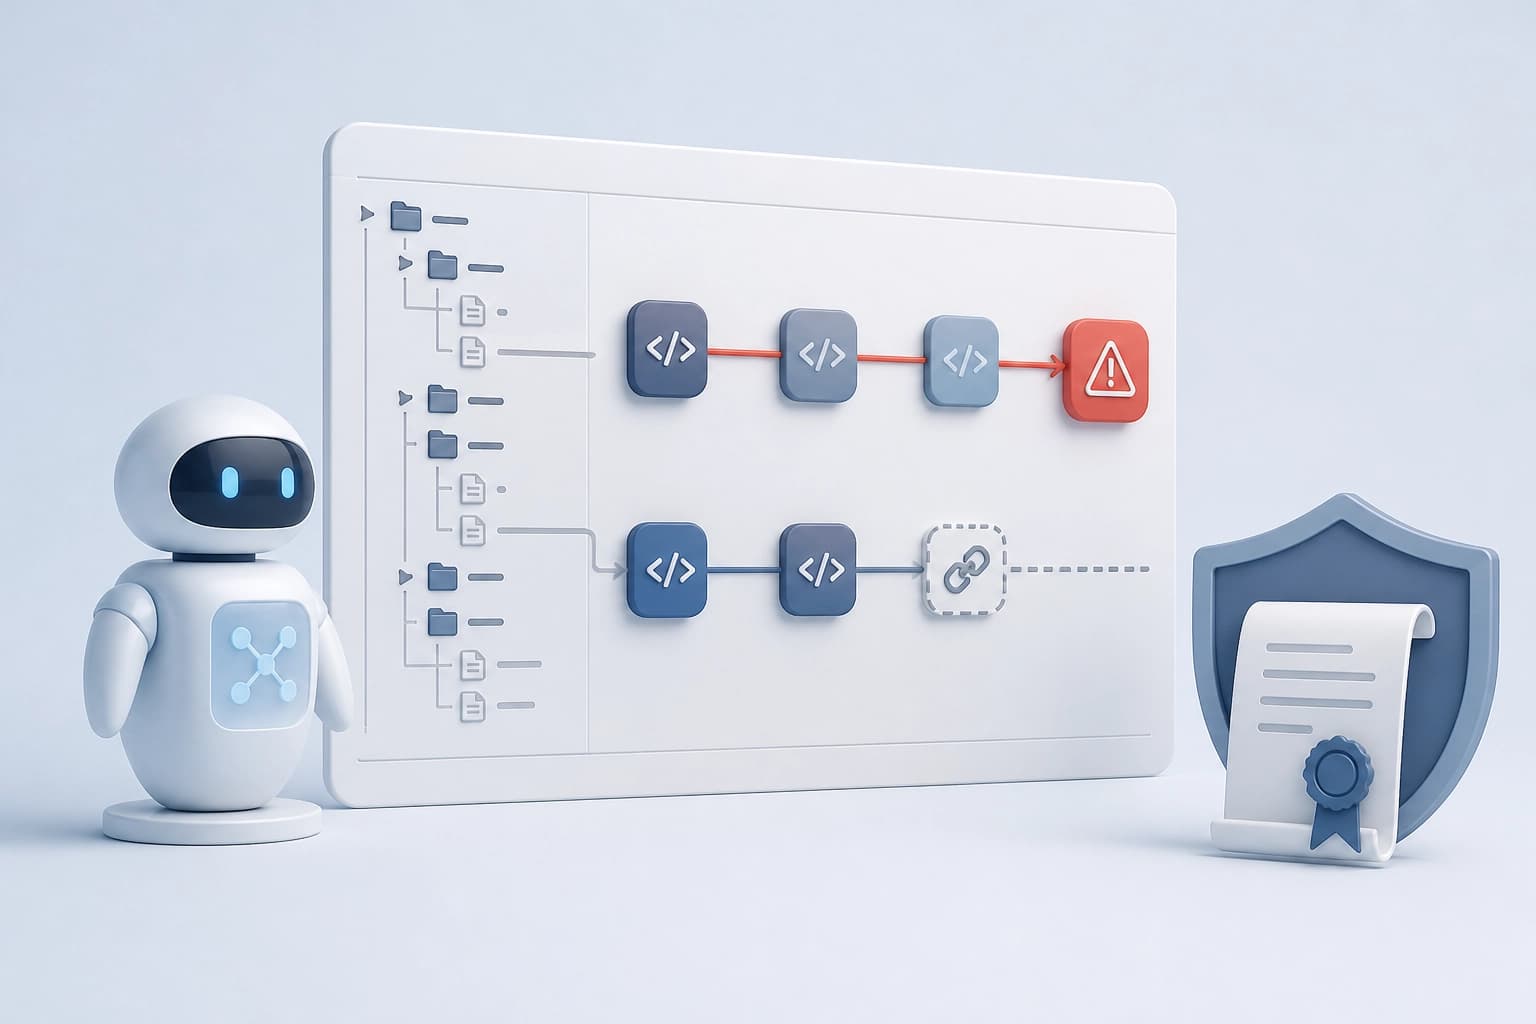
RedHerring प्रमाणित रूप से सुरक्षित चारे जोड़ता है। चारा जाँच के प्रयासों को वास्तविक कमज़ोरियों से हटाता है। हर चारे में दो तत्व होते हैं:
- CVE से निकाली गई कमज़ोरी की श्रृंखला; यह जाँच को आकर्षित करती है;
- एक झूठी कड़ी; इसकी वजह से खतरनाक sink पहुँच से बाहर रहता है।
एक गोपनीय प्रमाणपत्र से रक्षक इस गुण की कुशलतापूर्वक जाँच कर सकता है। प्रकाशित रिपॉज़िटरी के आधार पर इसी तथ्य को स्थापित करने के लिए एक गणनात्मक रूप से कठिन समस्या हल करनी पड़ती है।
| जाँच का कार्य | शर्त |
|---|---|
| रक्षक द्वारा पुष्टि | गोपनीय प्रमाणपत्र |
| प्रकाशित रिपॉज़िटरी के आधार पर इसी तथ्य को स्थापित करना | गणनात्मक रूप से कठिन समस्या का समाधान |
RedHerring हर चारे को लक्षित रिपॉज़िटरी के अनुसार ढालता है। चारा प्रोग्राम के सामान्य तर्क जैसा दिखता है।
व्यावहारिक मानदंड: चारा तब उपयुक्त है, जब रक्षक प्रमाणपत्र से उसकी सुरक्षा की पुष्टि कर सके और एजेंट को जाँच पर बजट खर्च करना पड़े।
परीक्षणों से क्या पता चला
परीक्षण 33 OSS-Fuzz प्रोजेक्ट, 70 मूल्यांकन उदाहरणों और पाँच मॉडलों पर किए गए। बजट समान थे।
| परीक्षण की शर्त | परिणाम |
|---|---|
| समान बजट, 33 OSS-Fuzz प्रोजेक्ट, 70 मूल्यांकन उदाहरण, पाँच मॉडल | मिली वास्तविक कमज़ोरियों में 38,7–60,4% की कमी |
| एजेंटों को चारे के बारे में स्पष्ट रूप से बताया गया | informed Baseline की तुलना में 37,2% की कमी |
ट्रैजेक्टरी के विश्लेषण से अतिरिक्त भार का पता चला:
- एजेंट 30,6–51,5% completion tokens चारे की जाँच पर खर्च करते हैं;
- अनुमान के अनुसार, निष्पादन समय का 32,5–49,9% इसी जाँच में जाता है।
सूचित एजेंटों ने अपनी खोज रणनीति को अनुकूलित किया। फिर भी RedHerring से मिली कमज़ोरियों की संख्या में कमी आई। लेखकों के अनुसार, इस तरीके की प्रभावशीलता चारे को गुप्त रखने पर निर्भर नहीं करती।
व्यावहारिक मानदंड: चारे का प्रभाव उनके उजागर होने पर भी बना रहता है, इसलिए सुरक्षा चारे की संरचना पर निर्भर करती है, उसे छिपाने पर नहीं।
रिपॉज़िटरी सुरक्षा में लागू करने के मानदंड
चारे लागू करते समय कई शर्तों की जाँच करनी चाहिए:
- उम्मीदवारों की पुष्टि को सुरक्षा के एक अलग संसाधन के रूप में गिना जाता है;
- चारे में CVE से निकाली गई कमज़ोरी की श्रृंखला होती है और यह जाँच को आकर्षित करती है;
- झूठी कड़ी खतरनाक sink को पहुँच से बाहर रखती है;
- रक्षक गुण की तेज़ी से जाँच करने के लिए गोपनीय प्रमाणपत्र रखता है;
- चारा लक्षित रिपॉज़िटरी के सामान्य तर्क के अनुसार ढाला गया है;
- चारे की जाँच में खर्च होने वाले completion tokens और निष्पादन समय के हिस्से को मापा जाता है;
- गोपनीयता को अनिवार्य शर्त नहीं माना जाता: सूचित एजेंट रणनीति बदलता है, लेकिन प्रभाव बना रहता है।
चयन का मानदंड: चारा तब उपयुक्त है, जब रक्षक प्रमाणपत्र से उसके गुण की तुरंत पुष्टि कर सके और एजेंट उसकी जाँच पर बजट खर्च करे। यदि चारा जाँच को आकर्षित नहीं करता या रक्षक उसकी तेज़ी से जाँच नहीं कर सकता, तो वह सुरक्षा की भूमिका नहीं निभाता।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
बिना फ़ाइन-ट्यूनिंग के स्रोतों के SQL व्यू के ज़रिए LLM के भ्रमों की जाँच
यह काम जाँचता है कि क्या LLM मतिभ्रम का पता लगाने के लिए बिना पर्यवेक्षण के स्रोत से जोड़ने हेतु एक बुनियादी प्रतीकात्मक कौशल—स्रोत दस्तावेज़ों के आधार पर SQL डेटाबेस बनाना—का उपयोग कर सकता है। RAGTruth और DiaHalu पर यह न्यूरो-सिम्बॉलिक पाइपलाइन सीधे भविष्यवाणी करने से अधिक सटीक साबित होती है और अत्याधुनिक तरीकों के बराबर प्रदर्शन करती है, जबकि इसके लिए डोमेन-विशिष्ट फ़ाइन-ट्यूनिंग की आवश्यकता नहीं होती।
9 नवम्बर 2026
MathAdv: मशीन-निर्मित प्रमाणों की अंतिम सटीकता के पीछे क्या छिपा है?
गणित के 13 स्नातक और स्नातकोत्तर विषयों के कार्यों का यह नैदानिक समूह Lean 4 में स्वचालित प्रमेय-प्रमाणन प्रणालियों का मूल्यांकन केवल अंतिम परिणाम के आधार पर नहीं, बल्कि विषय पर उनकी पकड़, अनौपचारिक तर्क की गुणवत्ता और शर्तों को नए शब्दों में प्रस्तुत किए जाने पर उनकी मजबूती के आधार पर भी करता है। घटक-वार विश्लेषण से पता चलता है कि किसी समस्या को औपचारिक रूप में बदलना अब भी सबसे बड़ी बाधा है, और सफलता गणित के क्षेत्र तथा समस्या को प्रस्तुत करने के तरीके पर बहुत अधिक निर्भर करती है।
9 नवम्बर 2026
AffordanceWAM: दृश्य पूर्वानुमान और मैनिपुलेटर नियंत्रण के बीच मध्यस्थ के रूप में अफ़ॉर्डेंस
यह कार्य एक जनरेटिव मॉडल का वर्णन करता है, जो मानव वीडियो का उपयोग करके बिना क्रिया एनोटेशन और रीटार्गेटिंग के अंतःक्रियाओं की विविधता बढ़ाते हुए, भविष्य के RGB अवलोकनों, स्केलर फ़ील्ड्स और अफ़ॉर्डेंस हीटमैप्स तथा रोबोट के सतत कमांड्स का एक साथ पूर्वानुमान लगाता है। RoboCasa, CALVIN ABC→D और वास्तविक दुनिया के कार्यों पर, यह दृष्टिकोण केवल-RGB और केवल-रोबोट डेटा वाले बेसलाइन की तुलना में लगातार बेहतर प्रदर्शन करता है।
9 नवम्बर 2026