
AffordanceWAM: दृश्य पूर्वानुमान और मैनिपुलेटर नियंत्रण के बीच मध्यस्थ के रूप में अफ़ॉर्डेंस
यह कार्य एक जनरेटिव मॉडल का वर्णन करता है, जो मानव वीडियो का उपयोग करके बिना क्रिया एनोटेशन और रीटार्गेटिंग के अंतःक्रियाओं की विविधता बढ़ाते हुए, भविष्य के RGB अवलोकनों, स्केलर फ़ील्ड्स और अफ़ॉर्डेंस हीटमैप्स तथा रोबोट के सतत कमांड्स का एक साथ पूर्वानुमान लगाता है। RoboCasa, CALVIN ABC→D और वास्तविक दुनिया के कार्यों पर, यह दृष्टिकोण केवल-RGB और केवल-रोबोट डेटा वाले बेसलाइन की तुलना में लगातार बेहतर प्रदर्शन करता है।
यह मॉडल क्या है
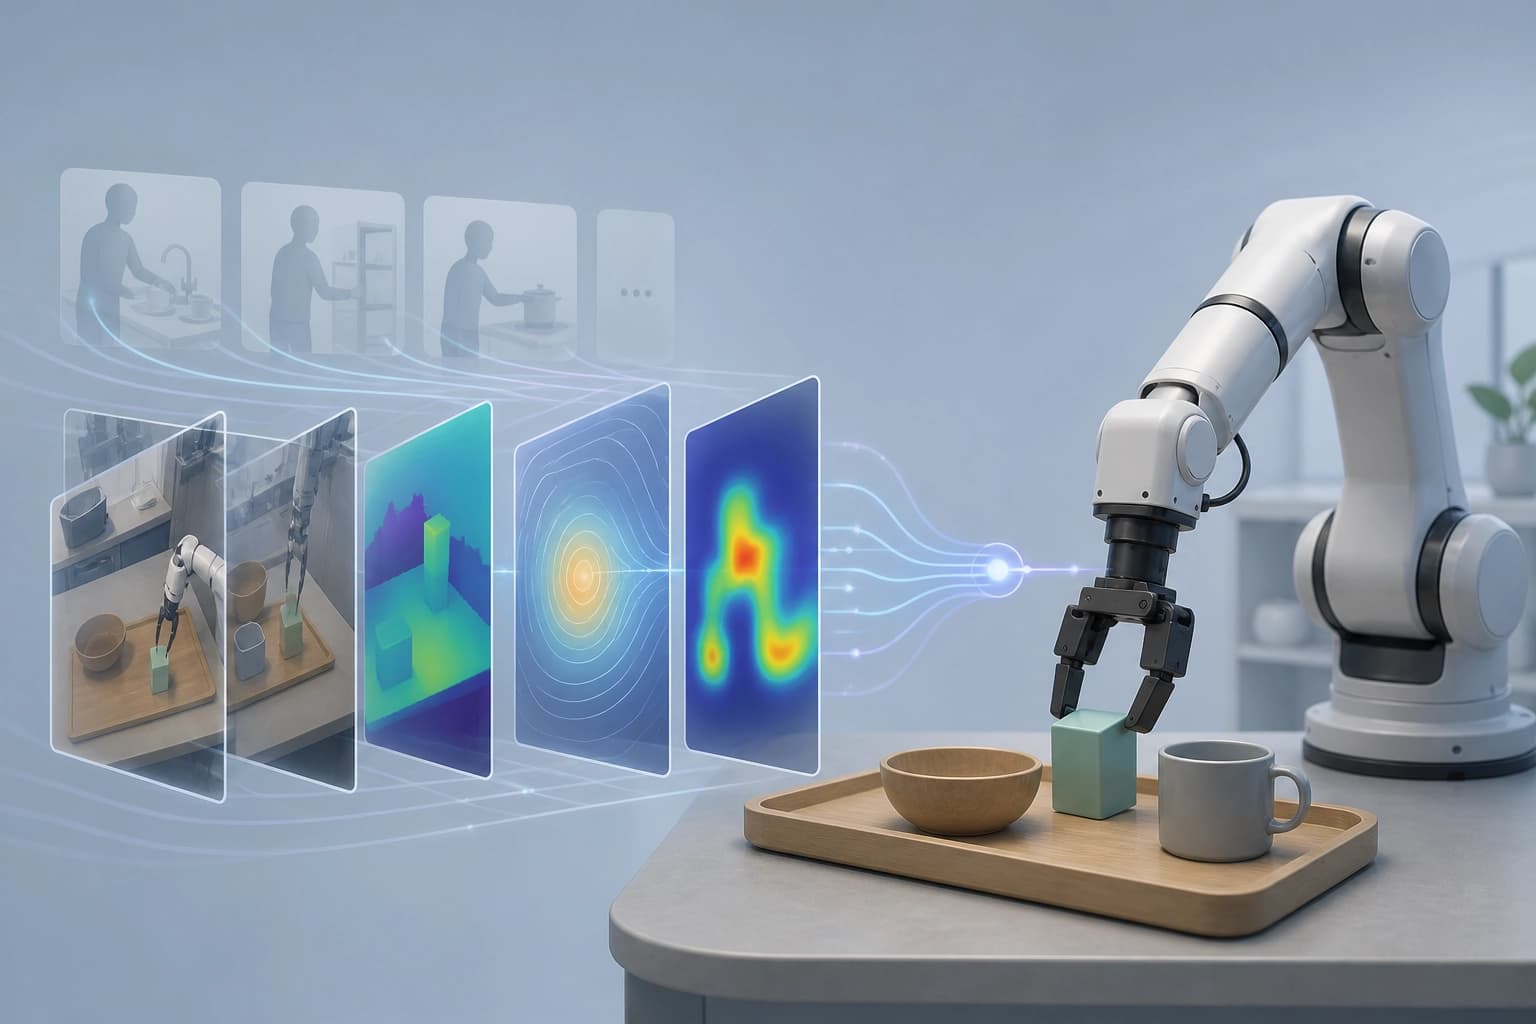
arXiv लेख: 2609.22332 में AffordanceWAM प्रस्तुत किया गया है—रोबोटिक मैनिपुलेशन के लिए अफोर्डेंस-जागरूक जनरेटिव World Action Model। इसका पहला संस्करण 16 Sep 2026 को प्रस्तुत किया गया था। दिया गया नवीनतम संस्करण v3 है, जिसे 18 Oct 2026 को संशोधित किया गया। यह वस्तु-केंद्रित स्थानिक-कालिक अफोर्डेंस का निरूपण करता है। यह दो प्रारूपों का उपयोग करता है:
- Scalar Affordance;
- Affordance Heatmap.
ये निरूपण जनरेट किए गए भावी World के भीतर होते हैं। अफोर्डेंस दृश्य पूर्वानुमान को कार्य-संबंधी वस्तुओं और अंतःक्रिया क्षेत्रों से जोड़ते हैं। वे मानव और रोबोट के वीडियो में अंतःक्रियाओं के लिए एक साझा आधार के रूप में काम करते हैं। इस तरह, अफोर्डेंस दृश्य के पूर्वानुमान और मैनिपुलेटर के नियंत्रण के बीच मध्यस्थ बन जाते हैं।
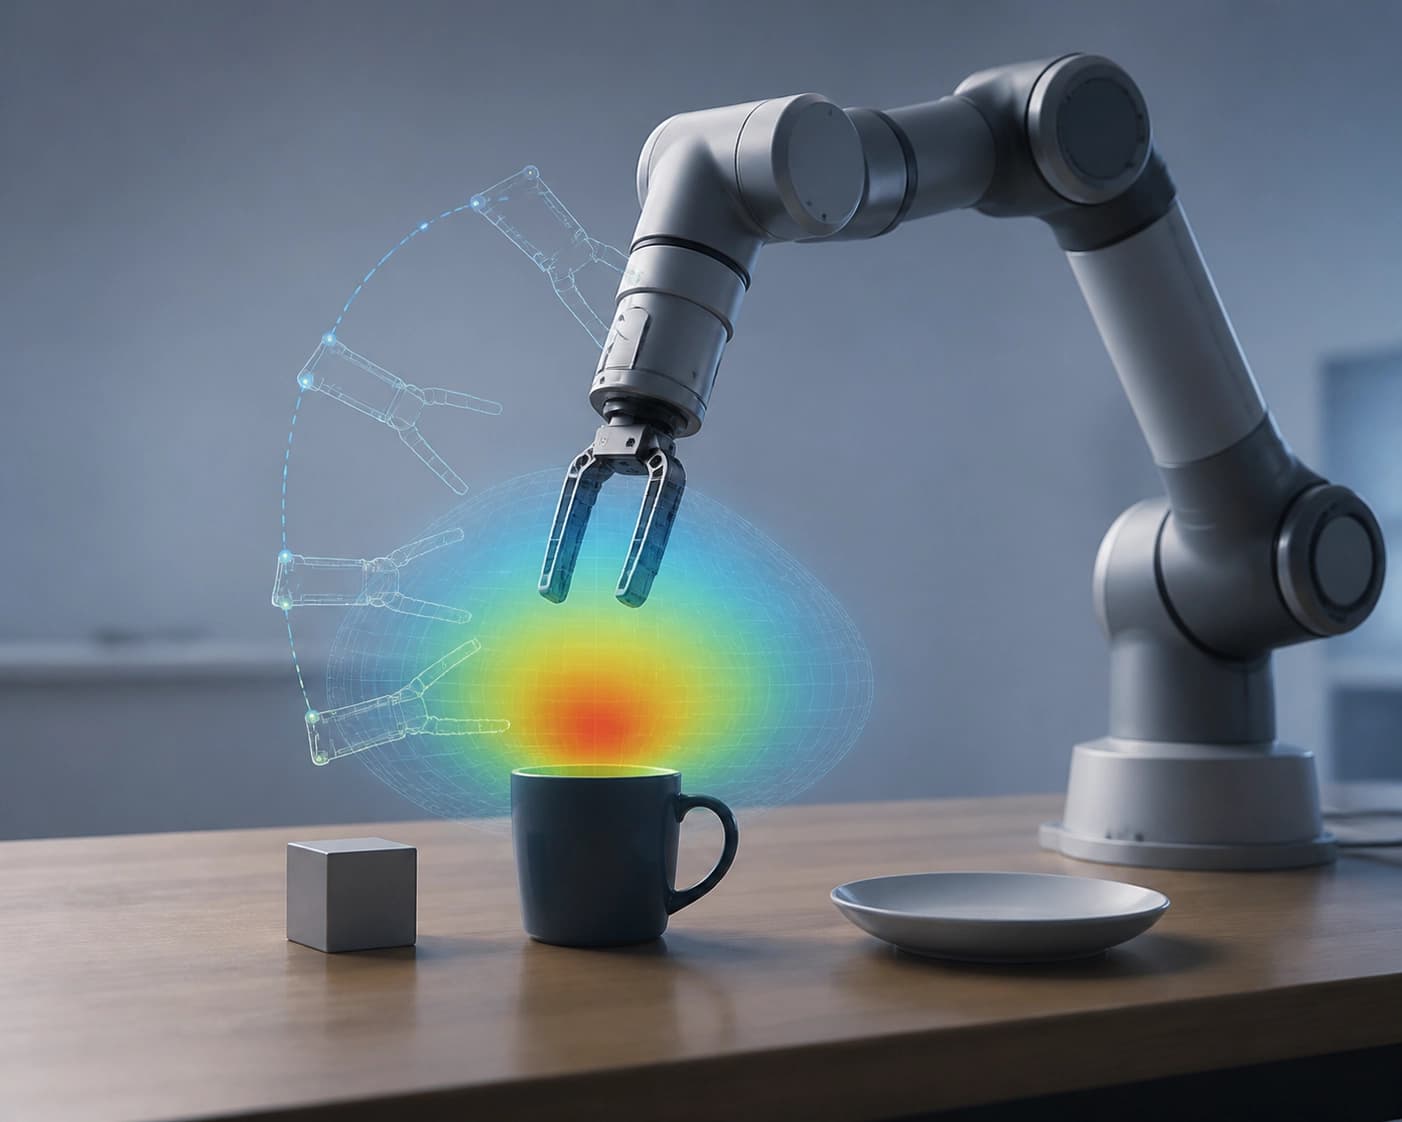
निष्कर्ष: मॉडल वस्तुओं और क्रिया क्षेत्रों के लिए एक स्पष्ट प्रारूप प्रदान करता है। यह प्रारूप भविष्य के पूर्वानुमान को नियंत्रण से जोड़ता है।
आर्किटेक्चर: दो विशेषज्ञ और एक साझा उद्देश्य
AffordanceWAM की नींव में पहले से प्रशिक्षित video diffusion Transformer है। मॉडल अलग-अलग पैरामीटर वाले World Expert और Action Expert का उपयोग करता है। इन्हें Masked Joint Self-Attention जोड़ता है।
| घटक | लेख में वर्णित भूमिका |
|---|---|
| World Expert | अलग-अलग पैरामीटर वाला विश्व विशेषज्ञ |
| Action Expert | अलग-अलग पैरामीटर वाला क्रिया विशेषज्ञ |
| Masked Joint Self-Attention | World Expert और Action Expert को जोड़ता है |
| साझा flow-matching objective | RGB, अफोर्डेंस और क्रियाओं के पूर्वानुमान को एक करता है |
मॉडल भावी RGB अवलोकनों, Scalar Affordance fields, Affordance Heatmaps और रोबोट की सतत क्रियाओं का संयुक्त पूर्वानुमान करता है। इन सभी आउटपुट को एक साझा flow-matching objective एक करता है। विशेषज्ञों के अलग-अलग पैरामीटर संयुक्त प्रशिक्षण में बाधा नहीं डालते। उनका आपसी जुड़ाव विश्व और क्रिया के संयुक्त पूर्वानुमान को सहारा देता है।
निष्कर्ष: आर्किटेक्चर विश्व और क्रियाओं के पैरामीटर अलग रखता है। साथ ही, Masked Joint Self-Attention और साझा उद्देश्य संयुक्त पूर्वानुमान को बनाए रखते हैं।
मानव वीडियो और रोबोट प्रक्षेप-पथों पर प्रशिक्षण
AffordanceWAM के प्रशिक्षण में भावी World के तीनों प्रवाहों के लिए मानव वीडियो का उपयोग होता है। रोबोट के प्रक्षेप-पथ अतिरिक्त रूप से क्रिया का पर्यवेक्षण प्रदान करते हैं। इस हस्तांतरण के लिए मानव क्रियाओं के लेबल या रीटार्गेटिंग की आवश्यकता नहीं होती।
| डेटा स्रोत | प्रशिक्षण में योगदान |
|---|---|
| मानव वीडियो | भावी World के तीनों प्रवाहों को प्रशिक्षित करता है |
| रोबोट के प्रक्षेप-पथ | अतिरिक्त रूप से क्रिया का पर्यवेक्षण प्रदान करते हैं |
अफोर्डेंस मानव और रोबोट के वीडियो में अंतःक्रियाओं के लिए साझा आधार के रूप में काम करते हैं। इसलिए मानव वीडियो का उपयोग मानव क्रियाओं के लेबल के बिना किया जा सकता है। लेखक अफोर्डेंस को vision-language-action और मानव से रोबोट तक कौशल हस्तांतरण के लिए एक प्रभावी इंटरफ़ेस बताते हैं।
निष्कर्ष: अफोर्डेंस मानव और रोबोट के वीडियो के लिए साझा इंटरफ़ेस प्रदान करते हैं। इससे मानव क्रियाओं के लेबल और रीटार्गेटिंग की आवश्यकता नहीं रहती।
प्रयोग: प्रदर्शन में बढ़त और डेटा पर निर्भरता
लेखकों ने AffordanceWAM का मूल्यांकन RoboCasa, CALVIN ABC→D और वास्तविक दुनिया के मैनिपुलेशन में किया। प्रयोगों में आधारभूत विधियों की तुलना में लगातार प्रदर्शन में बढ़त दिखती है। आधारभूत विधियाँ केवल RGB या केवल रोबोट डेटा का उपयोग करती हैं।
RoboCasa पर, अफोर्डेंस के साथ एनोटेट किए गए मानव वीडियो की मात्रा बढ़ने पर परिणाम में लगातार सुधार होता है। ऐसा रोबोट पर्यवेक्षण की मात्रा स्थिर रखने पर होता है। यह प्रभाव प्रशिक्षण में अफोर्डेंस के योगदान को दर्शाता है।
| स्थिति | लेख के अनुसार परिणाम |
|---|---|
| केवल RGB पर आधारित आधार | AffordanceWAM में लगातार प्रदर्शन-वृद्धि |
| केवल रोबोट डेटा पर आधारित आधार | AffordanceWAM में लगातार प्रदर्शन-वृद्धि |
| रोबोट पर्यवेक्षण स्थिर रखते हुए अफोर्डेंस वाले अधिक मानव वीडियो | RoboCasa पर लगातार सुधार |
चयन का व्यावहारिक मानदंड अफोर्डेंस एनोटेशन वाले मानव वीडियो की मात्रा है। रोबोट पर्यवेक्षण स्थिर रखने पर, इस मात्रा में वृद्धि से RoboCasa पर लगातार सुधार होता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
MathAdv: मशीन-निर्मित प्रमाणों की अंतिम सटीकता के पीछे क्या छिपा है?
गणित के 13 स्नातक और स्नातकोत्तर विषयों के कार्यों का यह नैदानिक समूह Lean 4 में स्वचालित प्रमेय-प्रमाणन प्रणालियों का मूल्यांकन केवल अंतिम परिणाम के आधार पर नहीं, बल्कि विषय पर उनकी पकड़, अनौपचारिक तर्क की गुणवत्ता और शर्तों को नए शब्दों में प्रस्तुत किए जाने पर उनकी मजबूती के आधार पर भी करता है। घटक-वार विश्लेषण से पता चलता है कि किसी समस्या को औपचारिक रूप में बदलना अब भी सबसे बड़ी बाधा है, और सफलता गणित के क्षेत्र तथा समस्या को प्रस्तुत करने के तरीके पर बहुत अधिक निर्भर करती है।
9 नवम्बर 2026
प्रेज़ेंटेशन संपादन को नियंत्रित संचालन के रूप में: EditPPT फ़्रेमवर्क और DeckEdit-Bench बेंचमार्क
लेखक स्लाइड संपादन को विशिष्ट ऑब्जेक्ट, अनुमत कार्रवाइयों और इस जाँच में बाँटते हैं कि असंबंधित सामग्री अछूती रही है, न कि कोड के मुक्त रूप से निर्माण में। गुणवत्ता मापने के लिए DeckEdit-Bench बनाया गया (28 मानव-निर्मित प्रस्तुतियों पर 183 कार्य), और पाँच आधारभूत मॉडलों पर बहु-एजेंट प्रणाली EditPPT, 97% से अधिक सामग्री सुरक्षित रखते हुए 66.7–74.9% कार्यों में सफल होती है।
8 नवम्बर 2026
कारकों की गैर-यूक्लिडीय ज्यामिति: निरूपणों के पृथक्करण के लिए FactoMap मानचित्र
कारकों के स्थान का वर्णन क्षेत्रों, जनरेटर द्वारा निर्धारित समतुल्यताओं और स्थानीय पैमानों के माध्यम से करने की एक विधि प्रस्तावित की गई है। इससे उन मामलों में अंतर करना संभव होता है जो टोपोलॉजिकल रूप से निकट हैं, लेकिन जिनकी ज्यामिति अलग-अलग है। FactoMap विधि एक संरचित जाल पर व्याख्या योग्य प्रोटोटाइपों को प्रशिक्षित करती है और प्रयोगों में कारकों की निरंतरता तथा उनके पृथक्करण को अधिक स्थिरता से बनाए रखने का प्रदर्शन करती है।
8 नवम्बर 2026