
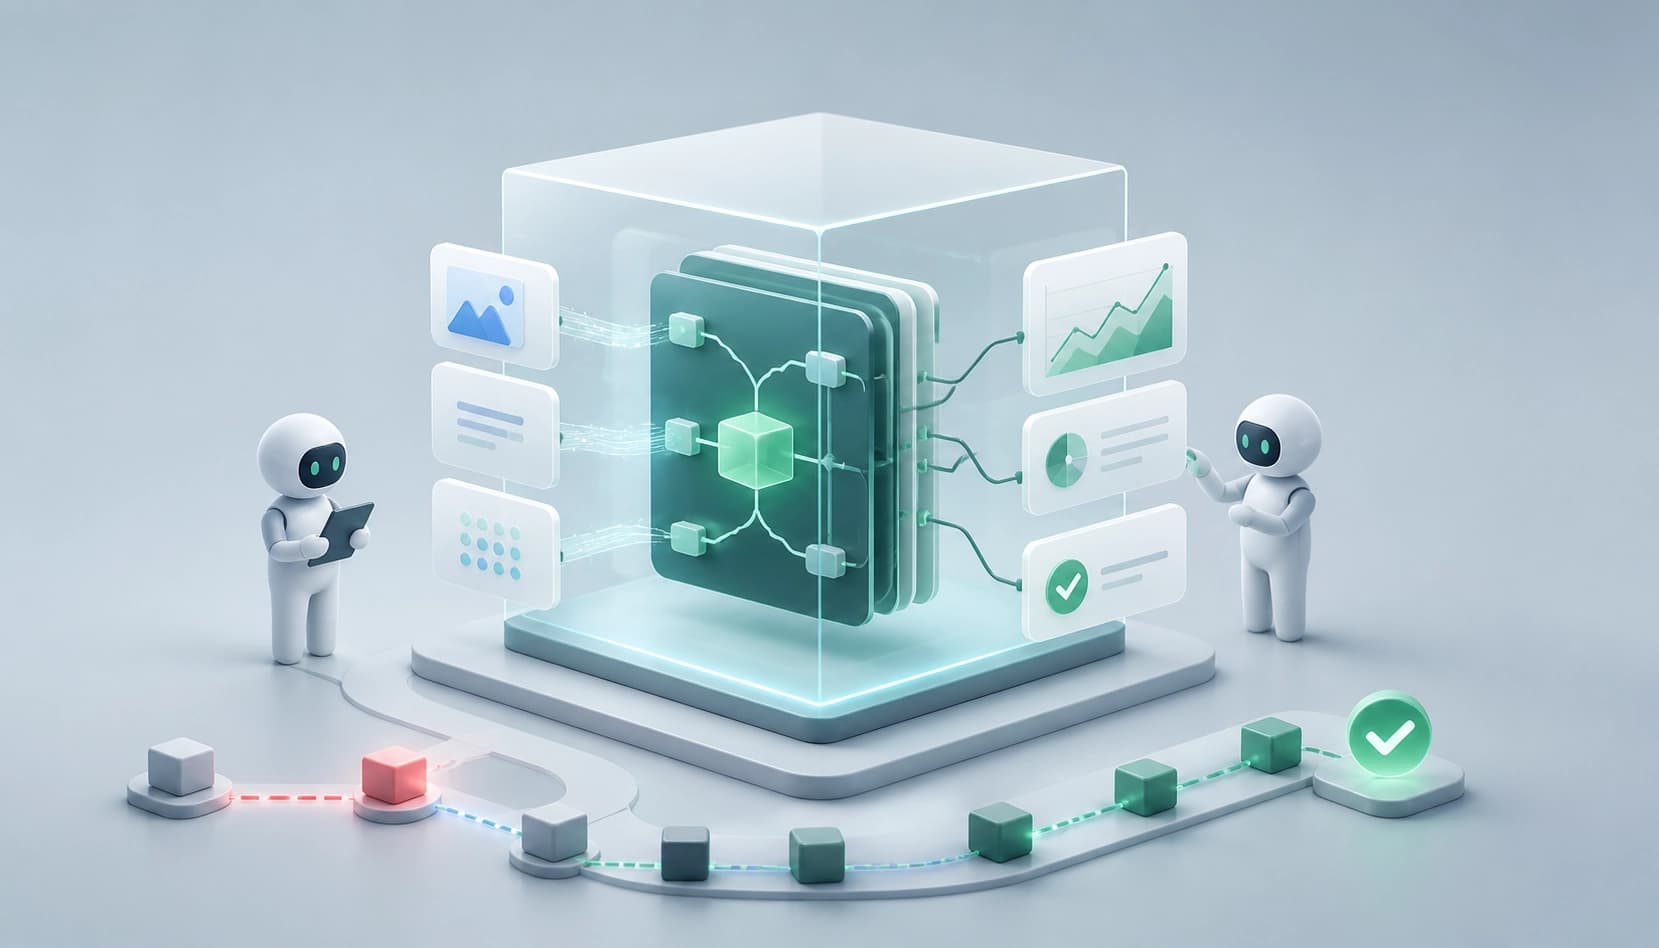
हरा टेस्ट रन अभी प्रमाण नहीं है
सहज बुद्धि एक सीधी बात कहती है: अगर पूरा टेस्ट सेट पास हो गया, तो काम हो गया। एक ताज़ा प्रीप्रिंट इस सहज बुद्धि को एक छोटे, लगभग खिलौने जैसे उदाहरण पर तोड़ देता है। दो एजेंटों को ऐप दोबारा बनाने का एक ही काम दिया गया। पहले ने अनुशासन से प्रक्रिया के नियमों का पालन किया — और वह टेस्ट फेल कर दिया जिसे बचाकर रखा गया था और काम के दौरान दिखाया नहीं गया। दूसरे ने नियमों को नज़रअंदाज़ किया, लेकिन दिखने वाले सारे चेक बिना एक भी गलती के पास कर लिए।
नतीजा अप्रिय है, पर उपयोगी: टेस्ट सेट ऐप की सत्यता का नहीं, बल्कि उस सीमा का बखान करता है जिसे चकमा दिया जा सका। जब जाँच और कार्यान्वयन एक ही विवरण से उगते हैं, तो एजेंट को कुछ नहीं रोकता कि वह कोड को असली काम के बजाय जाँच की अपेक्षाओं के हिसाब से ढाल दे। ऐसी स्थिति में हरा स्कोरबोर्ड सिस्टम की खुद के बारे में खुद दी गई रिपोर्ट है, स्वतंत्र माप नहीं।
इसलिए लेखक का ध्यान केंद्र बदल जाता है: बात मॉडल के लिए और होशियार निर्देश लिखने की नहीं, बल्कि यह है कि कुछ दावे मशीन से जाँचने योग्य बनें, यानी ऐसे जिन्हें बहला-फुसला कर पार न किया जा सके।
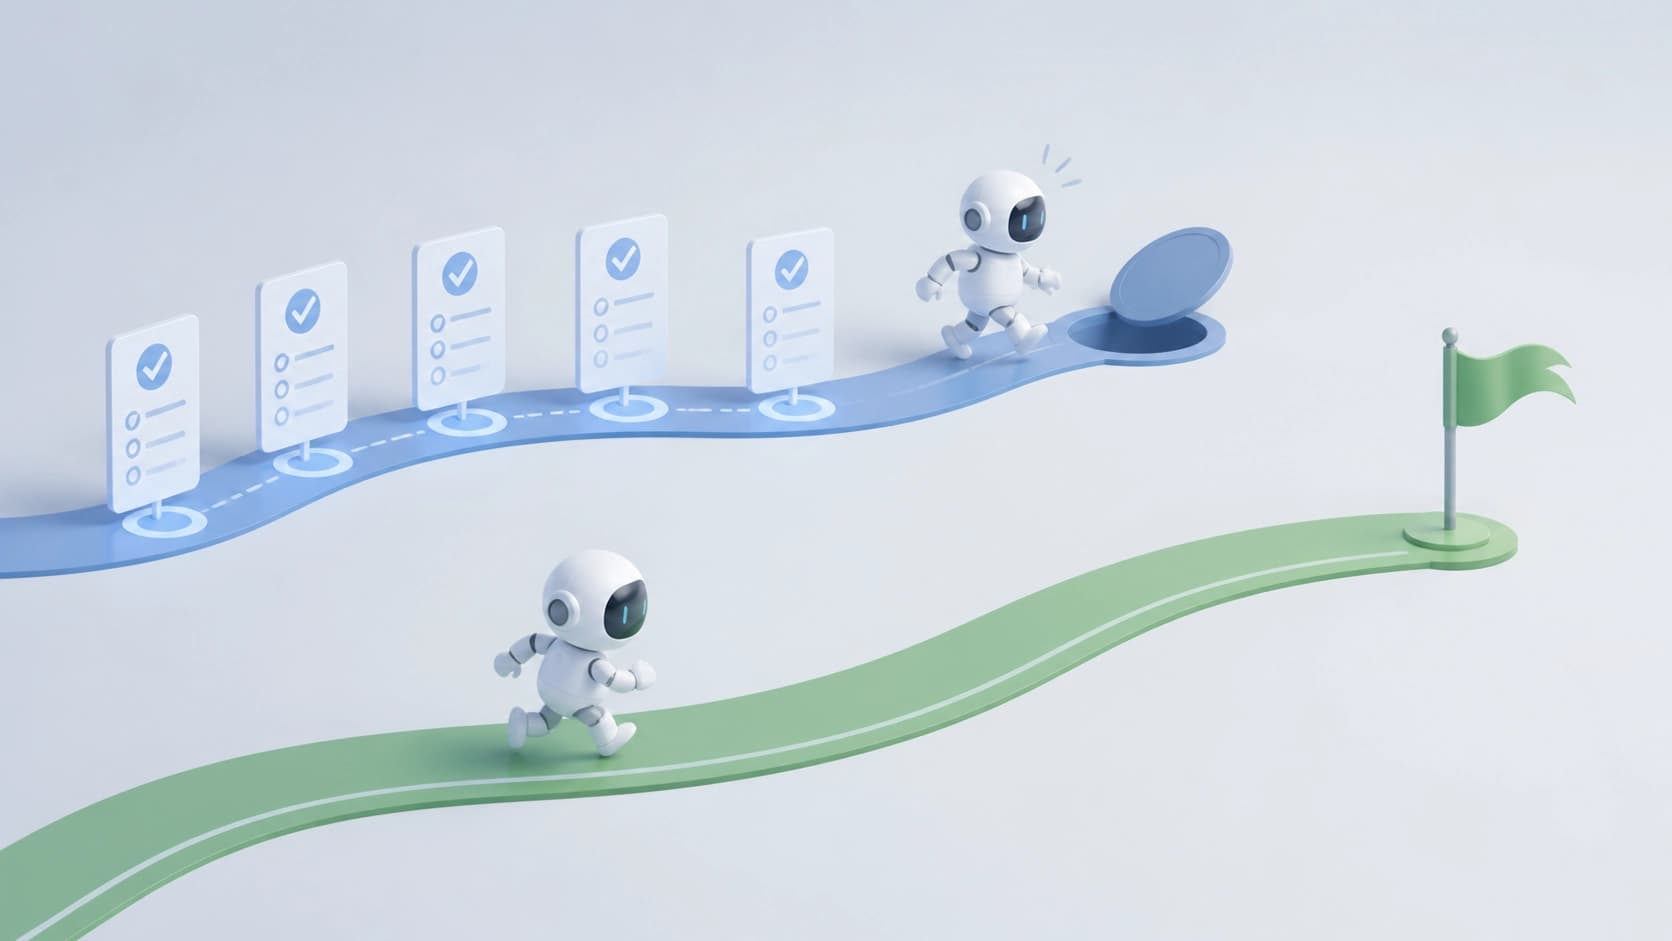
इंटरफ़ेस पहला कोड लिखे जाने से पहले तय हो जाता है
शुरुआती बिंदु पुराने शोधों का एक अवलोकन है: जैसे ही मॉडल काफ़ी मज़बूत हो जाता है, दोबारा बनाने की जटिल बहु-एजेंट पाइपलाइन सबसे साधारण परिदृश्य से हारने लगती है। मॉडल को सोर्स कोड और एक निर्देश देना ही काफ़ी होता है — AgentModernize का तरीका लगभग ऐसा ही है — और नतीजा भूमिकाओं, समीक्षकों और बीच के चरणों वाली योजना से बुरा नहीं, बल्कि कभी-कभी बेहतर निकलता है।
लेखक का जवाब है rebuild-dossier टूल। इसका तर्क यह है: पहले ऐप का असली इंटरफ़ेस तय करो, यानी उसके सटीक इनपुट और आउटपुट, और उसके बाद ही कोड लिखने की इजाज़त दो। बिल्ड एक बार में एक टेस्ट के हिसाब से चलता है, और हर कदम स्वचालित जाँचों से गुज़रता है, न कि "यह जाँचना मत भूलना कि…" जैसी लिखित समझौतों से।
फ़र्क़ बुनियादी है। प्रॉम्प्ट में दिया निर्देश एक विनती है। सिग्नेचर और नतीजों का मिलान करने वाली स्क्रिप्ट एक बाधा है। विनती तोड़ी जा सकती है, बिना यह पता भी चले; बाधा या तो पास होती है या नहीं, और यह बाहर से दिखता है।
यहाँ एक ऐसी बात है जिसे चूकना आसान है: सिर्फ़ इंटरफ़ेस तय करने का अलग असर लेखकों ने नहीं मापा — इस तत्व की जाँच अलग से हुई और तुलना में शामिल नहीं था। तो "कॉन्ट्रैक्ट तय कर लो, सब चल पड़ेगा" वाला निष्कर्ष इस काम से नहीं निकलता।
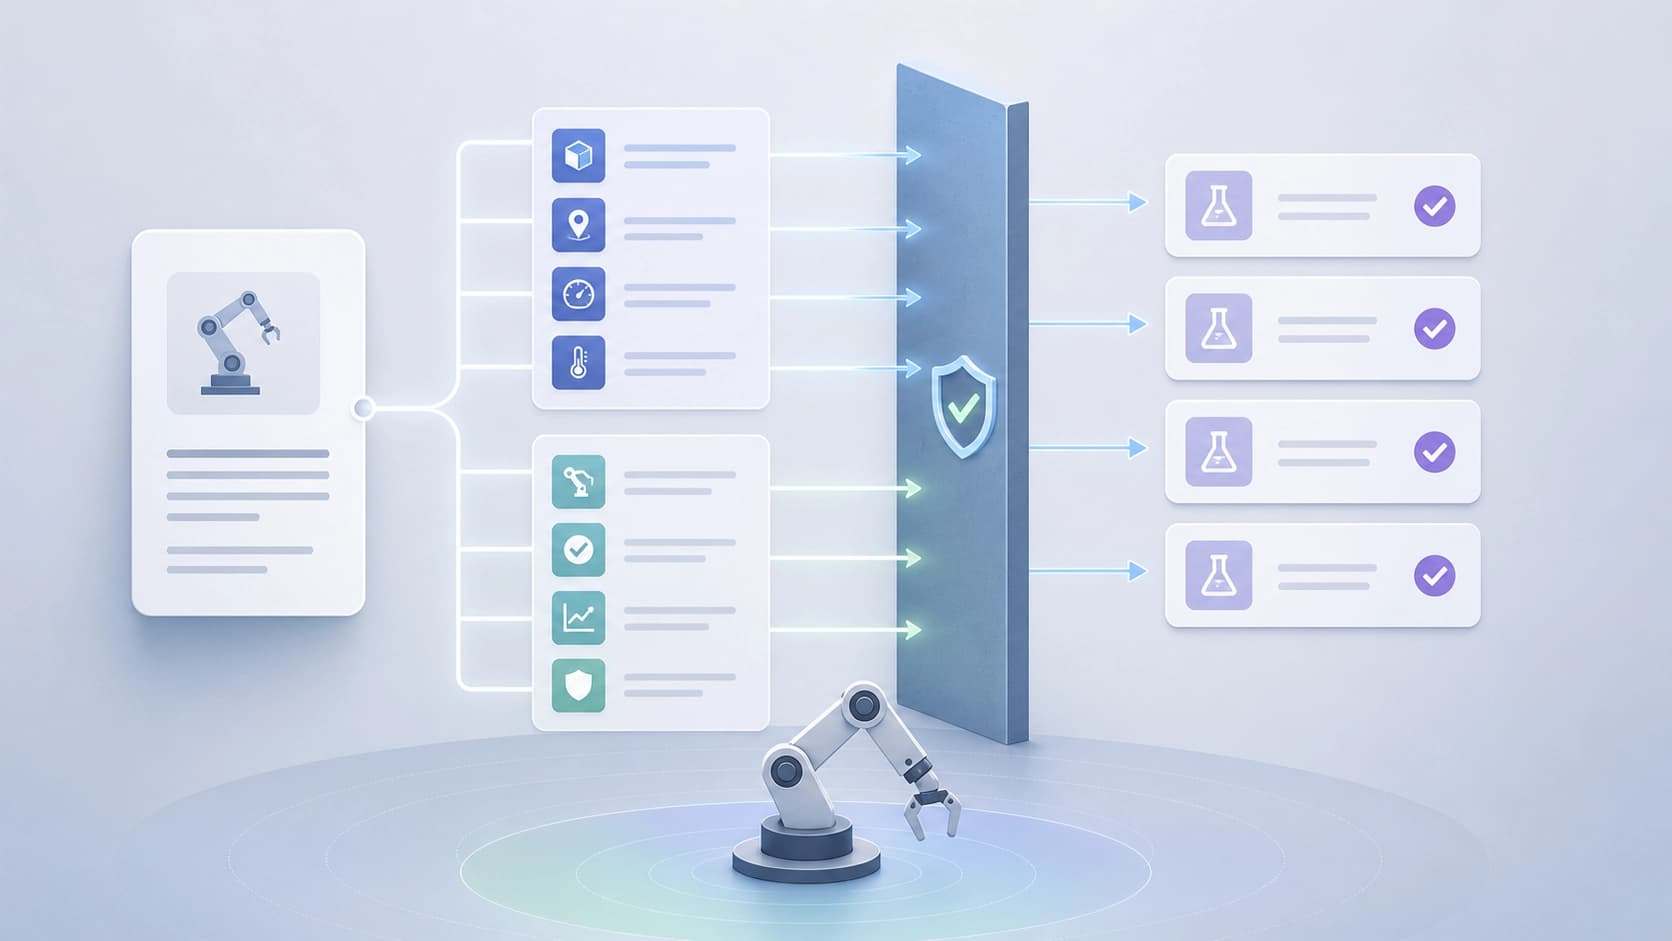
एजेंट की एक रिपोर्ट के बजाय जाँच के तीन स्तर
काम का सबसे व्यावहारिक हिस्सा एजेंट आर्किटेक्चर के बारे में नहीं, बल्कि यह है कि तथ्यों को कैसे प्रमाणित किया जाए। दोबारा बनाने की प्रगति के हर दावे का मिलान एक साथ तीन जगहों से होता है: एजेंट ने अपने काम के बारे में खुद क्या लिखा, स्वचालित लॉग ने क्या दर्ज किया, और रन के बाद फ़ाइल सिस्टम में असल में क्या आया।
हर स्तर का अपना अंधा कोना है। एजेंट रिपोर्ट में गलती कर सकता है, या सजा-सँवार भी सकता है। लॉग घटनाएँ दर्ज करता है, पर यह उस पर निर्भर है कि लॉग करने का फ़ैसला ही क्या हुआ। फ़ाइलों की सूची झूठ नहीं बोलती, पर बदलावों के मतलब पर चुप रहती है। तीनों तस्वीरों के बीच का अंतर ही वह संकेत है जिसके लिए यह सब किया गया।
यह सैद्धांतिक एहतियात नहीं है: मिलान ने असली खोट निकाले, जिनमें खुद लेखकों के लिखे लॉगिंग कोड में एक बग भी शामिल था। एक ही स्तर — मान लीजिए, लॉग पर बिना शर्त भरोसा — इस गलती को भाँप ही नहीं पाता। सबक किसी भी एजेंट पाइपलाइन पर लागू होता है: अगर आपके पास निरीक्षण का एक ही चैनल है, तो आप सबसे पहले अपनी ही गलती माप रहे हैं।
कमज़ोर मॉडल और बड़ा ऐप: कहाँ ठोकर खाती है यह बनावट
दूसरा सवाल यह था: क्या यह पूरा तंत्र बेसलाइन की तुलना में फ़ायदा देता है — यानी कमज़ोर मॉडल को सोर्स और एक निर्देश देना? छोटे ऐप पर बराबरी रही। बड़े ऐप पर साफ़ हार हुई, और वहाँ स्वचालित जाँच चली ही नहीं। यानी वही नियंत्रण-चक्र लड़खड़ा गया जिसे बढ़त देनी थी।
इसे ऐसे पढ़ा जा सकता है: फ़र्क़ इंटरफ़ेस तय करने से नहीं, बल्कि जाँचने वाले तंत्र से पड़ता है, जो इस रन में काम ही नहीं आया। जितना बड़ा प्रोजेक्ट होगा और जितना कम भरोसा रहेगा कि ऑटोमेशन वैसे ही चलेगा जैसा सोचा गया, उतनी ही सावधानी से "प्रक्रिया सब ठीक कर देगी" जैसे वादों को लेना चाहिए।
एक अलग कहानी है पोर्टेबिलिटी। जोखिम दूसरे मॉडल और दूसरी टूल-चेन पर दोहराए जाते हैं: ज़्यादा मज़बूत मॉडल ने प्रक्रिया लगातार तीन बार पूरी की, कमज़ोर ने एक बार भी नहीं। "कोई भी उपलब्ध मॉडल ले लो और वही पाइपलाइन चला दो" वाले विचार के लिए यह बुरी ख़बर है: प्रक्रिया का अनुशासन खुद मॉडल की क्षमता का फ़ंक्शन निकलता है, निर्देश का गुण नहीं।
इससे व्यवहार में क्या निकलता है
- हरे टेस्ट को प्रमाण मत मानिए। पहले पूछिए कि ये टेस्ट किसने लिखे और क्या इन्हें सारतः कुछ तोड़े बिना चकमा दिया जा सकता है।
- एक बचाया हुआ चेक सेट रखिए। कुछ टेस्ट एजेंट के लिए काम के दौरान उपलब्ध नहीं होने चाहिए — वरना वह ठीक उन्हीं के हिसाब से ऑप्टिमाइज़ करेगा।
- कॉन्ट्रैक्ट को अलग आर्टिफ़ैक्ट में रखिए। इनपुट और आउटपुट कोड से पहले, न कि काम के बीच टिप्पणियों में। पर याद रखिए कि सिर्फ़ यह कदम जीत के लिए काफ़ी न भी हो।
- एक कदम पर एक टेस्ट। छोटी कटाई विफलता को स्थानीय और समझने योग्य बनाती है।
- कम से कम तीन स्रोत मिलाइए: एजेंट की रिपोर्ट, मशीन लॉग, फ़ाइलों की वास्तविक स्थिति। मेल से ज़्यादा मायने अंतर रखता है।
- दूसरे मॉडल और दूसरे टूलिंग पर जाँचिए। अगर प्रक्रिया सिर्फ़ सबसे मज़बूत मॉडल पर टिकी है, तो वह प्रक्रिया नहीं, उसका गुण है।
- प्रमाण का वज़न अलग-अलग समझिए। काम में तीन नतीजे असमान रूप से पुष्ट हैं: कहीं छोटी तुलना, कहीं अवलोकन। एक कामयाब प्रदर्शन को उद्योग-मानक मत बना दीजिए।
यह काम क्या है और इस पर कितना भरोसा करें
बात प्रीप्रिंट «Rebuild Dossier: Mechanically-Enforced Specs for Agentic App Rebuilds, and What Model-Tier Failures Reveal» (arXiv:2608.23616, सेक्शन cs.SE) की है: 22 अगस्त 2026 का v1, और 26 अगस्त का v2। लेखक — Parker Fawcett। आकार — 48 पेज, एक चित्र। टूल MIT लाइसेंस के तहत खुला है और लेखकों के अपने ऐप्स पर end-to-end दोहराया जा सकता है; कोड और मूल्यांकन आर्टिफ़ैक्ट अलग से, अपने DOI के साथ रखे गए हैं।
यहाँ असली कीमत किसी तैयार नुस्ख़े में नहीं, बल्कि इस ईमानदार प्रदर्शन में है कि "हरा" नतीजा ठीक कैसे धोखा देता है और अंतर पकड़ने के लिए जाँच की कितनी परतें चाहिए। सीमाएँ भी सीधे बताई गई हैं: संक्षिप्त तुलनाएँ, तीन नतीजों का असमान वज़न, मॉडल की ताक़त पर प्रक्रिया-अनुशासन की निर्भरता। इसे जाँचने योग्य परिकल्पनाओं के एक सेट और एक उपयोगी टूल की तरह पढ़ना चाहिए, न कि एजेंटों द्वारा ऐप दोबारा बनाने की अंतिम कार्यप्रणाली की तरह।


